AI 語音、音樂與即時對話
Mistral 出 Voxtral 3 語音 Agent:50+ 語言即時對話,可 EU 託管亦可以自行部署
Mistral 喺 2026 年 10 月 20 日推出 Voxtral 3 語音模型系列同 voice agent SDK,主打聽、想、調工具、開口四個環節串成實時流程。

Mistral 喺 2026 年 10 月 20 日推出 Voxtral 3 語音模型系列同 voice agent SDK,主打聽、想、調工具、開口四個環節串成實時流程。
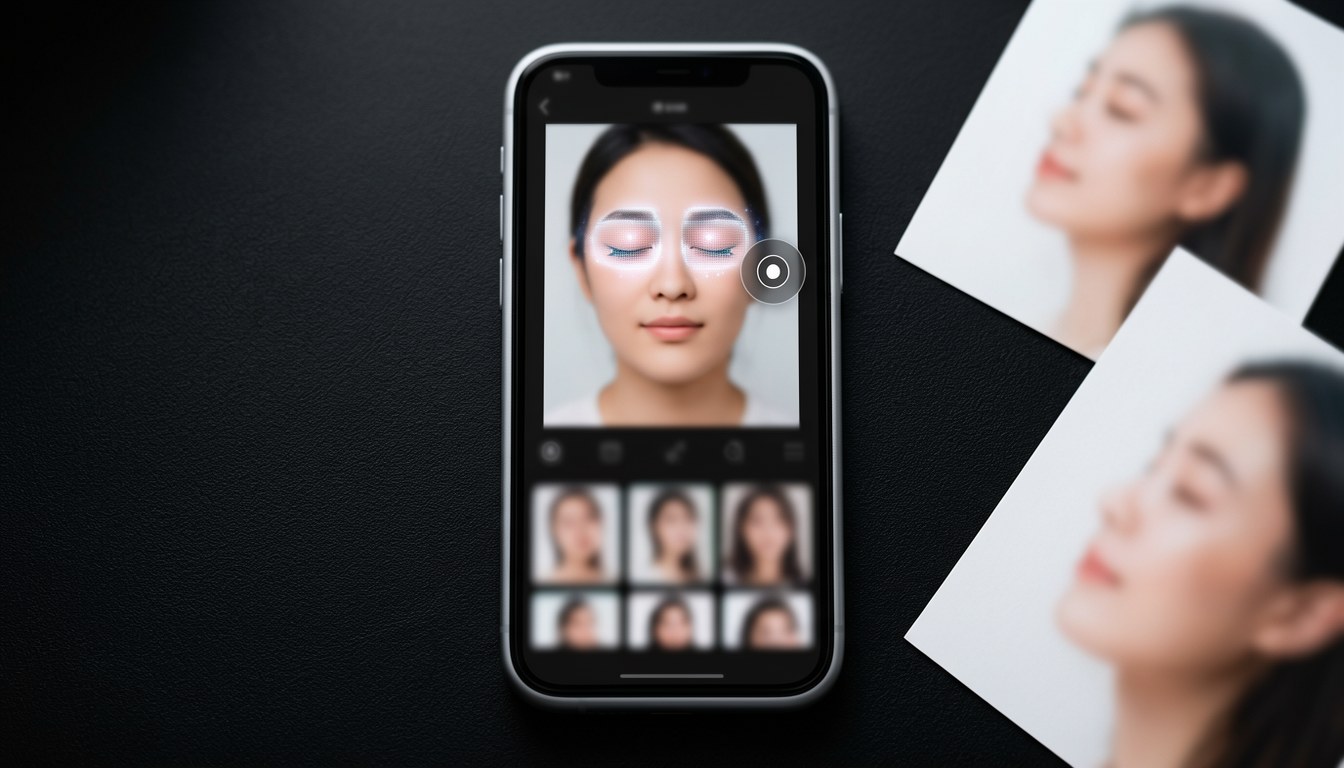
Adobe 話咗聲,Lightroom 手機版可以用生成式 AI 一鍵幫相中人「開眼」。免費版試兩次就要訂閲 Creative Cloud,而 Adobe 話會用你圖庫入面同一個人嘅相片當參考。
ALS 病人 Jules Rodriguez 聲線逐日退化,AI voice clone 連口吃、呼吸、聲調都照樣還原,佢太太第一聽就哭了。舊式 voice banking 同新技術差唔多,差喺「似唔似人」。
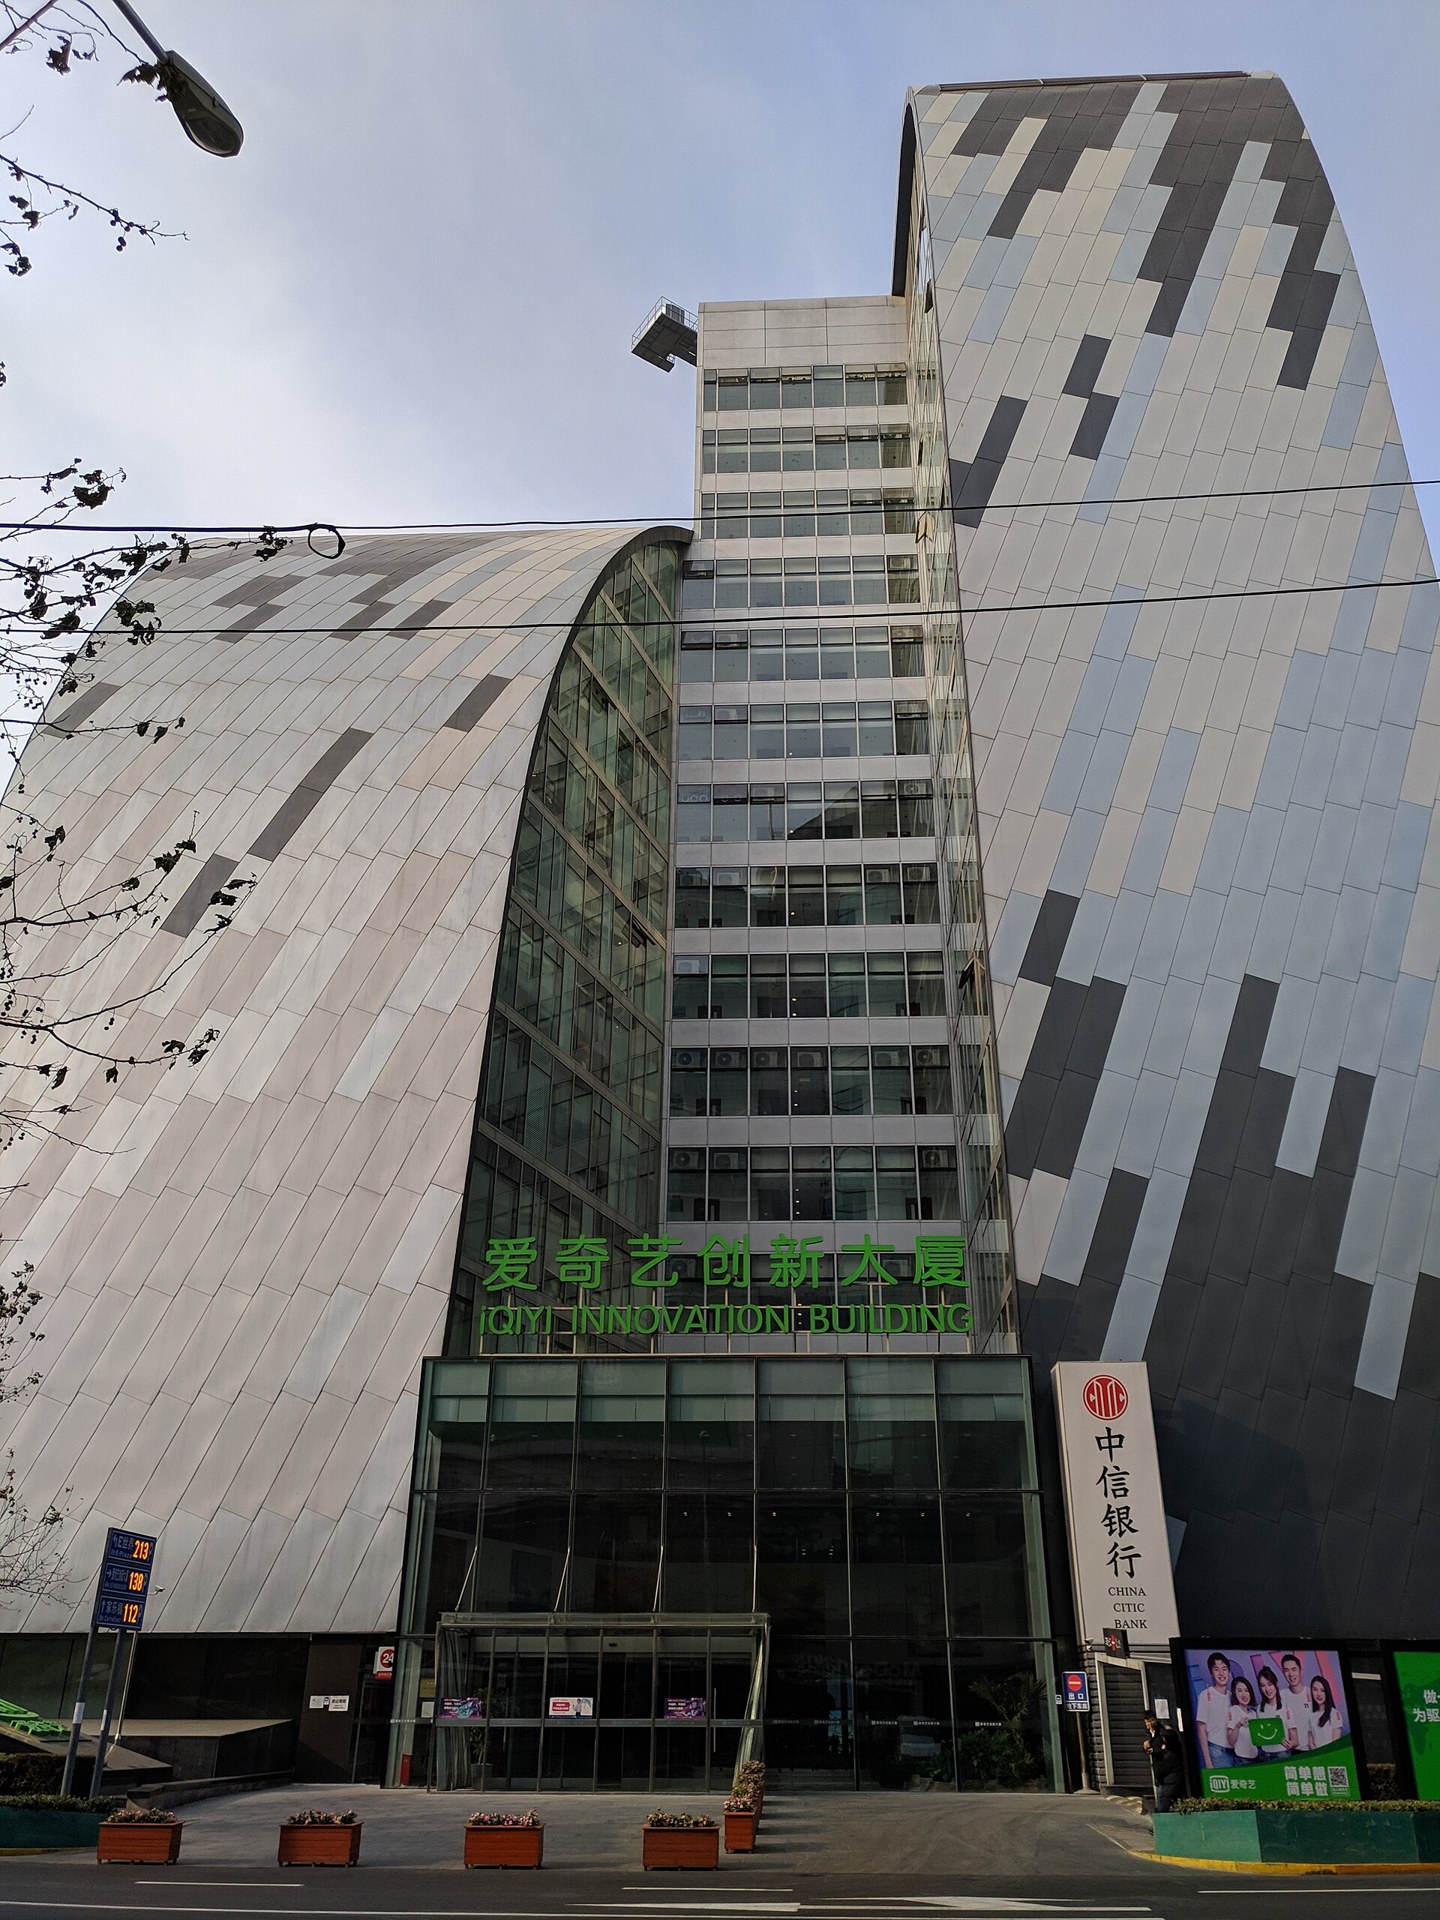
今年4月,愛奇藝喺北京影視行業論壇上演示「跳看」功能,用生成式AI自動篩選精彩劇情點,將8分鐘片段濃縮至3分鐘。功能背後,係公司580日嘅內部AI改造路徑。
鮑德熹話 73 歲擁抱新技術,聯同愛奇藝開創作營,揀 15 隊喺一季內製成 15 分鐘以上 AI 故事片,上線內地首個「AI 劇場」。
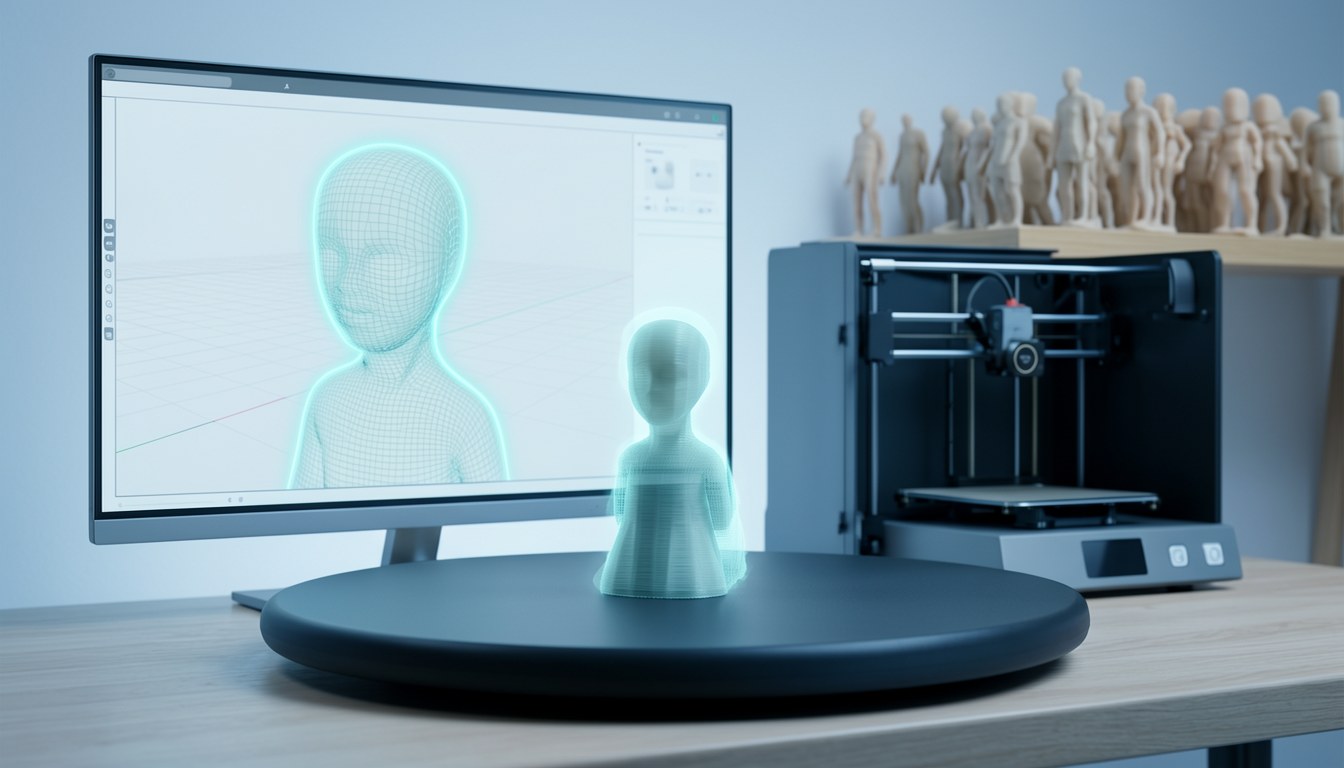
3D 公司 Meshy 推出 Meshy Edit,圈選區域加一句話即可局部修改 3D 模型,未選部分保持原樣,約一分鐘生成,每次消耗 20 積分,向全部註冊用户開放。
單次 30 秒影片、8,000 token 提示詞、15 個參考素材,仲有 720p 嘅 Flash 平價版。對照 Wan 3.0 同 Seedance 2.5,Kling 4.0 打住但冇跑贏,AI 影片呢場軍備競賽未必仲係開住加速。
TwelveLabs 嘅 Pegasus 1.5 已經可以喺 Amazon Bedrock 呼叫,將長時間影片自動切成帶時間碼嘅 JSON 元數據,一次處理最多兩小時,唔使預先索引。
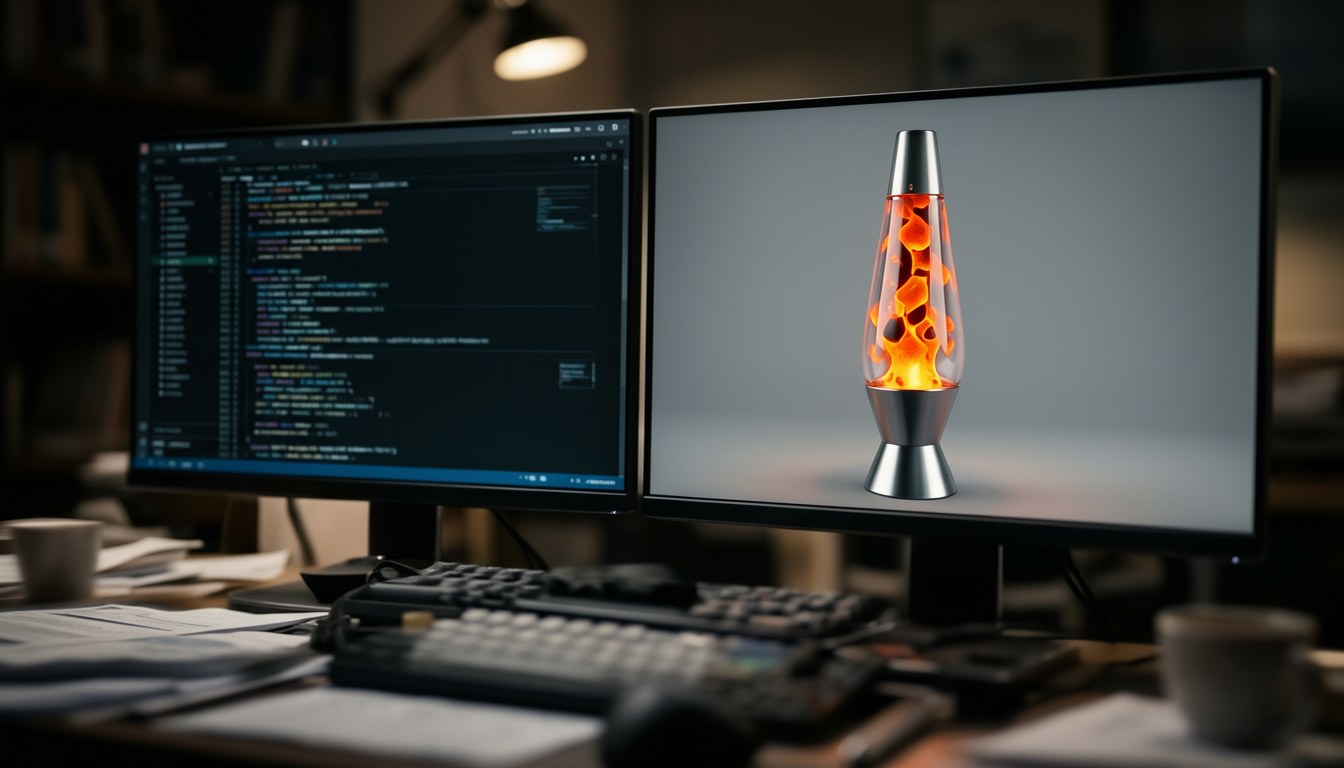
Meta 10月12日推出 Muse Wonder,官方成績不俗,惟被要求製作 3D 熔岩燈時露餡。首席 AI 官 Alexandr Wang 承認未就 3D 顯式訓練,馬斯克一句「Hmm」更添爭議。
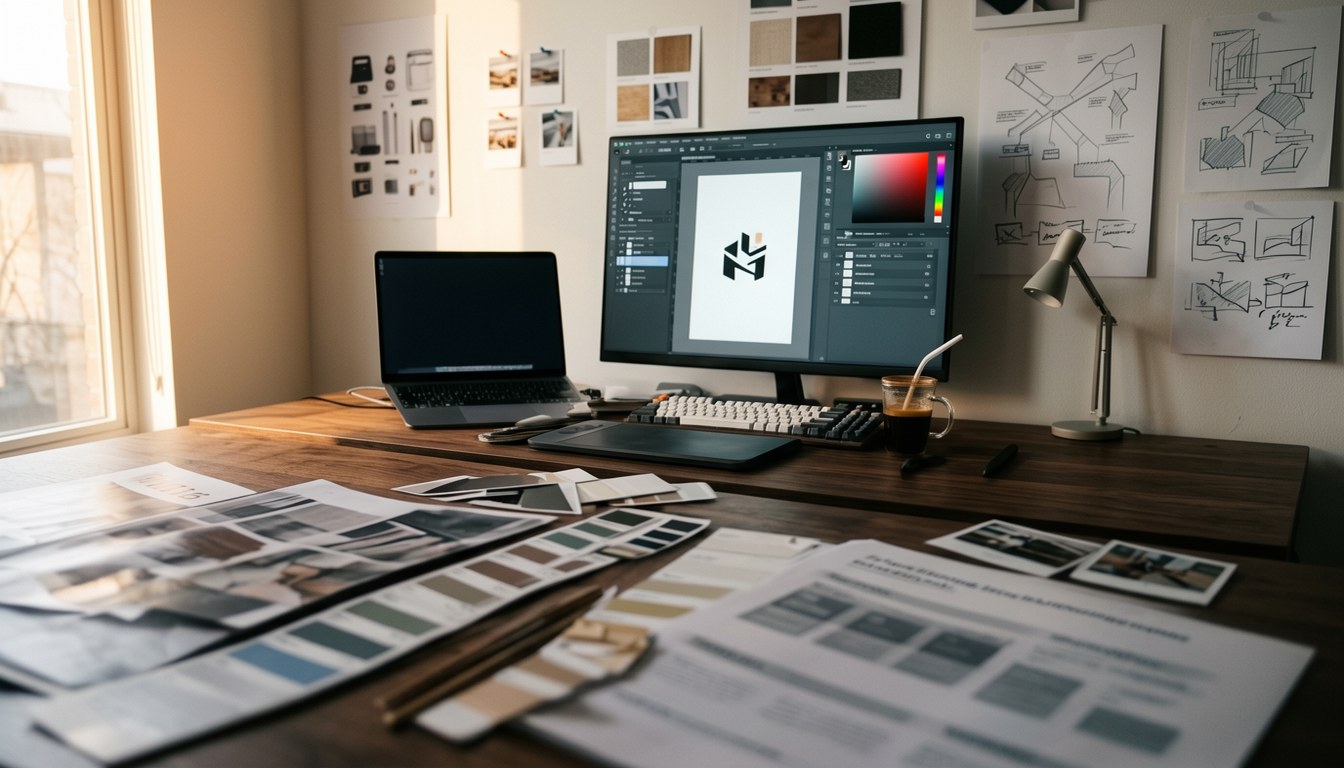
AI 出圖快,但改稿、對準品牌調性、跨項目記憶照樣拖慢節奏。Lovart 2.0 新推個人設計 Agent「Arti」,宣稱會記住你嘅審美同工作習慣,仲可以 24 小時自動做設計調研。
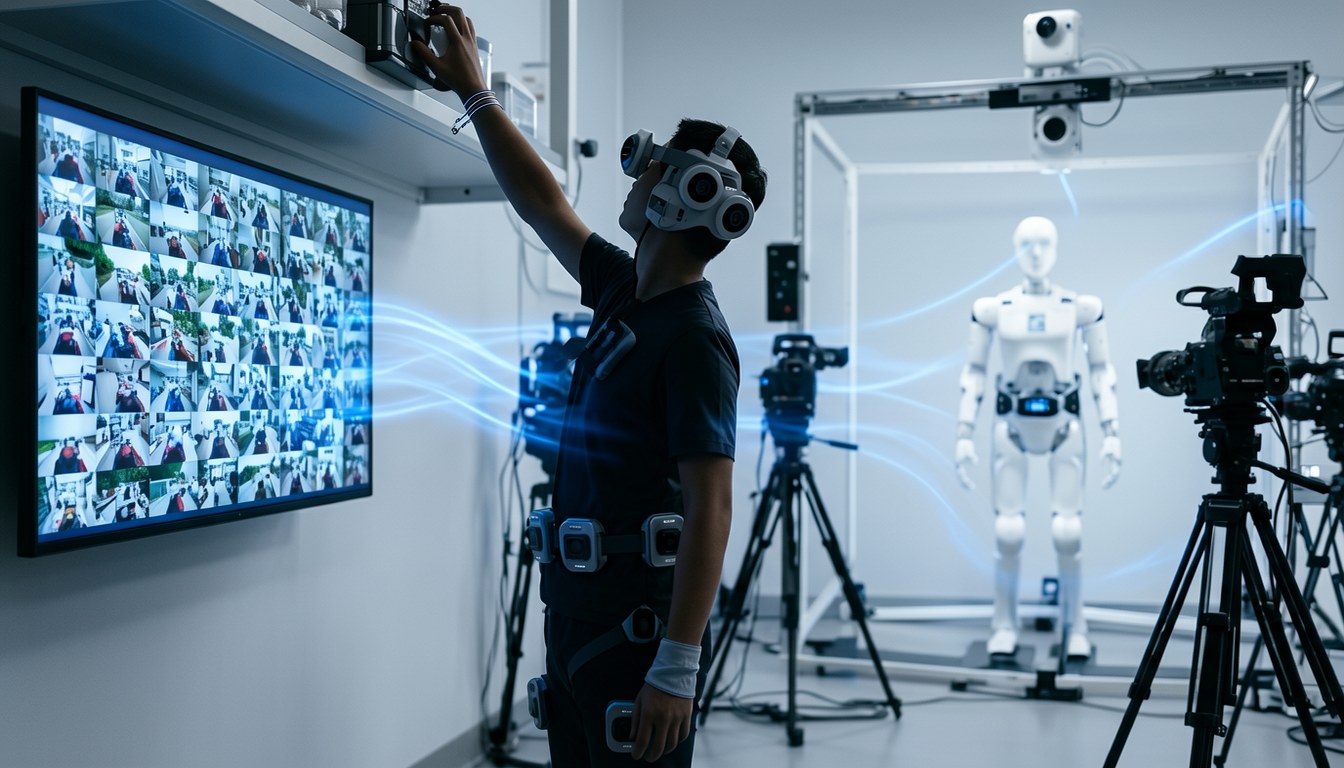
哈工大(深圳)26 歲長聘教授楊朔同團隊推 SeePhys Hub,補第一視角數據缺嘅身體姿態同觸覺,為 2027 全模態世界模型儲備。
Higgsfield 公佈三項創作能力升級:GPT-6 Astra 將 AI 影片由 1 分鐘延長到 10 分鐘以上,GPT-Image-2.5 提升視覺精度,GPT-Live 開路語音創作。
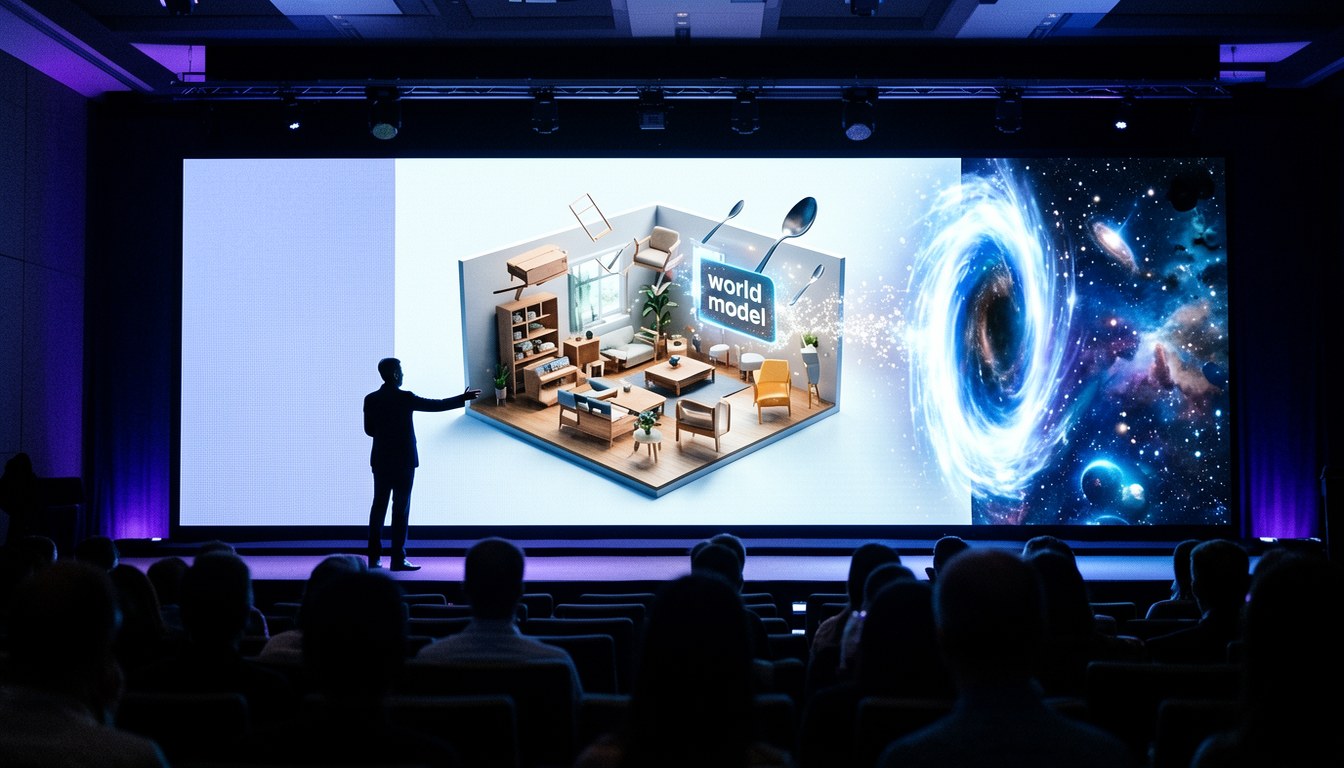
喺《2026 美好奇妙夜》現場,字節演示其未發布嘅世界模型:一語生成微縮房間、憑空攪出物件並可交互、任意門打通不同場景。AI 已唔止生成內容,開始生成一個能持續存在、持續交互嘅數字世界。
TII 發布聚焦阿聯酋嘅阿拉伯語語音辨識模型 Falcon-ASR,1.6B 參數,6 個測試集平均 WER 20.92%;權重同 API 未開放。
語音 AI 被當做下一個大接口,但 PolyAI、Otter 兩間公司高層都承認:ASR 漏詞、轉寫出錯,整條 pipeline 一斷就全錯。
美國公司 Odyssey 開放世界模型 Odyssey-3 嘅公開研究預覽,文字即時生成可互動嘅虛擬世界;公司自稱物理基準測試拿分最高,但該紀錄唔符合基準規則。
Nikon「Small World in Motion」微觀影片比賽原本嘅冠軍得主,因為影片使用生成式 AI 處理,違反比賽規則而被取消資格。Nikon 稱會重審比賽規則。
業界分析指世界模型可喺虛擬環境生成近乎無限嘅訓練經驗,幫實體 AI 解決訓練資料稀缺嘅痛點,但技術仲處於初期,模擬同現實之間仲有落差要跨。
生圖模型再升一版:4K 攝影級輸出、蒙版編輯同主體一致性升級,1K/2K 生成價截半,開發者可經 API 接 gemini-nano-banana-2.1。
阿里 Qwen 團隊發佈 Qwen-Image-2.1-Turbo,係開放權重 Qwen-Image-2.1 嘅加速檢查點:同樣 7B 架構,去噪由 40 步壓縮到 8 步,仲提供託管 API。