AI 語音、音樂與即時對話
Ollama 加咗語音模型 Phonon:本地文字轉語音,邊生成邊播
本地模型運行平台 Ollama 喺 2026 年 10 月 24 日宣佈支援語音模型,首個模型係 Gradium 開發嘅 Phonon,現已喺 macOS 上線,聲線可喺生成同時流式播放。

本地模型運行平台 Ollama 喺 2026 年 10 月 24 日宣佈支援語音模型,首個模型係 Gradium 開發嘅 Phonon,現已喺 macOS 上線,聲線可喺生成同時流式播放。
10月23日上映嘅《三星堆:未來往事》係內地首部長片級AI電影,兩日累計票房約90萬人民幣,遠低於千萬級成本,業界指技術未必係觀眾買入場嘅賣點。
Block 話 Dessa 係首個完全用人類語音訓練、冇任何文字資料嘅 AI 語音模型,可即時識別情緒、反諷、笑聲同停頓,但仲未對外開放。
Kyutai 發布 CADRE,一套 7 個開放因果擴散影片自編解碼器,做互動世界模型。官方數據:1 塊 H100 跑 20 fps,反應低於 230 ms。
Simon Willison 2026 年 10 月 23 日喺網誌分享用 Claude Opus 5.5 High 嘅 prompt 實驗:開一張相片,數秒內用 HTML canvas 元素同模擬畫筆畫出該相嘅畫筆版本。
特讚創辦人范凌喺上海WTCC論壇提出:企業 AI 要真係變產能,唔係換一個更勁嘅模型,而要補兩個「世界模型」——一個理解客户,一個理解公司。
10月23日北京 iRTE2026,聲網 CEO 趙斌拋出「五級對話能力」框架,話足實時對話底層要幾多低延遲同全雙工(full duplex),先至有講頭。
模思智能同 OpenMOSS 團隊開源嘅 5B 生圖模型 MOSS-Image,上線僅四天喺海外收 130 萬下載,登頂 Hugging Face 文生圖趨勢榜。
月之暗面未正式公佈 K3.1,但配置檔、模型列表、Arena 盲測同 SGLang 合併請求早已逐個洩露;網傳成本、效能聲稱均未獨立查證。
Google 首次為 CarPlay 版 Google 地圖加語音助理,駕駛可自然對話查詢地點、避開收費路,甚至語音回報塞車。功能 10 月 21 日美國先上,其他地區陸續跟進。
AWS 旗下語音合成服務 Polly 嘅生成式引擎全面升級,新增 14 條聲線、首次覆蓋印地語同芬蘭語,並可視文字情緒自動調整語調,舊應用唔使改 API。
Canva 宣佈自家研發嘅 AI 生圖模型 Canva Craft 向所有用户開放,用公司設計庫嘅人工模板訓練,將透過 API 同 MCP 接駁第三方聊天機器人。
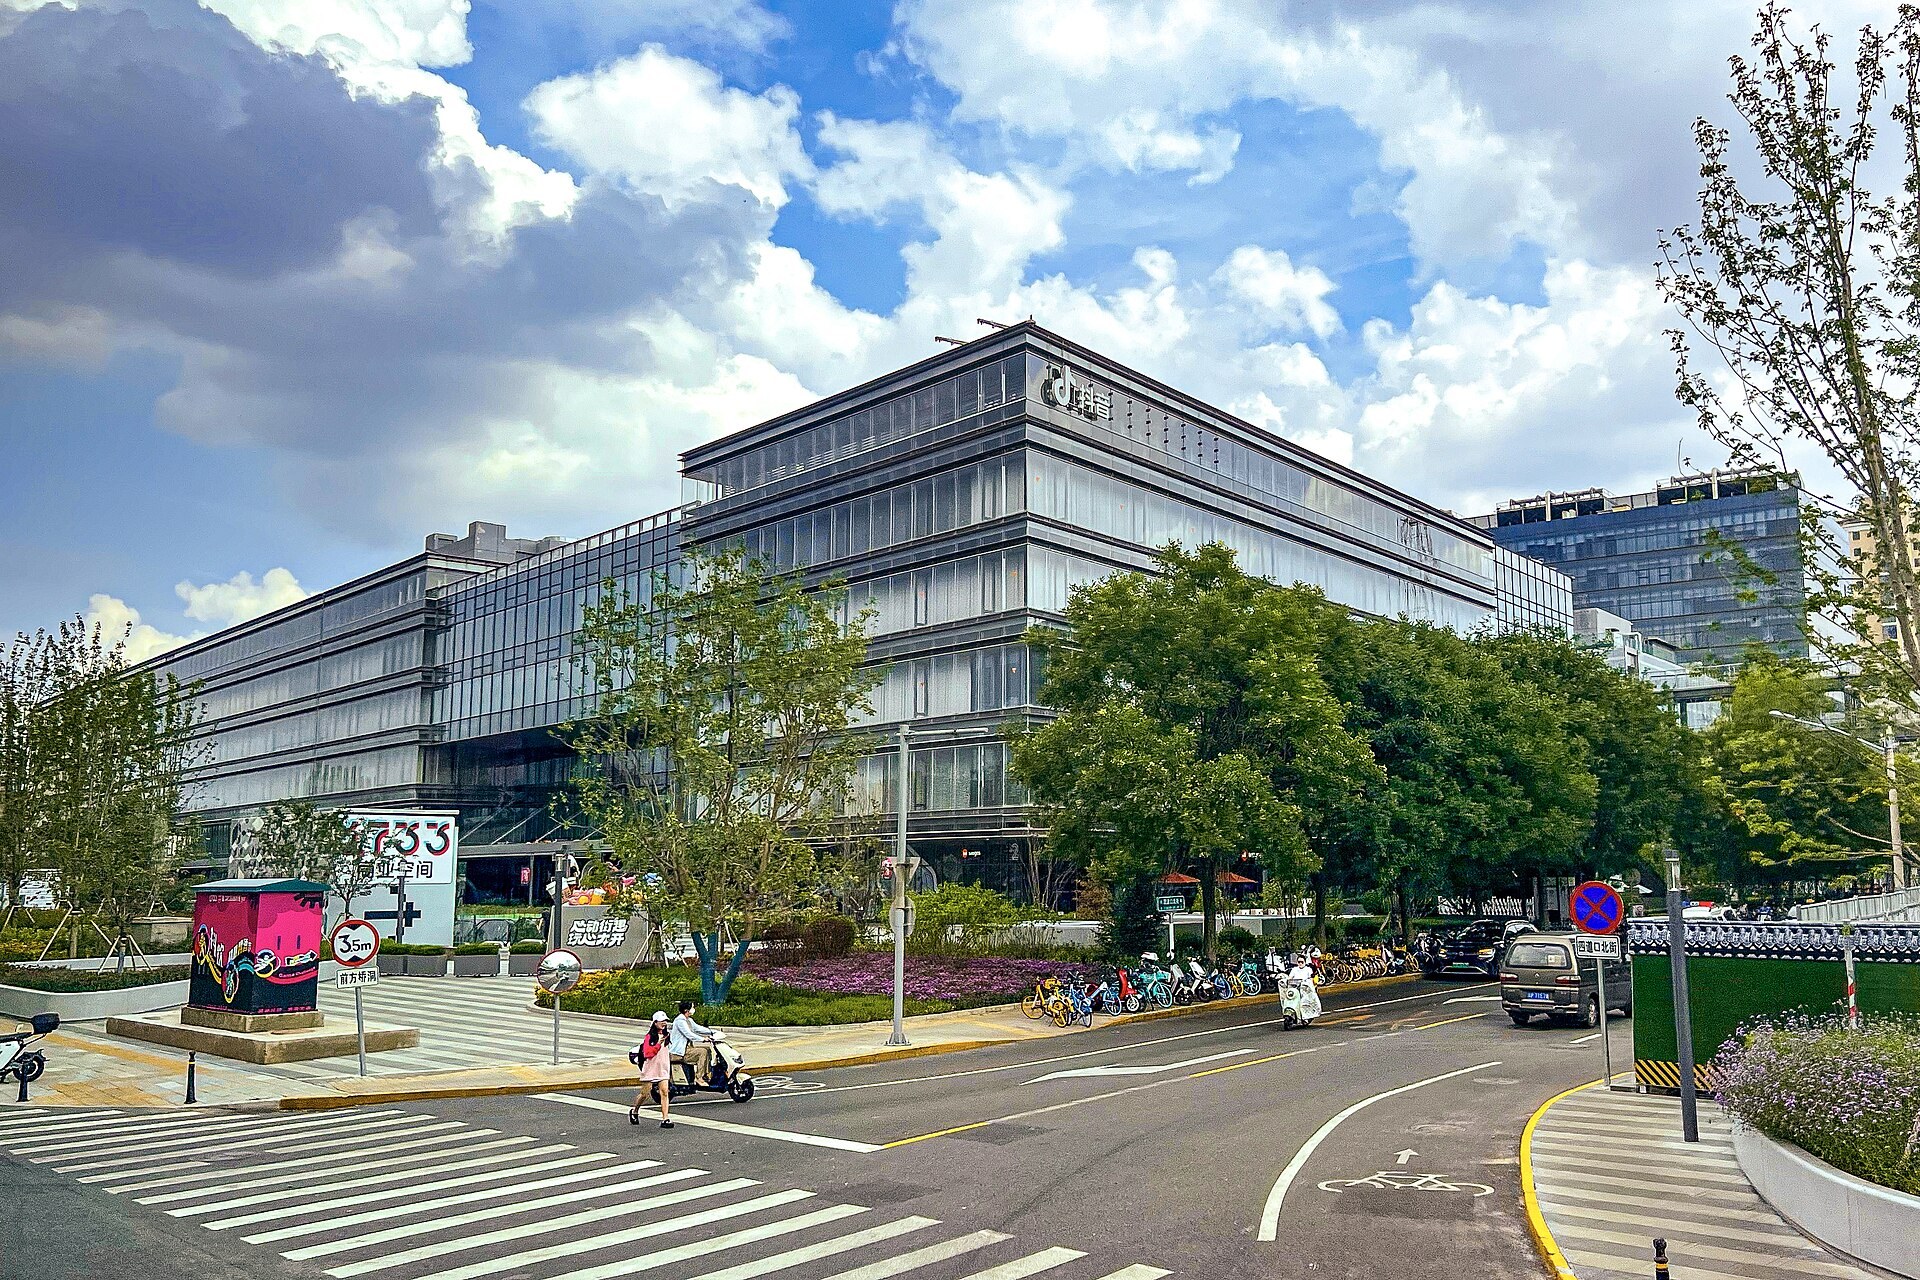
火山引擎正式開始 Seedance 2.5 4K 影片模型嘅首批企業試用,定向供貨全球20間工作室及導演,並開放「先480P出樣片、滿意鏡頭先4K重產」嘅分段計價。
NVIDIA 宣佈 Cosmos 平台新增訓練工具、模擬檢查點同 Cosmos Data Factory 數據管線,開放 GR00T、QWEN 等模型微調,Porsche 指實車測試料減九成。
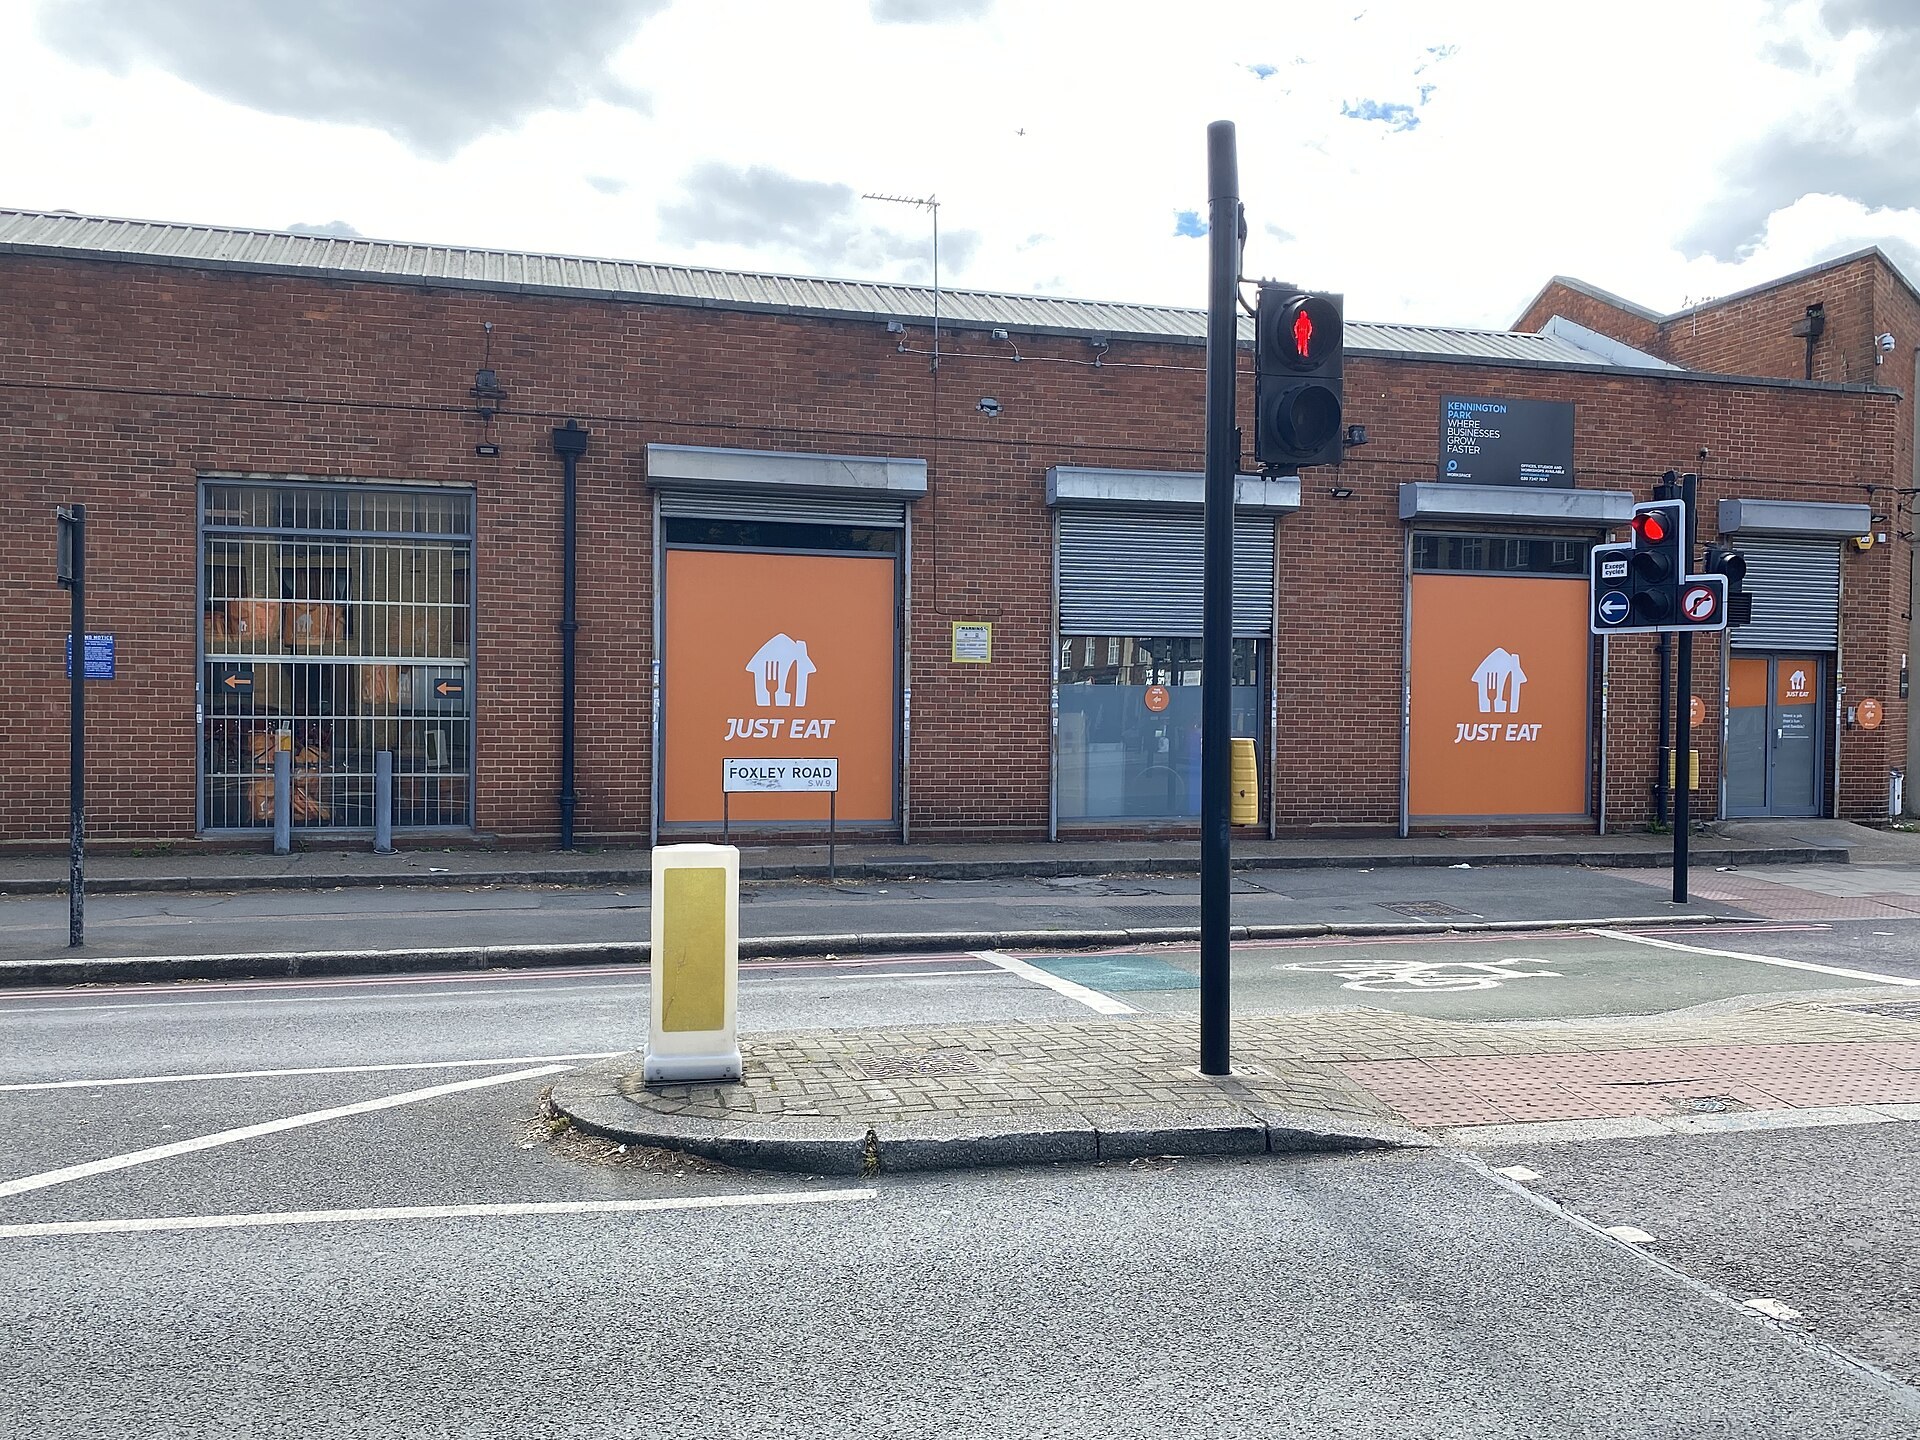
英國外賣平台 Just Eat 試行 AI 生成食物圖片,結果 bacon 同蛋「入」咗可樂、soda bread 成汽水,被網民大玩,公司已道歉並暫停推廣。
IBM 21 日更新三個 Granite Speech 模型:新 2B 多語言轉寫模型開放權重、支援 Apple Silicon,邊緣小模型 Turbo CTC 速度提升約 1.6 倍,多講者轉錄 WDER 降 7%。
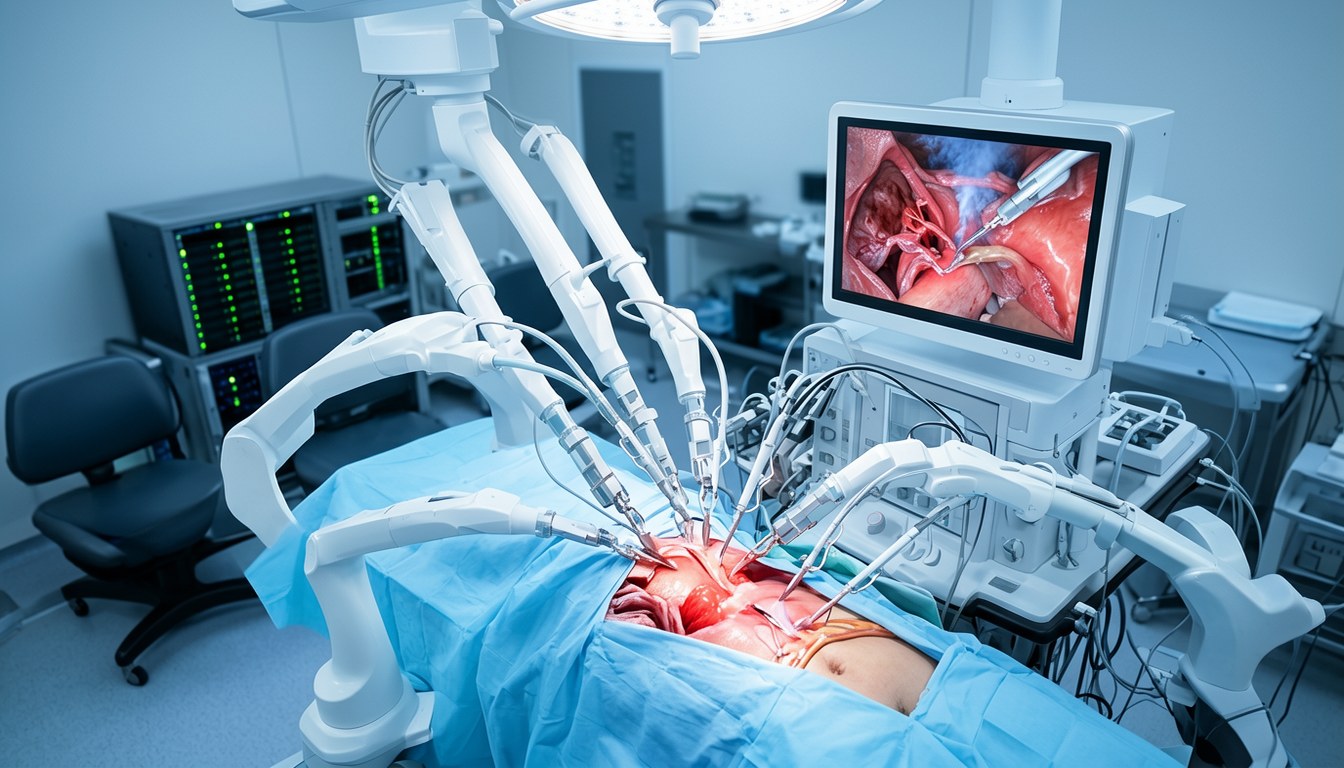
NVIDIA 公佈 Cosmos3-H-Dreams,利用生成式模型配合臨床手術錄像,訓練出可即時互動嘅膽囊切除模擬器,只需一張 RTX PRO 6000 GPU 已可運行,唔使數值模擬。
Elevenlabs 推出 v1 Max 同 v1 Mini 兩款即時語音對話模型,Max 喺 Big Bench Audio 得 98.8%、反應 0.57 秒,可經 OpenAI 兼容 Realtime API 使用。
Mistral AI 今日正式推出 Voxtral 3,整合語音轉文字、文字轉語音同聲學代理 SDK 成即時流水線,支援逾 50 種語言,由聽、諗、開到口到落單,全部喺度完成。