
算力與部署
NVIDIA 出邊緣端 AI 開發快線:trtedge 幾行指令即下載跑模型
NVIDIA 技術部落格刊出教學,用 trtedge CLI 喺 DGX Spark 上以數行指令下載、構建同運行 Nemotron-3.5 Lightning,並提供 OpenAI 相容 API;官方稱同套框架可部署喺 Jetson、DRIVE AGX 同 IGX Thor 等邊緣平台。

NVIDIA 技術部落格刊出教學,用 trtedge CLI 喺 DGX Spark 上以數行指令下載、構建同運行 Nemotron-3.5 Lightning,並提供 OpenAI 相容 API;官方稱同套框架可部署喺 Jetson、DRIVE AGX 同 IGX Thor 等邊緣平台。

Google 29 日發布技術論文,指 Gemini 單次文字提問嘅中位數耗水約 0.26 毫升。數字來自公司內部量測,點計數、邊度透明,要逐條睇。

Oracle 喺 Oracle AI World 大會宣佈,計劃 2027 年秋季將 Arm AGI CPU 導入 OCI,為客户提供 Arm 架構運算能力,支援現有雲端應用同未來的代理式 AI 服務。

NVIDIA 喺技術博客公佈 AICR,將 Dynamo 同底層基礎設施打包成「驗證過嘅配方」,固定元件版本、NATS 唔再預設安裝。
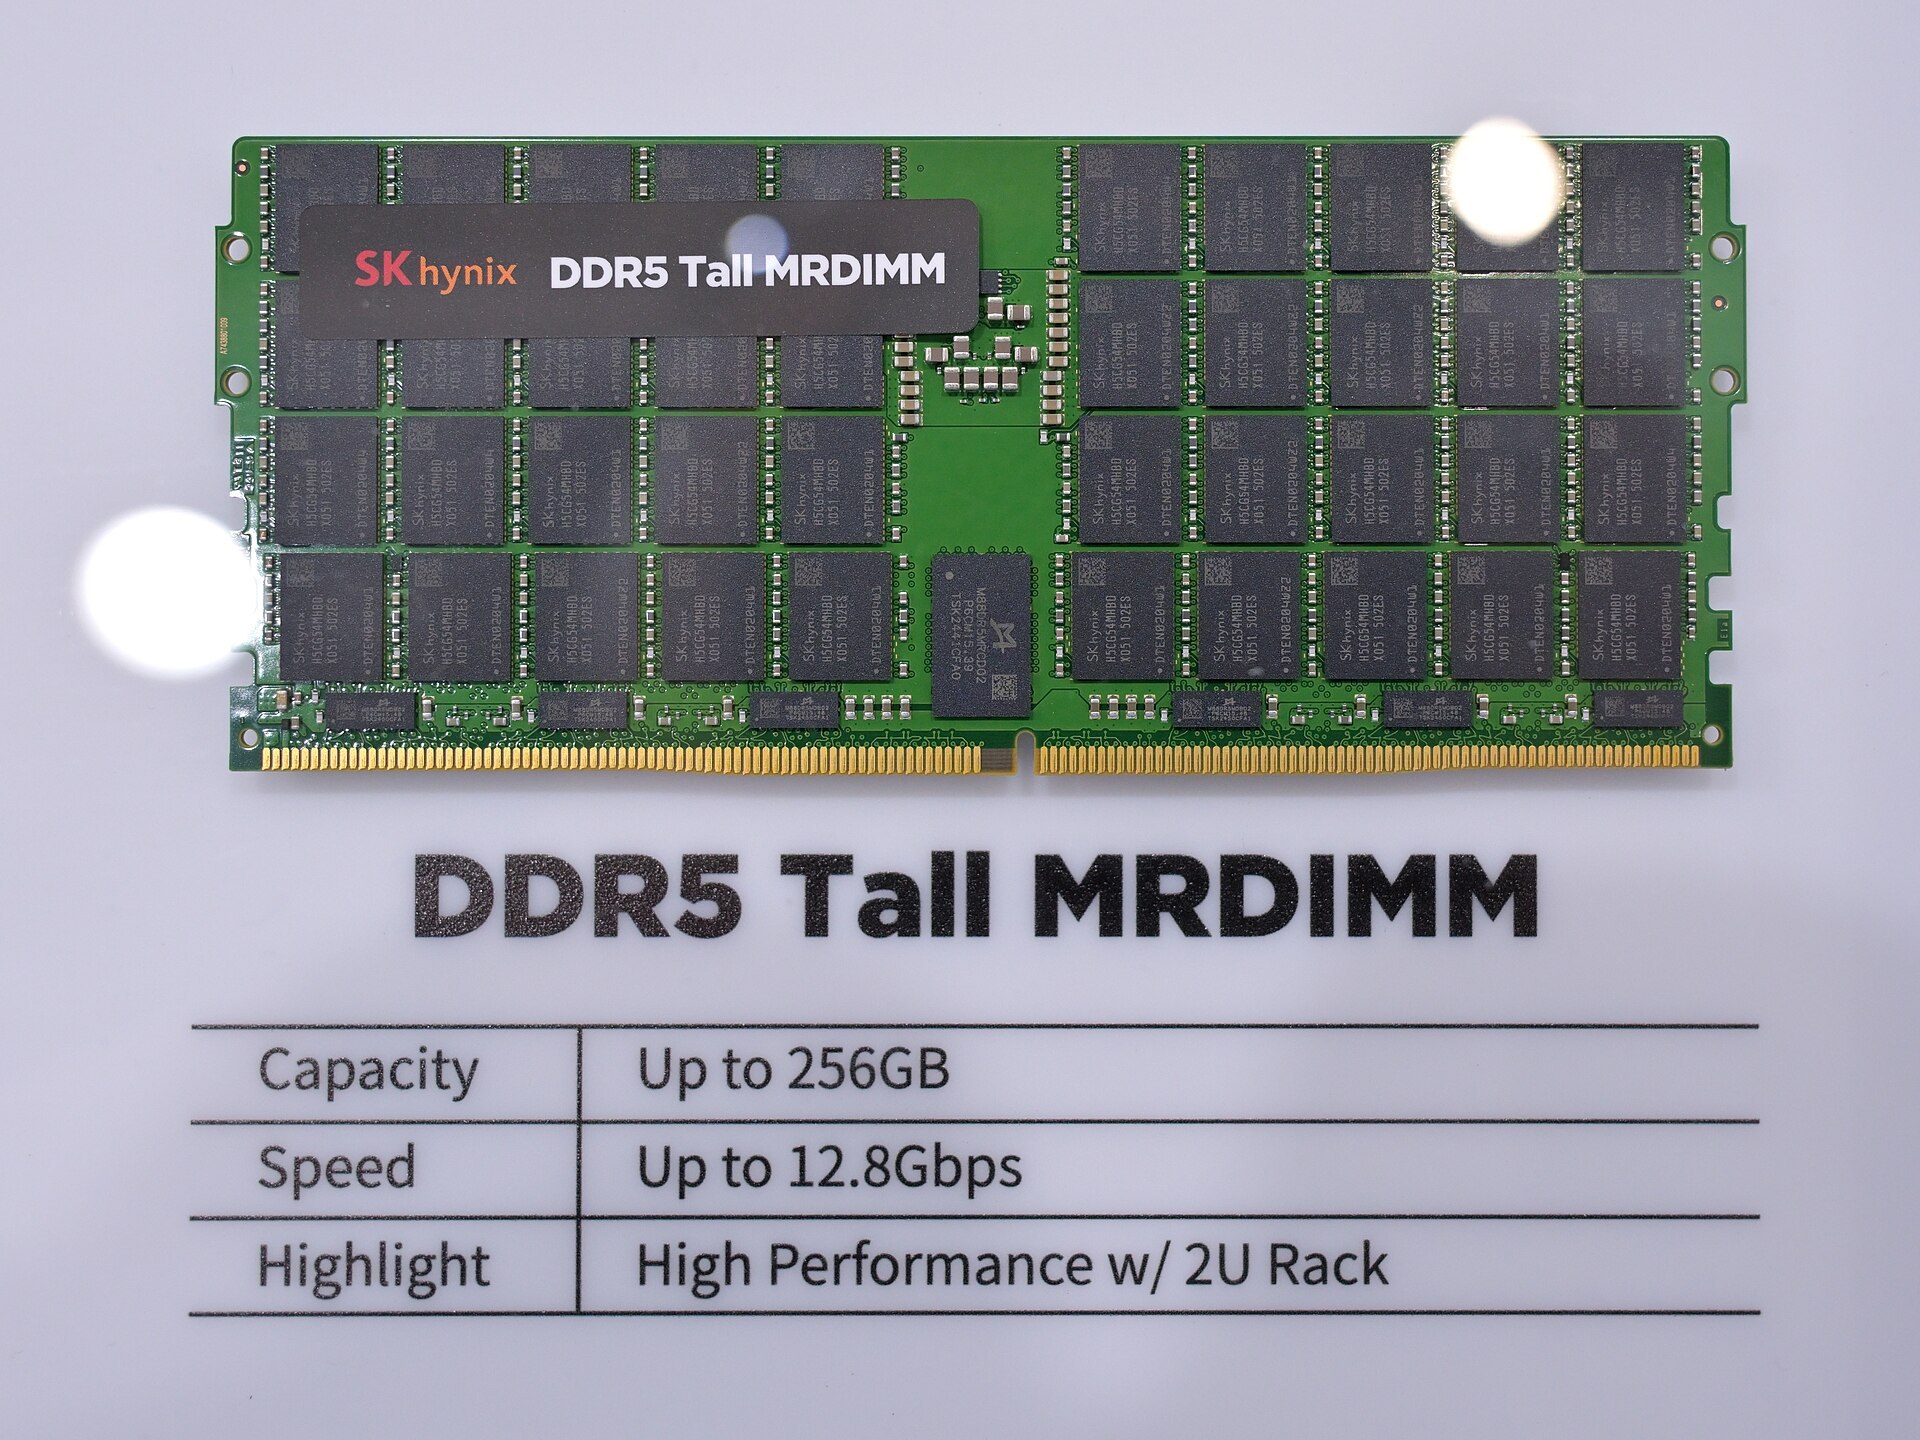
OpenAI CEO Sam Altman 喺 Cheeky Pint podcast 指,全球有限嘅 DRAM 放喺個人電腦、使用率只約 5%「相當糟糕」,倡把資源集中喺數據中心;被視為為 OpenAI 嘅閉源、雲端業務模式辯護。
Google Suncatcher 項目嘅太空數據中心原型衞星已上線,同地面工程師嘅第一次通訊係叫預載嘅 Gemma 4 寫一首太空俳句。
NVIDIA 公開 NemoClaw 開放圖譜,配合 OpenClaw、Hermes Agent、LangChain Deep Agents 三個 harness,開發者可喺自己擁有嘅堆棧上組裝專用 agent;「10倍降本」係廠商自稱,未見獨立驗證。
NVIDIA 推開源 gds-diag 命令列工具,幫用户檢查同優化 GPUDirect Storage 配置,另附 AI agent skill 可用自然語言操作。
AI 設備搶走 PC 同電子產品嘅製造產能:有 PCB 訂單排 30 個月先交貨,亦有供應商指新單排到 2028 年尾;CCL(覆銅板)料價由 7 月起貴咗至少 12 倍,訂單簿排到 2030 年。
Nvidia 同 Oracle 喺 Oracle AI World 聯合宣佈 Vera CPU 喺 OCI Superclusters 全面可用,係 Nvidia 首次將 CPU 獨立部署喺超大規模雲商;本地 Stream benchmark 顯示 Vera 記憶體頻寬超過 dual Xeon 6 一倍。
GitHub技術報告披露AI代理令程式碼提交量按月增長至74億次,公司被迫大擴容數據中心,CPU核心、存儲同網絡頻寬全面升級。
IDC最新《中國AI軟件市場半年度追蹤》指2026上半年中國MaaS市場106.3億元、按年增889.4%;PPIO稱排名獨立服務商首位,惟該文由PPIO供稿,數據未經獨立查證。
台電預估半導體用電由2026年約520億度升見2035年1100億度、佔全國約三成,台汽電聯同英特爾、西門子等六方探討AIDC自備電力與跨域供電。
阿里云喺國際云栖大會推出 Apsara Stack International v3.18,主打 100% 本地部署、完全斷网運行,已覆蓋全球超過 20 個國家地區,阿斯利康等國際企業開始用千問開發專屬 AI 應用。
美國明尼蘇達二手 IT 商 Core 4 Solutions 喺 eBay 掛一座除役 AI 叢集,標價 5,970 萬美元、FedEx Ground 免運,10 月 28 日已提前下架,冇交代有冇成交。
Prime Intellect 發布 Prime Mega MoE,為 DeepSeek 嘅 fused Mega MoE kernel 補上反向傳播,喺 prime-rl 訓練 Qwen3 MoE 時,訓練步驟最快提升 34%。
今次唔係新模型,而係 DeepSeek-V4.1-Flash 背後嘅推理引擎,公開了 MoE 專家並行、Zero-Overhead Batch Scheduler、推測解碼等底層調度技術;但離線推理先開放,線上 KV Cache 存儲與跨副本負載均衡仲冇完整公開。
NVIDIA 於 2026 年 10 月 29 日開放 120B 參數多模態模型 Nemotron 3.5 Super VL,權重、訓練數據集同後訓練方法全部公開,已喺 AWS EKS 同 SageMaker HyperPod EKS 上架。

AWS 喺 AWS Batch 加入 quota management,將 GPU 算力劃成按團隊或項目分嘅 quota share,閒置資源可自動借出,另設跨 share 同 share 內搶佔,令優先訓練任務先跑。
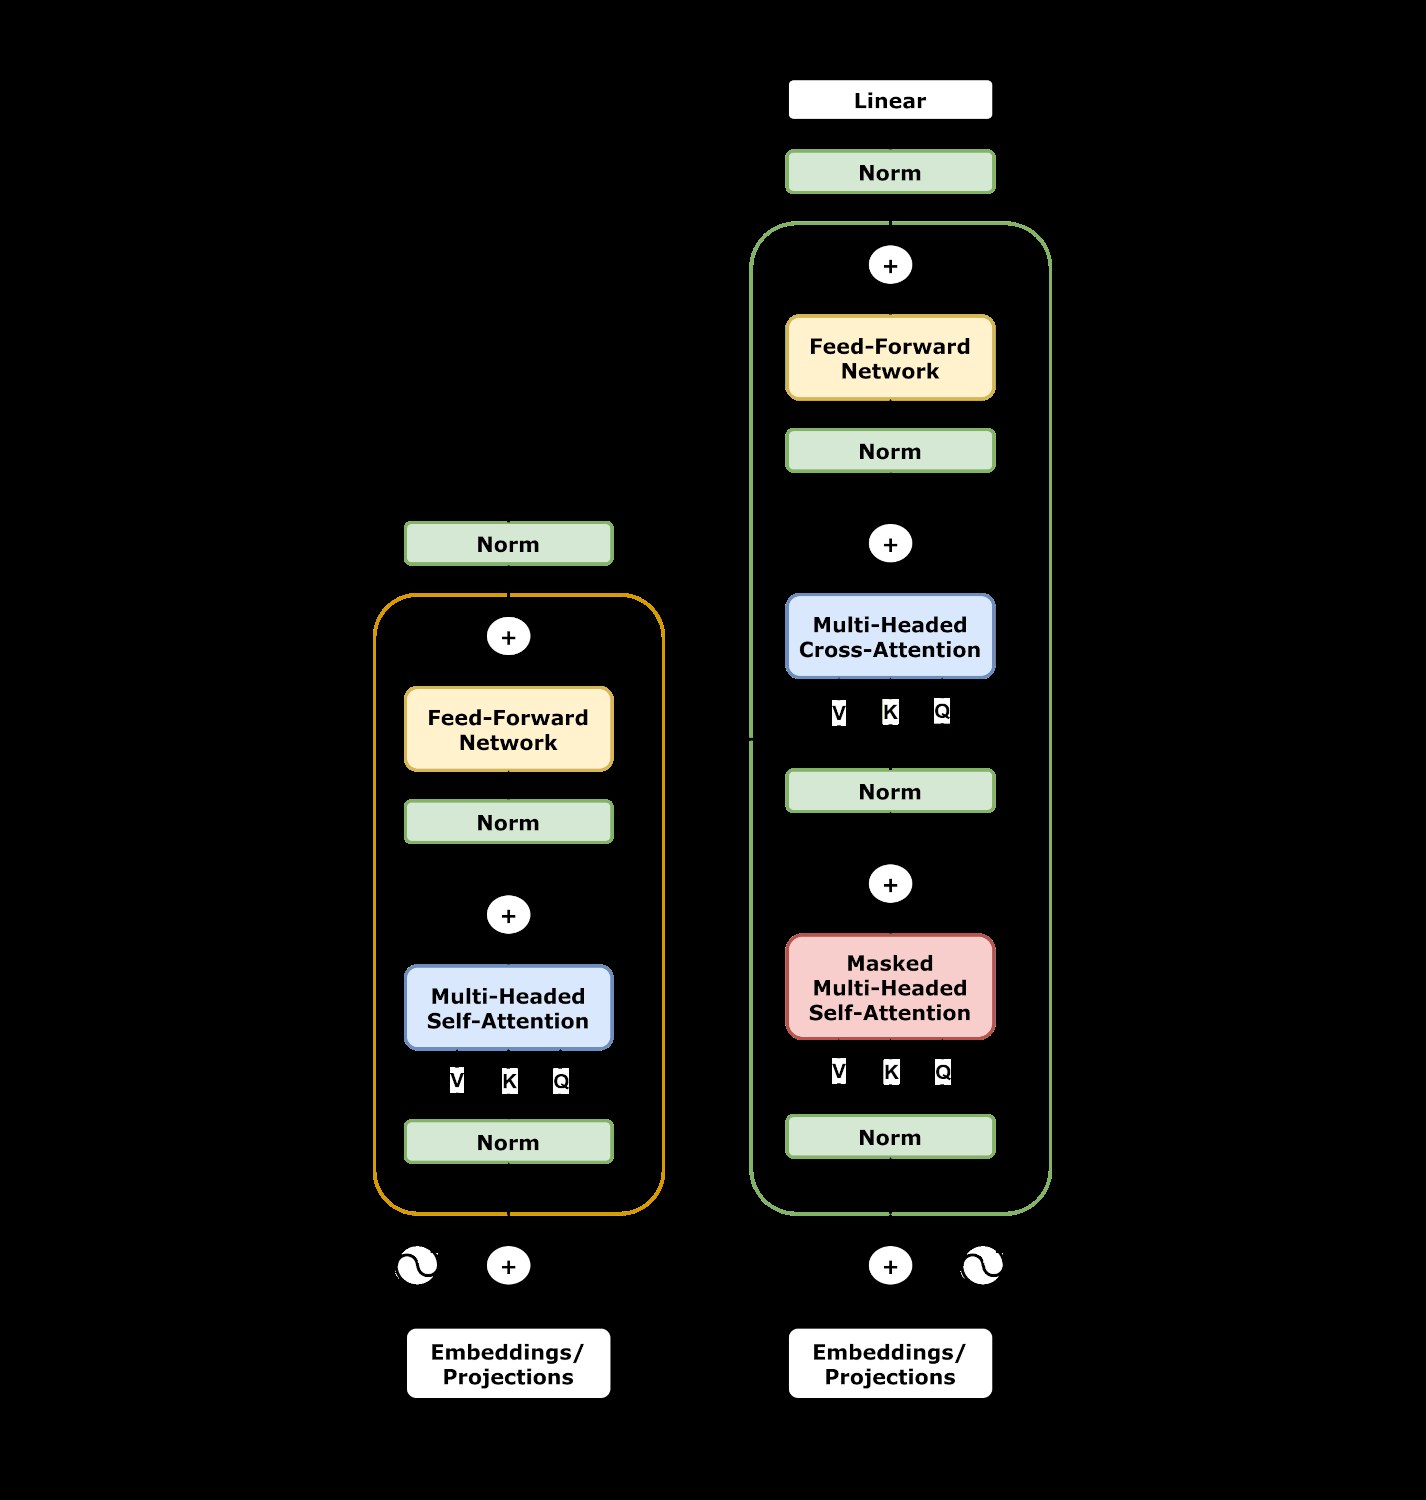
vLLM 宣佈對 Mistral 新旗艦 MoE 模型 Mistral Large 4 提供 day-0 支援,涵蓋稀疏 MLA 注意力、DSpark 投機解碼、長上下文 DCP/PCP 同 NIXL 分離式推理;NVIDIA Blackwell 可 NVFP4 量化上 4 卡,AMD MI350 同步 day-0。