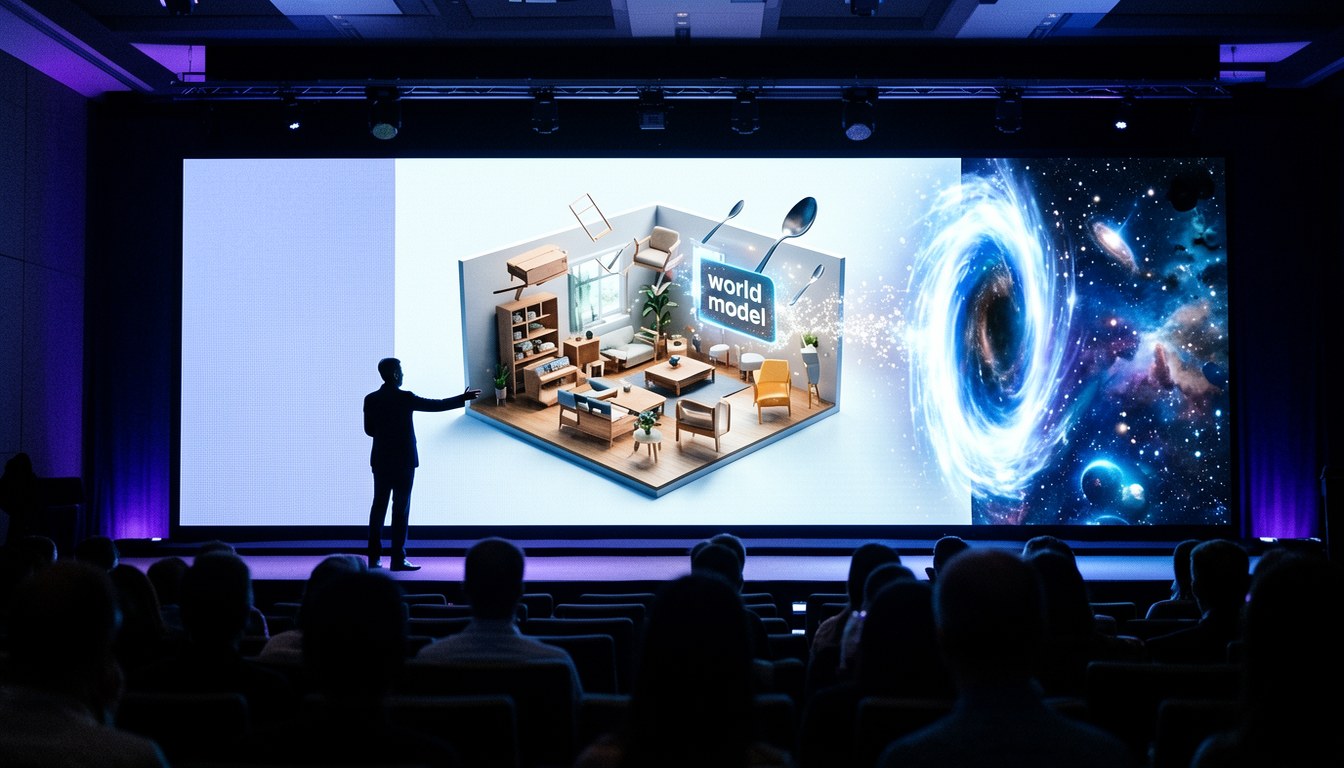
喺剛結束嘅抖音集團《2026 美好奇妙夜》科技節目上,字節跳動借住現場演示,首次亮出其一直研發但尚未正式發布嘅「世界模型」(world model)。演示者係影視颳風嘅 Tim。
現場展示嘅操作大致分幾步:先一語輸入,AI 就憑空生成一個微縮小人視角嘅房間;其後操作者可以喺個 AI 生成嘅世界入面自由飛行探索,喺場直接憑空生成一把勺子,跟住仲可以喺勺子上面爬行,實現即時動作交互;最後仲有「任意門」功能,可以把兩個互不相關嘅場景直接打通,即上一秒喺屋企,下一秒推門就踏入外太空。
需要註明,呢一系列操作全部係節目現場嘅廠商演示,模型本身尚未對外發布,無任何技術規格、測試數據或價格可供獨立查證。現場演示顯示該模型已具備三維場景生成、自由探索、即時交互、物件編輯及跨空間連接等能力,但實際效能與穩定性仍須待正式發布同獨立測試。
點解要研究「世界模型」
過去幾年視覺生成技術一直有一塊未解決嘅短板。2024 年 OpenAI 發布 Sora 同期嘅技術報告《Video generation models as world simulators》,就指出規模擴大後模型會湧現出一定嘅三維一致性、物件持久性同簡單環境交互,但生成逼真畫面,同維持符合物理規律嘅世界狀態,之間仍隔住一道建模問題——例如 Sora 可以生成跑步機上跑人嘅畫面,人物光影鏡頭都似模似樣,但人同跑步機嘅物理運動關係未必符合現實。
今年(2026)6 月,李飛飛(Fei-Fei Li)團隊發表《A Functional Taxonomy of World Models》,將世界模型由功能角度劃分作三類:負責視覺畫面嘅「渲染器」、負責維持符合幾何與物理因果嘅場景狀態嘅「模擬器」、以及負責智能體下一步行動嘅「規劃器」。呢套分類大致解釋咗點解 AI 已經生成到亂真影片,但仲要額外研究世界模型——空間表征、動態預測同行動規劃,正正係傳統多模態生成模型未充分解決嘅技術難題。
除字節,呢條技術路線亦有多間科技巨頭同時佈局,包括李飛飛創辦嘅 World Labs、Google DeepMind 嘅 Genie、以及 NVIDIA 嘅 Cosmos,目標都係令 AI 理解空間結構、模擬現實規律、預測環境隨人行動而變化。
對打工仔同企業嘅意義
世界模型另有一層產業價值:將現實環境轉化為可生成、可控制、可反覆驗證嘅虛擬訓練場,讓機械人同自動駕駛喺虛擬世界大規模訓練、反覆試錯,再將習得嘅能力遷移到現實。呢個對解決真實數據采集成本高、危險同極端場景難以重現等限制,有實際意義,但距離實際商用仍有待觀察。
阿調搞兩下
廠商借住電視節目「首次亮相」一個未發布嘅模型,呢招先發制人值得留意——觀眾見到嘅係一場精心設計嘅演示,唔係可複製嘅產品。字節呢個世界模型幾時正式發布、有冇 API、幾錢、幾好,目前全部未知,阿調就等正式消息先再落筆。
阿調|深度調教