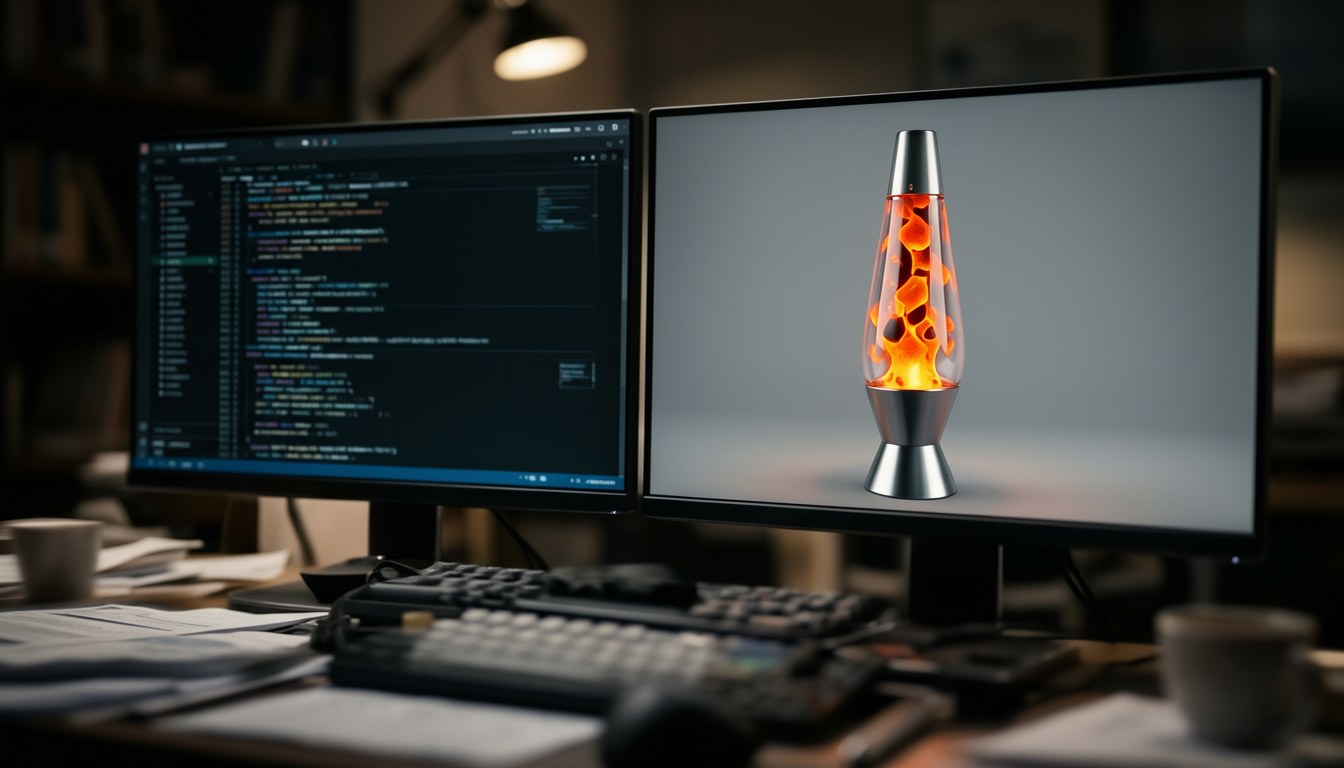
10月12日,Meta 推出 Muse Wonder 同 Muse Wonder Full,主打 Coding Agent、工具調用同長任務執行。官方公佈嘅成績聽落好靚:Wonder Full 喺 SWE-Marathon 攞到 57.5 分,DeepSWE 1.1 有 79.0 分。但開發者社區 BridgeMind 隨後安排咗一項 3D 編程測試,要求 Muse Wonder 製作一盞透明玻璃外殼、動態熔岩同光照效果嘅熔岩燈,結果即刻露餡。
官方承認 3D 係已知弱點
BridgeMind 質疑 Muse Wonder 存在嚴重「Benchmaxxing」,即針對特定 Benchmark 大量優化,成績看似漂亮但遇到陌生任務就露餡。Meta 首席 AI 官 Alexandr Wang 回應,團隊確實冇針對 3D 演示遊戲做顯式訓練,事後看來或許應補充相關訓練,但仍希望開發者實際體驗 Muse Wonder 嘅 Coding 能力。
值得一提,Meta 官方 Model Card 已明確承認,視覺與空間推理,尤其是 3D 任務,屬 Muse Wonder 嘅已知弱點。另外,熔岩燈測試針對嘅係普通版 Muse Wonder,而部分突出成績來自 Wonder Full,兩者存在能力差異。
點解跑分好看,實戰就翻車?
呢個現象同當代大模型依賴 Post-training 提升任務能力嘅技術路線有關。在 Pre-training 階段,模型透過大規模數據學習語言、代碼、空間關係等同用知識;進入 Post-training 後,尤其透過強化學習(Reinforcement Learning),訓練會塑造模型喺特定任務環境中嘅執行策略。Coding Agent 唔少呢類訓練,因為編譯結果、單元測試可以畀明確反饋。
但熔岩燈恰好打破傳統 Coding Agent 熟悉嘅反饋方式。呢類任務涉及三維幾何、透明材質、光照計算同動態形變,即使代碼正常執行,畫面仍可能完全錯誤。編譯器同單元測試難以直接判斷視覺問題,Agent 需要一套視覺反饋機制,透過渲染截圖、識別畫面偏差再轉化為代碼修改。單純增加工具調用次數或延長推理時間,無法替代呢個環節。
Benchmark 唔等同實際水平
Muse Wonder 官方技術文章設有「Capabilities That Generalize」章節,討論正正就係 Benchmaxxing 背後嘅問題。Meta 指出,兩個模型即使喺常見 Benchmark 取得相似成績,處理陌生任務嘅能力仍可能有大差距。團隊將測試任務劃分為 In-distribution(Post-training 重點優化)同 Out-of-distribution(冇針對性優化)兩類,並比較 Muse Spark 1.3 同 Muse Wonder Full 喺不同推理預算下嘅表現。
但呢度有評測設計問題:陌生任務究竟陌生到邊個程度?對長期訓練代碼修復嘅 Agent 嚟講,換一個未接觸過嘅代碼庫,仍屬相近嘅軟件工程任務。但製作 3D 熔岩燈,除咗軟件開發,還引入空間建模、材質渲染同視覺質量判斷,對能力組合提出更大變化。因此,Out-of-distribution 泛化能力唔能只用一個綜合平均分嚟描述。
同時要留意,SWE-Marathon 並非統一 Harness 條件下嘅受控比較:GPT-6 Astra 用 Codex,Claude Fable 5.1 用 Claude Code,Muse Wonder Full 嘅 57.5 分使用 xhigh 推理檔位。呢啲配置差異唔會自動令成績失效,但會影響成績嘅解釋方式。當各種系統配置被壓縮成排行榜上一個分數,外部很難判斷成績增長究竟來自模型推理能力、執行框架優化定係更充足嘅計算資源。
模姐|深度調教