
大模型與推理能力
OpenAI 同 Anthropic 先後出證明否認「指數時間假設」
OpenAI 10 月 26 日發佈三個數學難題嘅解答,其中一個否認電腦科學基石「指數時間假設」;Anthropic 數小時後跟進出自己嘅反證。

OpenAI 10 月 26 日發佈三個數學難題嘅解答,其中一個否認電腦科學基石「指數時間假設」;Anthropic 數小時後跟進出自己嘅反證。

OpenAI CEO Sam Altman 喺 Cheeky Pint podcast 自認同情被 AI 數學結果轟爆嘅學者,但話唔會收手,並透露公司仲攞住大量未公開嘅發現,喺數學嘅投資已達數億美元。

Google 兩星期前推 Gemini 4 Argon,今再推 Carbon,宣稱喺 Artificial Analysis 智能指數 5.0 取得 59 分全球第一,並延續首發價 $2/$10 每百萬 Token。

Google 週三發布 Gemini 4 Carbon,主打網絡安全同長任務能力;SEC-bench Pro 88.2%、ExploitGym 54.8%、CWE-bench 71%。唔會公開發放,先經 Fairwind Program 畀政府同關鍵基礎設施機構試用。
Samaya AI 用 Nemotron 3.5 Lightning 後訓練,出咗個專做金融研究嘅 agent 模型 Sterling:FrontierFinance 得 58.9%,每題 $0.61,贏 Claude Fable 5.1(55.9%、$6.89)。
Fable 5.5 傳聞曝光,Anthropic 同時公開「自評估」安全機制——答完後另加一條你看唔到嘅指令,由模型自己回頭「反思」,算力開銷不足 2%,用户唔知有冇被標記。
兩週前 Argon 先擴大推出,而家 Carbon 已登上 Artificial Analysis Intelligence Index v5 頭名,主打網絡安全防禦,目前只開放俾指定用户,尚未全面公開。
IBM 喺 Hugging Face Blog 宣佈一星期前推出嘅 Granite Switch 4.1 已有補丁版本 4.1.1;除咗新 ASR 同 Decision Adapter,Base Model 冇重訓,並預告開發 Adapter SDK。
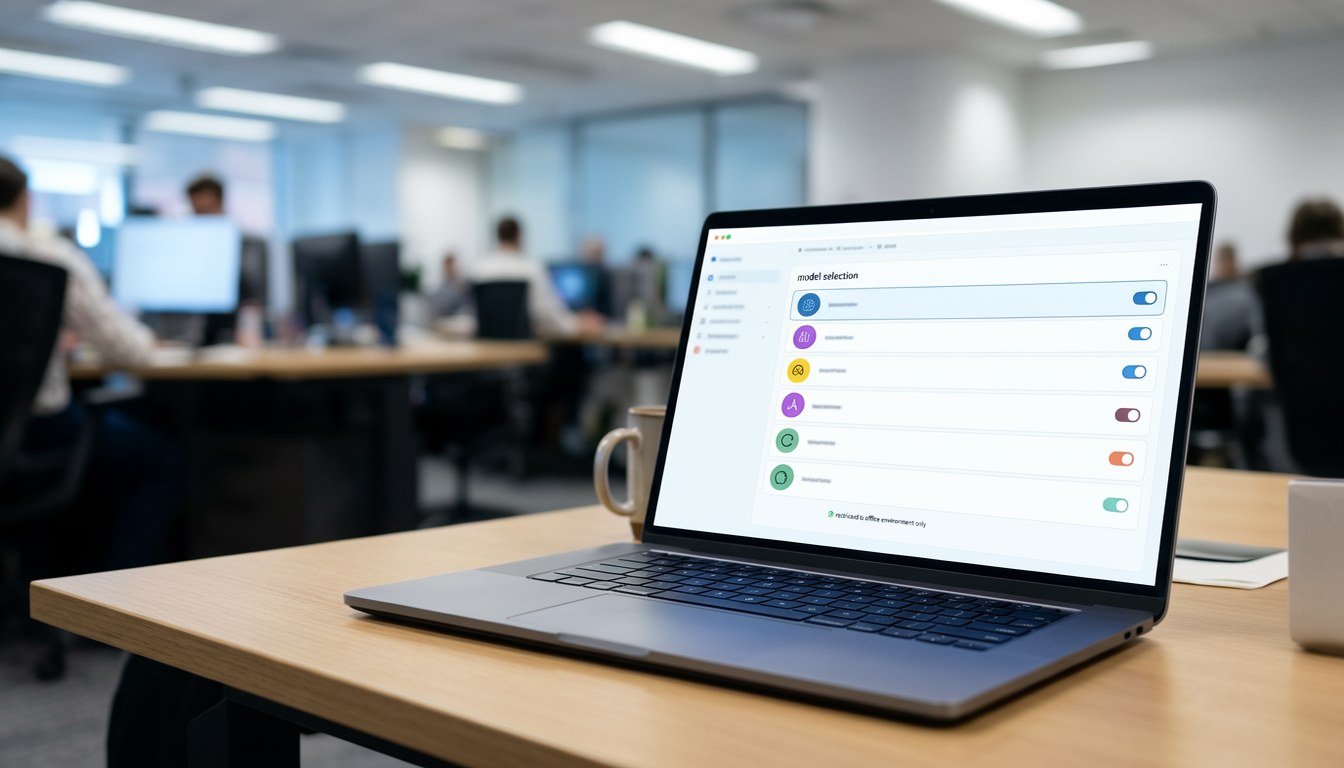
10 月 29 日,豆包工作(Doubao Work)向企業及團隊訂閲客户開放配置三方大模型,首批接入 Kimi 3.1 Pro、GLM 5.3、DeepSeek V4.1 Flash。功能預設直接開啟,按用量扣除企業已有 AI 點數,可指定只喺辦公環境生效。
Mirendil 推出首個模型 Fern 0.1,10M token 上下文、由零開始預訓練,主打 agentic AI R&D,RULER single needle 喺 10M 打 100%,但 agentic coding 落後前沿模型。
OpenAI 嘅 Ted Sanders 講明 GPT-6.1 Terra 喺產品線嘅位置:技術溝通「大概」贏大號 Astra,影像處理同電腦操作大致持平,但多數領域落後,價格大幅便宜。
清華同智譜聯名論文首次公開 GLM-Omni:用虛構球衣號碼做受控實驗,發現模型畫球衣正確率達 72%,純文字回答卻只有 2%。
OpenAI 10月26日推出中級模型 GPT-6.1 Terra,主打快、平、會用電腦,官方稱低推理強度下錯誤率由 53.6% 降至 16.7%。
Jack Dorsey 嘅 Block 宣佈咗一個叫 Dessa 嘅「語音對語音」模型,聲稱訓練資料全部來自人類對話,仲開咗個網站放自己同人講嘅嘢。
TypeSafe 嘅 Jev 開創咗快、平、低延遲嘅「決斷模型」類別,將 LLM 推理時間由 1–3 秒壓到百多毫秒。OpenAI 無做新模型,直接用 ChatGPT Luna 重新配置,9 月 29 日預告、本週全面開放。
Cohere 推 Rerank 5,分 Pro 同 Fast 兩級,32K context 加段落級 Context Focus。Pro 版 BRIGHT 82.2 分、$0.05 每百萬 tokens,數值來自廠商公開資料。
10月22日螞蟻數科發布決策模型LingDT-Decision-1.0,提供4B、27B兩個版本。官方聲稱喺23項開源評測基準綜合評分超Microsoft-Decision-1同Jev 1.13.0,27B版本喺同參數模型中取得最高準確率。所有數據均為廠商自評,未有獨立第三方驗證。
OpenAI 19 日宣佈,GPT-6 系列處理 COBOL、Fortran、Visual Basic 等訓練資料稀缺嘅老舊語言能力明顯提升;但公司強調,測試分高唔代表可以直接上線,生產系統仍需專家審查。