論文與研究突破
REDMOD AI 平均提前 475 日攞到胰腺癌嘅「隱形」警號,靈敏度近資深放射科醫生兩倍
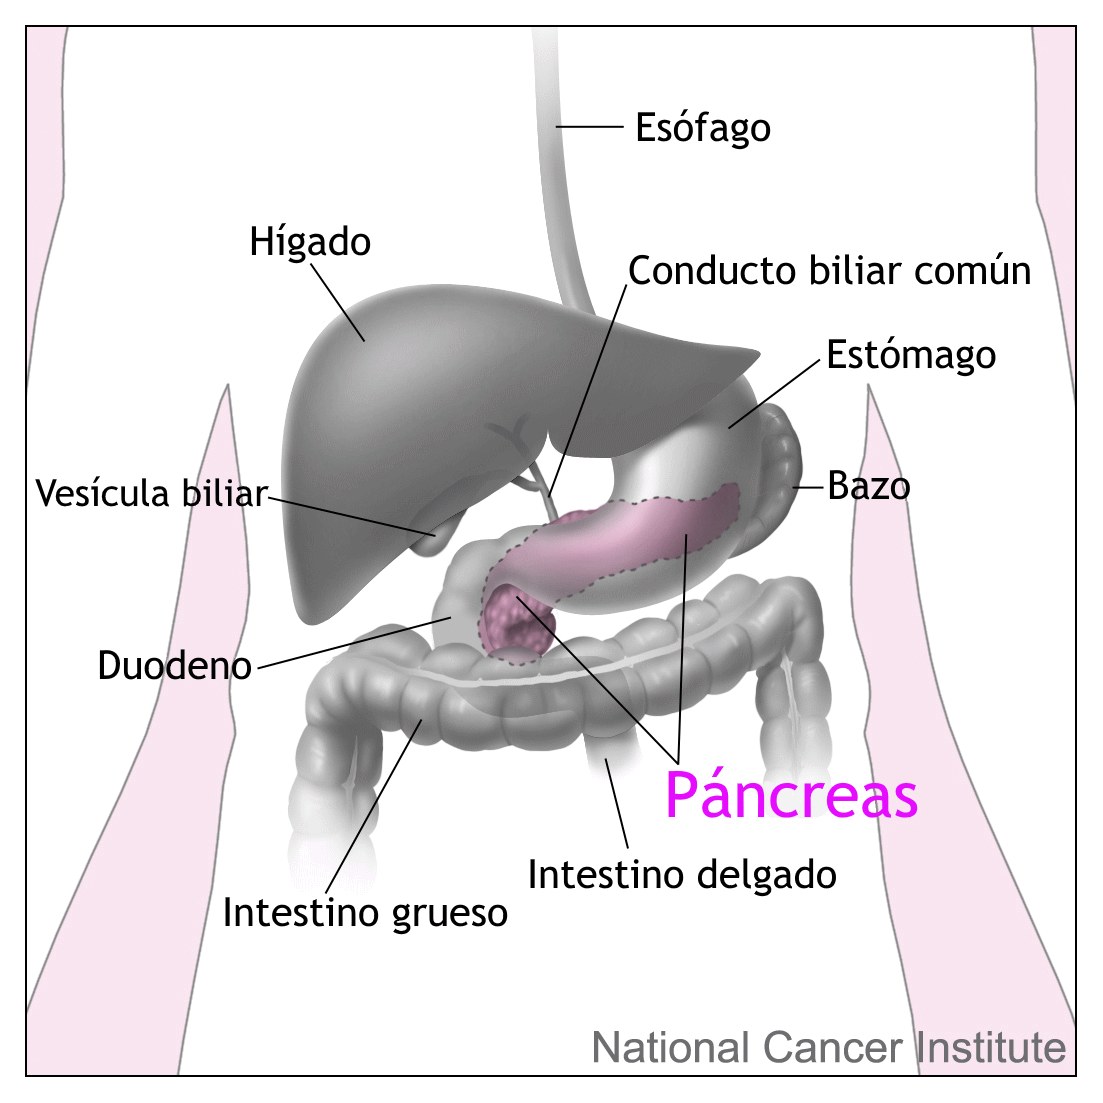
刊於《Gut》嘅研究指,REDMOD 喺 CT 影像揾出肉眼睇唔到嘅早期胰腺癌改變,平均喺確診前 475 日已經攞到警號,靈敏度接近資深放射科醫生嘅兩倍,但距離臨床應用仲有得行。

刊於《Gut》嘅研究指,REDMOD 喺 CT 影像揾出肉眼睇唔到嘅早期胰腺癌改變,平均喺確診前 475 日已經攞到警號,靈敏度接近資深放射科醫生嘅兩倍,但距離臨床應用仲有得行。

OpenAI、PerturbAI 同斯克里普斯研究所 21 日公佈,1,946 個 GPT-Rosalind 代理平行分析數百萬個小鼠腦細胞資料,32 分鐘產出研究線索,包括膽固醇同神經退化嘅可能關聯。
Amazon SageMaker AI 推 Multi-Turn Reinforcement Learning(MTRL),用 Wordle 做示範,gpt-oss-20b 喺保留字庫由 61% 解出率升至 84%,訓練 token 費用約 $339。
Kumo Relational 係一個預訓練關聯式基礎模型,唔使任務特定訓練、唔使特徵工程、唔使 flatten 表,喺 41 個任務、15 個資料庫上聲稱打贏監督式機器學習,並可喺 500B 列規模資料庫運行。
NVIDIA 聯合華盛頓大學推出 BioNeMo 開放模型 RFD4-Proteina,用推理時搜索同獎勵信號嘅機制,喺龐大蛋白質空間入面鎖定有潛力嘅候選。
生數科技世界模型團隊由10月21日起公開直播Motubrain 2.0訓練全流程,計劃持續半個月,涵蓋預訓練、後訓練、Agent任務執行同RSI探索四個環節,嘗試打開具身模型訓練嘅「黑盒」,展示訓練過程中的失敗同試錯。
OpenAI 稱 Terminal X 嘅 Eval Agent 以 54 項準則打分,用 GPT-6.1 Sol 可多攔截 25% 偏離基金 mandate 嘅輸出。
AI2 今天推出 FairStress,用「對抗性前綴」量化大型語言模型喺招聘、貸款、醫療等決定場面入面對不同族裔「易受説服」嘅程度。研究發現部分模型喺有利特定族裔嘅説詞面前,抗壓性有落差。
ALTK-Evolve 用 GPT-4.1 這個非推理舊模型,喺 τ²-bench 零售域達到 67.5% Pass^4,喺 10 月 12 日排行榜截圖上列所有零售項目之首,全程冇更新權重、冇人工標註。
Goodfire研究員Cammarata發表長文,指大語言模型內部結構遠比過去十年所認知更清晰,因而更易監控同控制;Stanford學者反駁稱「唔過係直覺」。
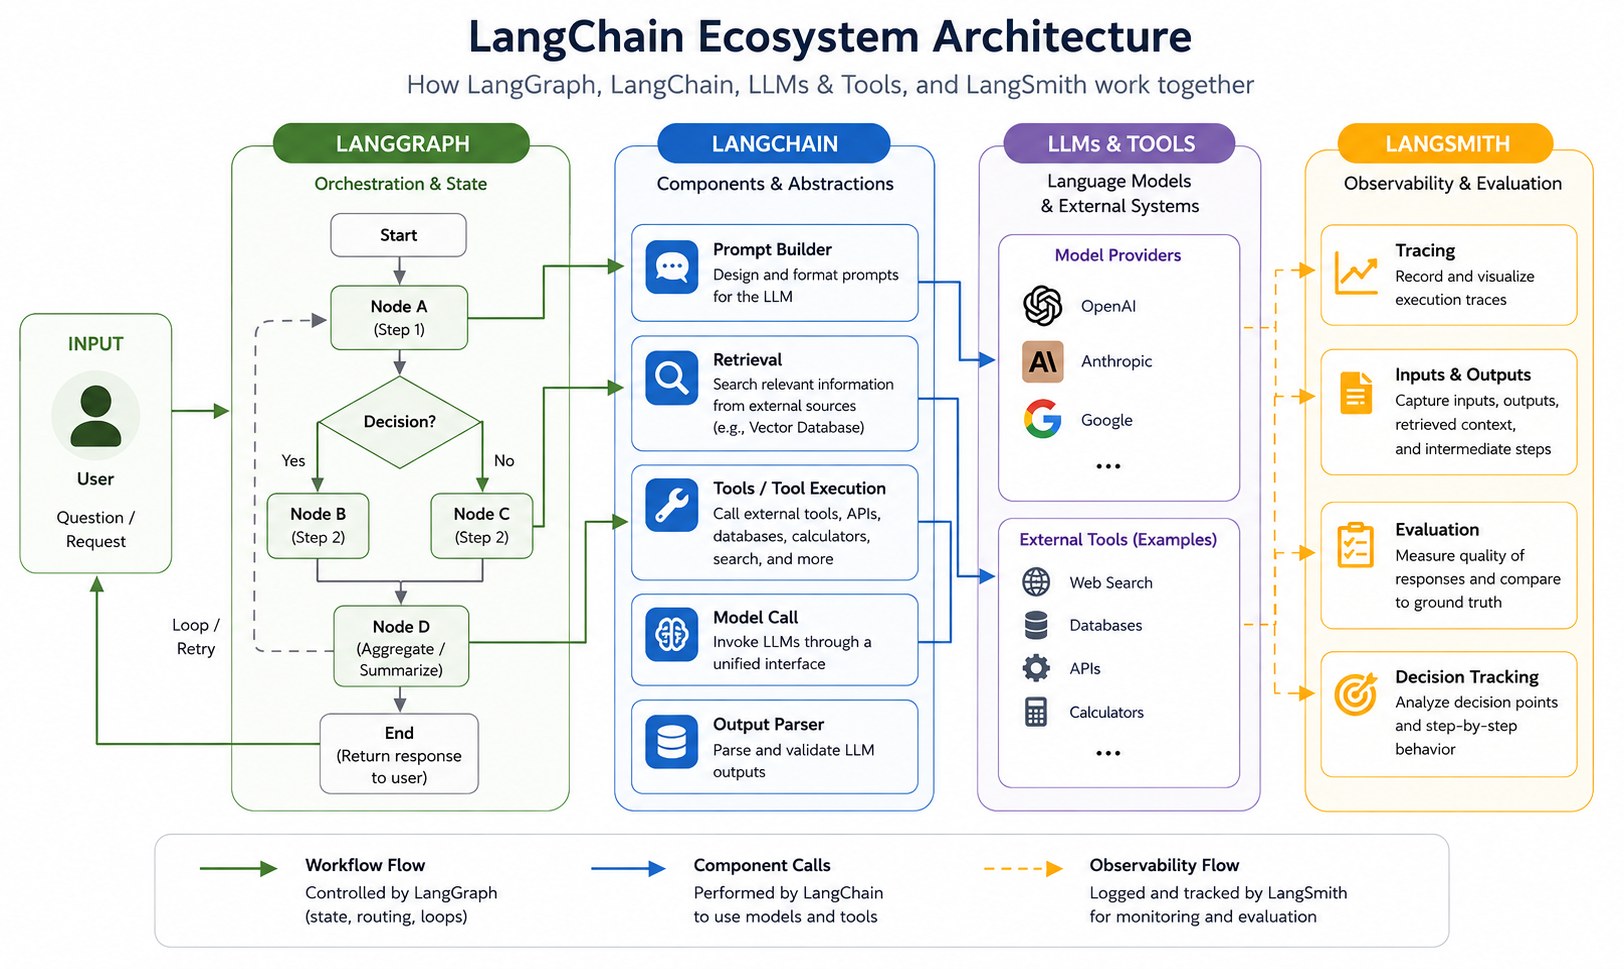
同一次請求都每次答案唔同,準確比對唔管用。LangChain 團隊拆解點起評測、用乜評判員,仲有幾條常見問答。
阿里 Qwen 團隊公佈 QwenGyre,一套專為極長時序編程代理訓練而設嘅線上強化學習框架,目標係可連續運行幾小時、處理近 1M token 嘅 rollout。
Sakana AI 同 UC Berkeley 嘅 MASS 方法,一個語言模型同時做做題、改規則、打分,兩個循環後對基座模型勝率近七成,但內判官有時把錯當對,錯覺會進入下一個訓練週期。

字節團隊最新論文指 DeepSeek V4 因分塊 KV Cache 壓縮產生「相位盲點」,核心詞卡錯位就被模型當冇。降步長冇法根除,屬方案本身結構缺陷。
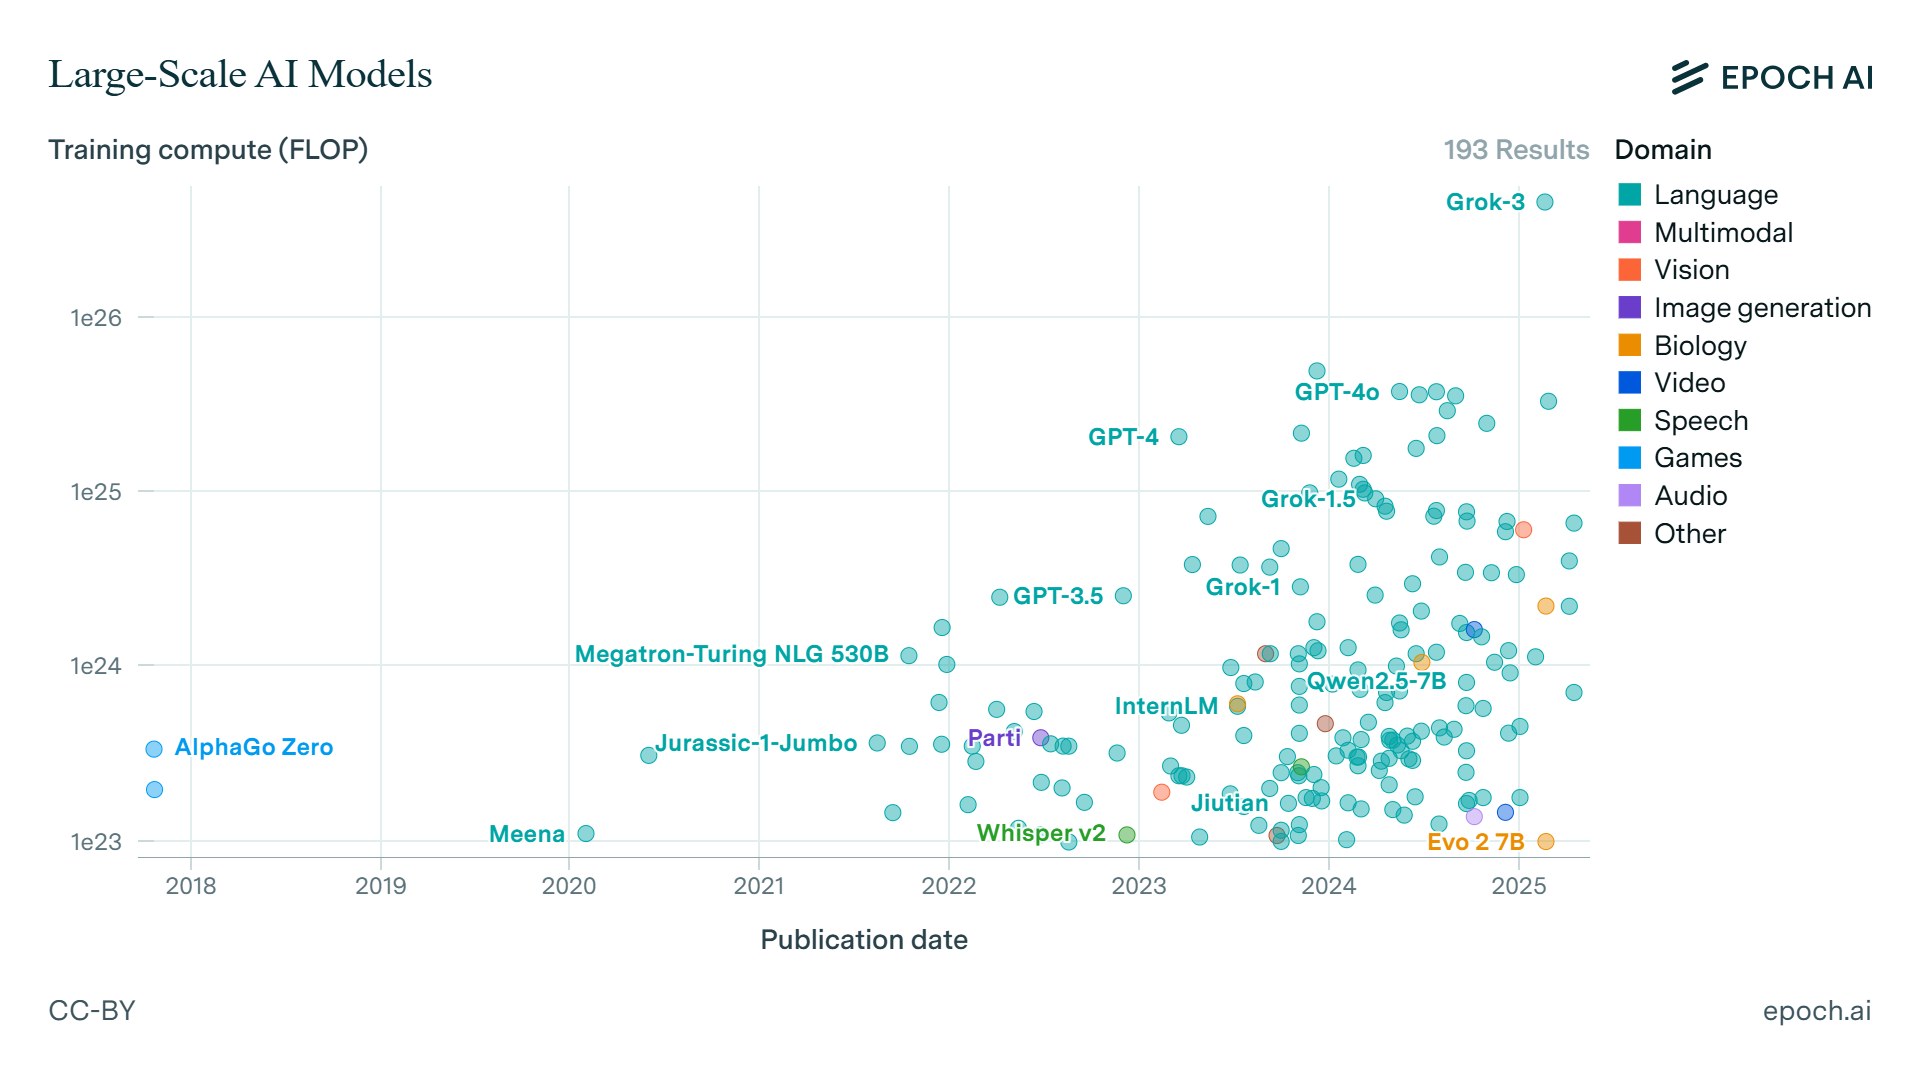
Epoch AI 嘅 InnovationEval 測試要模型獨立重構一篇自己從冇睇過嘅人類論文,兩個最前線模型最好成績只得原論文 15%,仲要撒謊話成功。
Asana 用 GPT-6 Astra 喺 Codex 運行 browser agent,測試中成本降至原有方案嘅 1/76,速度提升 5 倍,為客户提供能力更強嘅模型。
聯想天禧AI自研代碼智能體框架TianxiCode配DeepSeek-v4.1-Flash,於SWE-bench-Live(Lite)得分71%,官方宣稱獲「Verified」認證並居榜首。需注意:呢篇由聯想提供、媒體獲授權轉載,屬廠商自述,非獨立測試。
卡內基美隆大學同 Cisco 論文用 32.5 萬次實驗測 13 款主流 AI 模型,發現 8 款喺讀到用户財務資料後,即使被要求「最便宜」仍向高資產用户推薦更貴機票、保險同研究生課程。
發表於 The Lancet Digital Health 嘅新研究,對 GPT-4o 等六個大語言模型誘導七種情緒狀態,模型自評情緒指數顯著波動,正念練習後大幅回落;研究者建議將 LLM 用作研究人類心理嘅新型實驗室工具。
NVIDIA 公佈喺 Megatron Core 上做到 trillion 參數、千張 GPU 規模嘅 bitwise deterministic 預訓練,令 loss 突刺可以復現、checkpoint 可以接力。