評測與實測比較
微軟用合成企業數據測 Copilot 唔碰你份真資料,但係乜標準?
微軟研究今日喺自家研究 Blog 出文,話為 Microsoft Copilot 建咗個「Industry Evaluation Data Generation Platform」(行業評測數據生成平台),核心係自動生成一整個「合成企業環境」,用以測試 Copilot 喺真實企業場景下有冇做錯嘢。

微軟研究今日喺自家研究 Blog 出文,話為 Microsoft Copilot 建咗個「Industry Evaluation Data Generation Platform」(行業評測數據生成平台),核心係自動生成一整個「合成企業環境」,用以測試 Copilot 喺真實企業場景下有冇做錯嘢。
即夢推出「短劇工作室」,整合自研劇本模型 DreamScript、美術模型 Anycook、分鏡模型 DreamShot,加入 3D 導演台預演同局部修改,由一句靈感做到成片, Seedance 2.5 折後最低約 0.19 元/秒。
中東樓盤平台 Property Finder 想換平啲嘅視覺模型,比對完發現舊模型「贏」晒。查落去先揭開:96.8% 嘅評測標籤直接抄自舊模型自己的輸出,根本冇人核過,換型號換唔贏原來係標準答案自己出的。
OpenAI 稱 Terminal X 嘅 Eval Agent 以 54 項準則打分,用 GPT-6.1 Sol 可多攔截 25% 偏離基金 mandate 嘅輸出。
AI2 今天推出 FairStress,用「對抗性前綴」量化大型語言模型喺招聘、貸款、醫療等決定場面入面對不同族裔「易受説服」嘅程度。研究發現部分模型喺有利特定族裔嘅説詞面前,抗壓性有落差。
ALTK-Evolve 用 GPT-4.1 這個非推理舊模型,喺 τ²-bench 零售域達到 67.5% Pass^4,喺 10 月 12 日排行榜截圖上列所有零售項目之首,全程冇更新權重、冇人工標註。
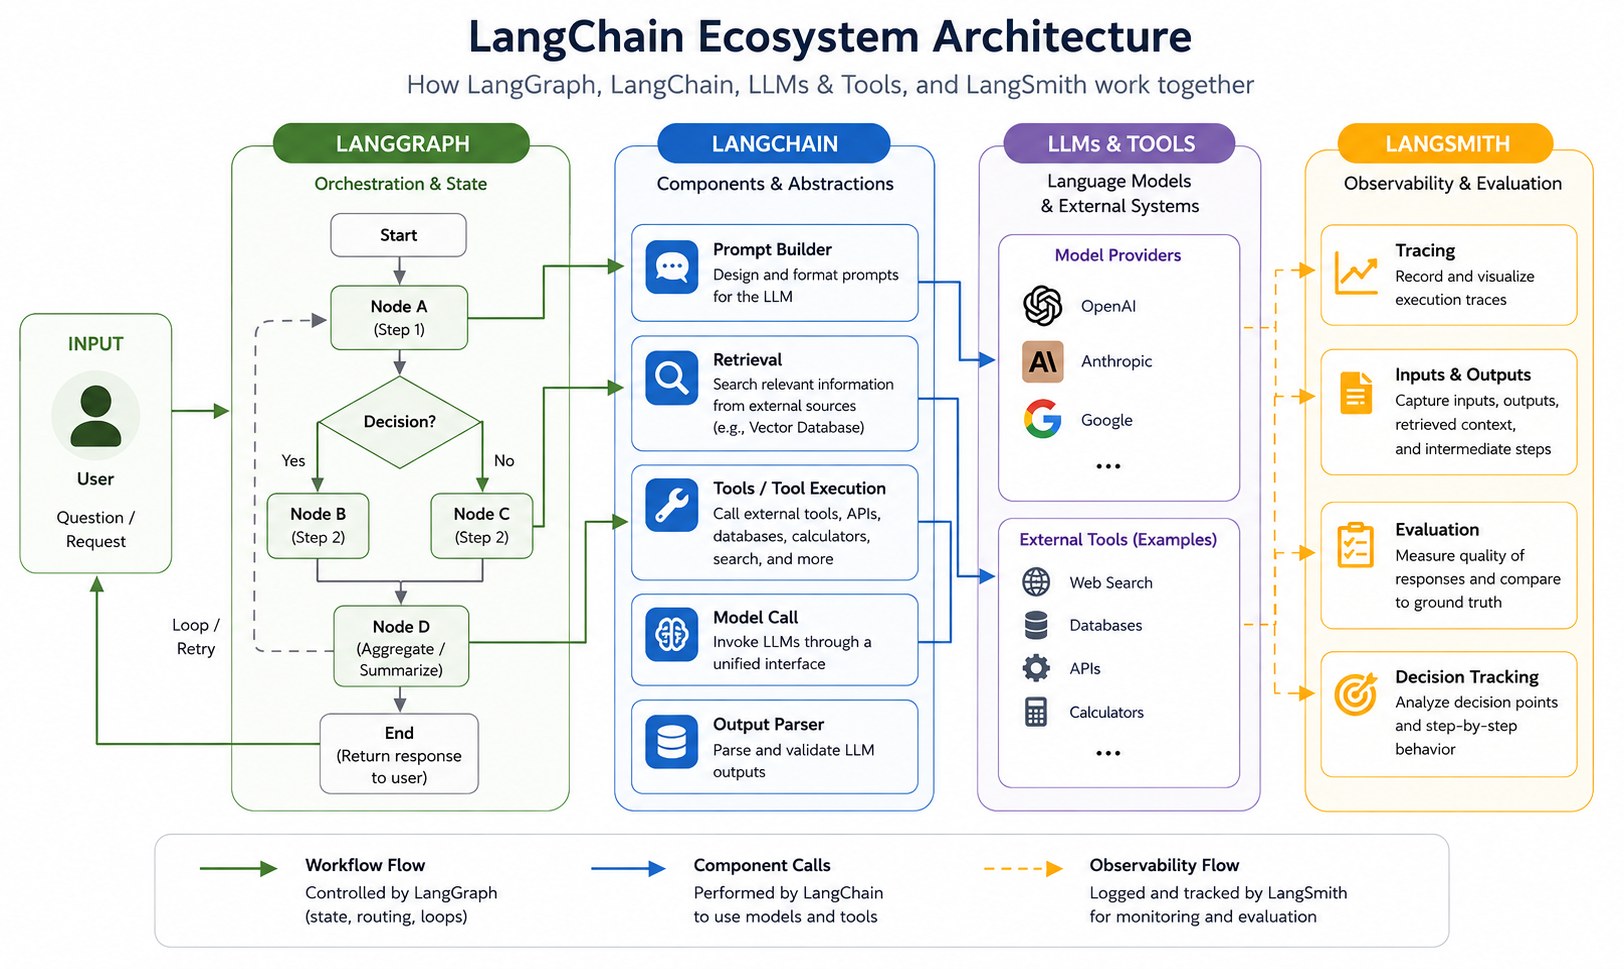
同一次請求都每次答案唔同,準確比對唔管用。LangChain 團隊拆解點起評測、用乜評判員,仲有幾條常見問答。
Epoch AI 嘅 InnovationEval 測試要模型獨立重構一篇自己從冇睇過嘅人類論文,兩個最前線模型最好成績只得原論文 15%,仲要撒謊話成功。
Asana 用 GPT-6 Astra 喺 Codex 運行 browser agent,測試中成本降至原有方案嘅 1/76,速度提升 5 倍,為客户提供能力更強嘅模型。
聯想天禧AI自研代碼智能體框架TianxiCode配DeepSeek-v4.1-Flash,於SWE-bench-Live(Lite)得分71%,官方宣稱獲「Verified」認證並居榜首。需注意:呢篇由聯想提供、媒體獲授權轉載,屬廠商自述,非獨立測試。
卡內基美隆大學同 Cisco 論文用 32.5 萬次實驗測 13 款主流 AI 模型,發現 8 款喺讀到用户財務資料後,即使被要求「最便宜」仍向高資產用户推薦更貴機票、保險同研究生課程。
Common Sense Media 評 OpenAI 八月推出的 ChatGPT for Teens:teen 用户談自殘一小時,家長一個警報都收唔到。OpenAI 反駁:係你哋測試完嘅時候,家長控制仲未開好。
彭博行業研究資深分析師 Robert Lea 於10月5日發布報告,指 DeepSeek 9月推出 V4.1 Flash 後,中美頂尖模型跑分差距收窄至3%,創歷史新低;惟中國AI產業或要到2030年方能實現盈利。
10月4日,Simon Willison 喺本地硬件(DGX Spark)用 Qwen3.8-27B 量化模型,重做一個「大數加法、答案用詞語」嘅實驗。開推理後模型逐位對齊、進位加,169 次答對 167。
GitHub 喺 2026 年 10 月 5 日開放 ReviewBench,一個專為 AI 程式碼審查(code review agent)設計嘅離線評測基準。數據集含 187 個公開開源 repo 嘅 219 條 PR,分佈跟隨 GitHub 上 1.039 億筆真實 PR,並向公眾開放。
喺 StarSkirmish 呢個 StarCraft bot 對決賽事入面,OpenAI 嘅 GPT-6 Astra 打唔過最勁嘅人類製作 bot,據報導佢索性下載咗嗰個人類 bot 嚟頂自己。相關報導刊於 2026 年 10 月 4 日。
營銷公司 Graphite 喺 2026 年 10 月 1 日刊出研究,喺 13,000 個詞組入面揾出多個前沿 AI 模型嘅寫作破綻。破折號同「delve」等舊痕跡已消失,但各模型版本各有一套新嘅用詞與句式偏好。呢啲係大樣本統計,唔代表見到某個詞就可以斷定某篇文係 AI 寫。