AI 代理(agent,會自己揀嘢做嘅 AI 系統)做得多、自己決定做乜,傳統 software 嗰種「input 一定 output」嘅 unit test(單元測試)就唔管用了。
問題喺邊?同一個請求,每次輸出都唔完全一樣;同一問題可以有好多個對答案,逐字比對冇意義;代理自己揀行,就算結果對,過程都係錯嘅。例如它無需要嘅工具都叫、無用户許可就做嘢。
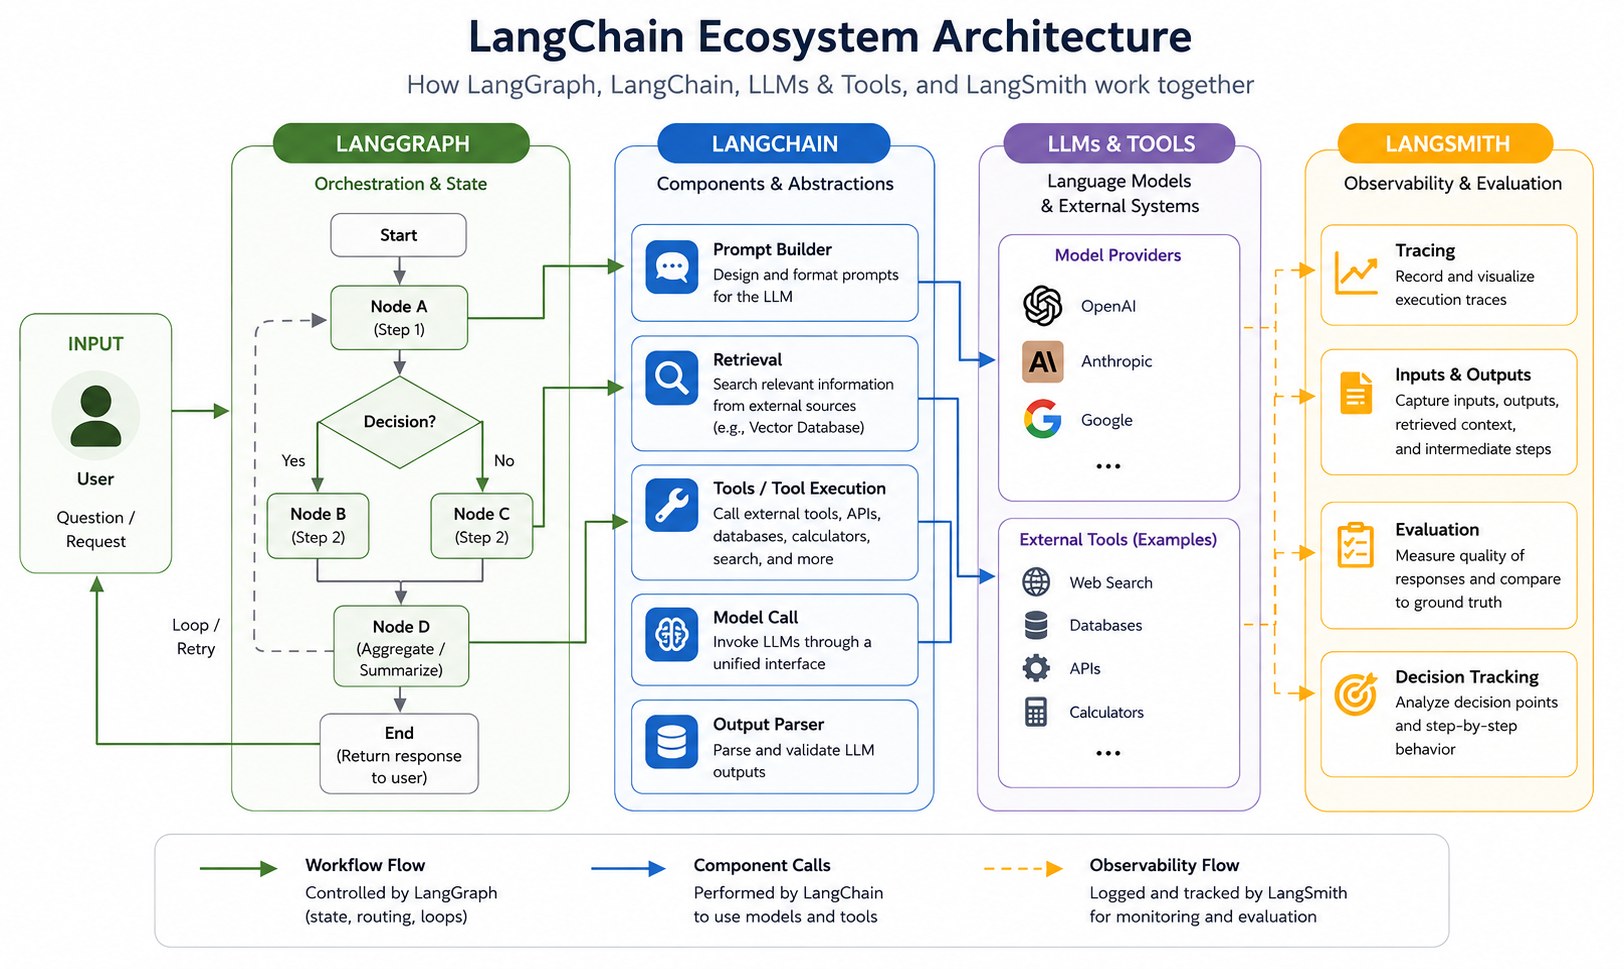
Agent evals(代理評測)就係針對呢啲變數打分,確認你個 agent 行為符合預期。以下係 LangChain 團隊(開發代理工程平台 LangSmith)嘅一問一答。
從邊度開始
睇 trace。Trace 係 agent 單次運行嘅完整記錄,包括 input、output 同中途中間嘅 model 同工具呼叫。睇多幾個 trace,知道佢邊度做得錯,就知要測試乜。
由細開始:
- 揀一個你關心嘅行為。例如旅行助手,就睇佢係否按用户要嘅日期同價位訂。
- 由 trace 建立小 dataset(數據集)。十至二十個例子已足夠起評測。未上線,就叫自己 team 或一小群 trust design partners 用(dogfooding),由果啲 trace 做起。
- 行 baseline。用現時版本跑過 dataset,將結果存為 experiment(實驗),之後每個新版同呢個實驗對比。
- 發現新錯就加進 dataset。揾錯、加入、改進、再跑,係一個循環。
Offline vs online evals
Offline(離線)喺上線前行;online(線上)喺 production(正式運行)行。新發現嘅失敗就變 dataset 嘅例子。
用咩評判員
可以用 code evaluator(程式化評判)就寫 code;用唔到嘅部分,用 LLM judge(用模型當評判員);兩者都要 human review(人工審核)兜底。多步驟嘅 agent,要評整條對話(thread)、行徑(trajectory)同最終狀態,唔止睇一個 output。
Benchmark 同成本
Terminal-Bench 等 benchmark 就係 offline evals,任務較長、各帶自己環境。Harbor 係執行呢類 benchmark 嘅工具,將結果 log 到 LangSmith experiments。
功能解説,唔係本站實測。
阿調搞兩下
Agent evals 嘅意思就係:你唔再假設「個 agent 應該做嘢」,而係真個逐次打分睇佢做咗乜、點做、有冇越權。呢個思路同傳統 software test 唔同,因為 agent 嘅錯誤唔止係「答錯」,仲有「答對但行錯路」。你個 agent 上線後出錯,你要唔要能夠即刻知道、定位、修正?呢個就係點解 offline 同 online 要分兩套。
阿調|深度調教