金融科技公司 Block(Square 同 Cash App 母公司)近日公佈咗一個新嘅 AI 語音模型,叫 Dessa。Block 指,Dessa 係首個完全用人類語音(human speech)訓練、冇用任何文字資料、由零開始建構嘅 AI 模型。
直接處理音訊,唔再轉文字
傳統語音 AI 嘅做法係先把音訊轉做文字(speech-to-text),再用文字模型處理,最後先合成返語音。Dessa 唔做呢步。佢直接將語音當音訊處理,聲稱可以即時識別情緒、反諷(sarcasm)、笑聲同停頓(pauses)。
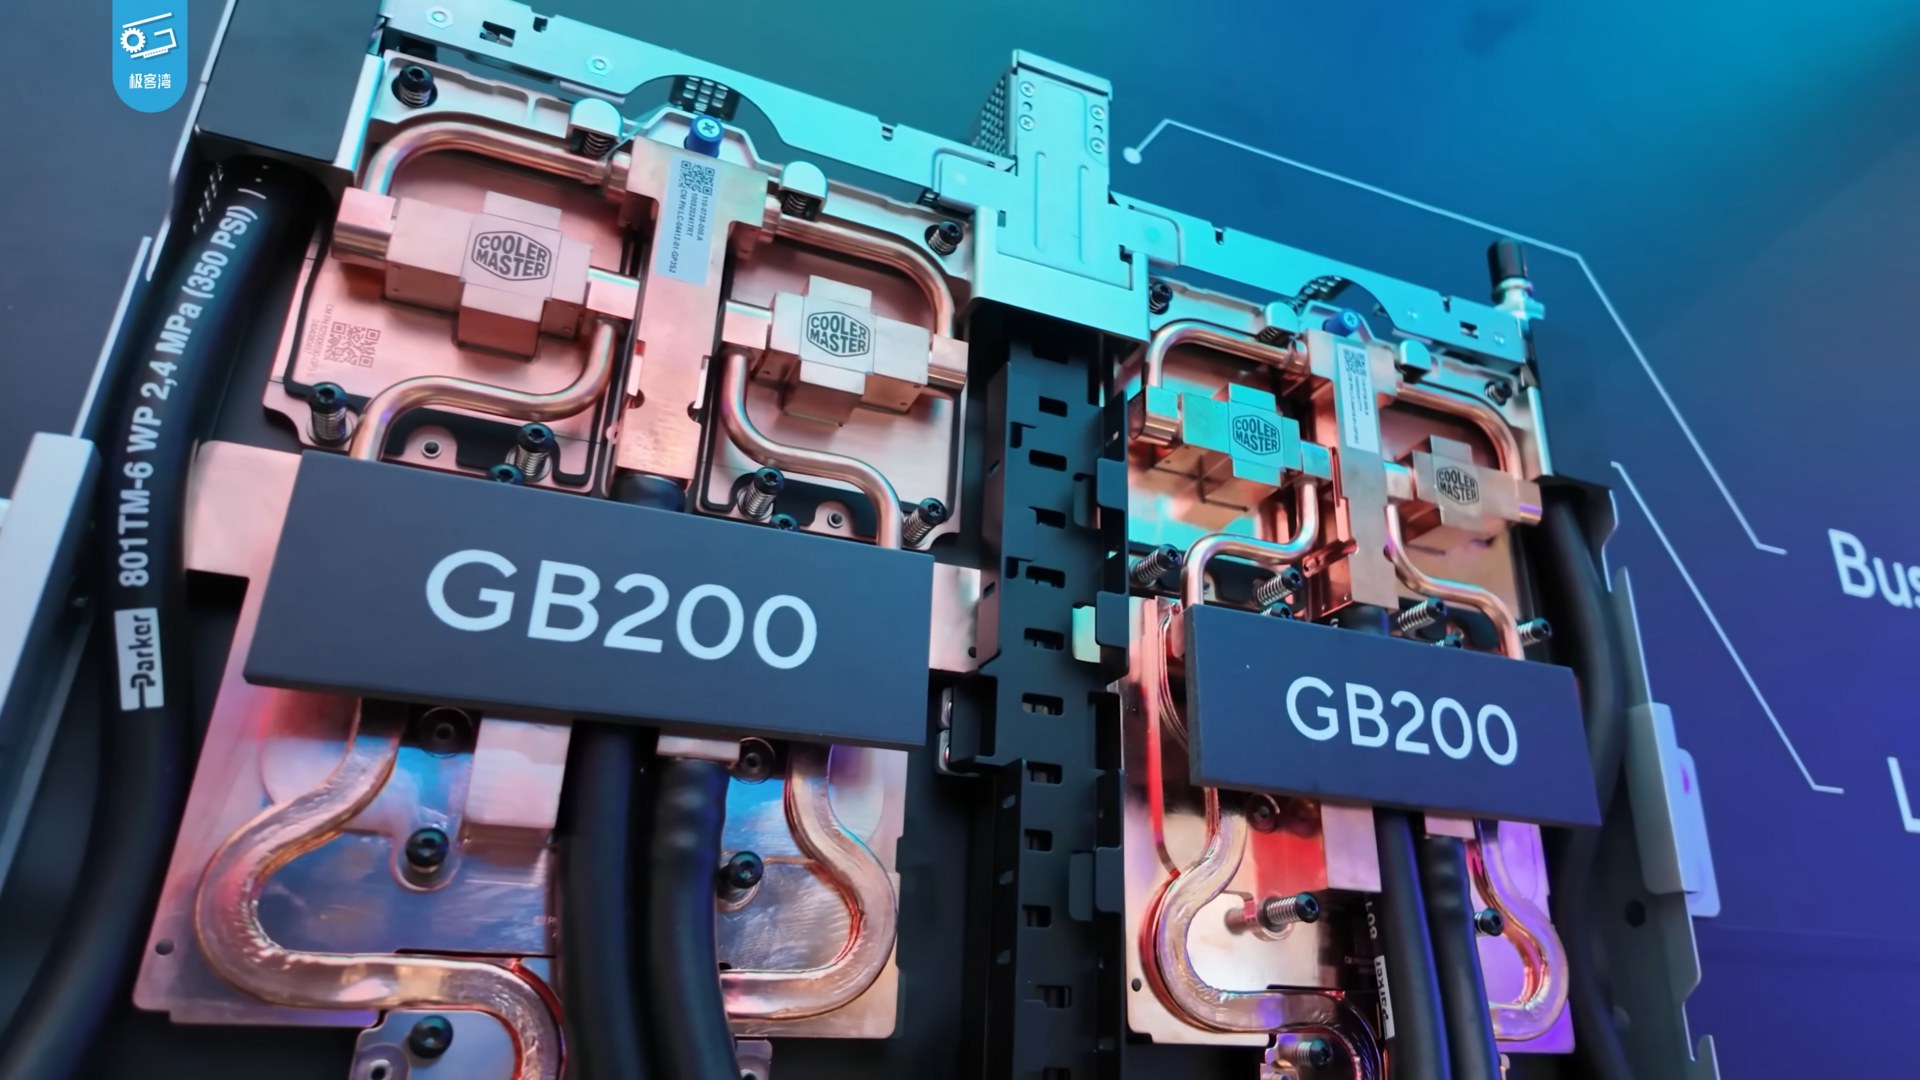
模型支援全雙工(full-duplex)通訊,即係可以同時聽同講,唔使輪流。據 Block 話,Dessa 可以喺 MacBook Pro M4 Max 本地運行,訓練用嘅硬件係單台 NVIDIA GB200 NVL72。
點解要自研?
Block 表示,佢哋研發 Dessa 嘅動機有三個:出於好奇、希望改善人同 AI 之間嘅溝通、同埋安全顧慮。佢哋指現行嘅語音 AI 會忽略情緒線索(emotional cues),呢點對人機溝通同安全都有潛在影響。
冇開,先揾安全研究者試
Dessa 暫時未對外開放。團隊而家先揾 AI 安全研究者測試模型有冇預期外嘅風險(unexpected risks),有興趣嘅人可以填表登記。
呢路嘢冇人做得過?
語音 AI 嘅情緒識別其實唔算新嘢。Hume AI 喺 2024 年 3 月推出 EVI(Empathic Voice Interface);Kyutai 喺 2024 年 9 月有 Moshi;LAION 嘅 Open Empathic 項目由 2023 年底開始用開源音訊數據集訓練共情語音合成模型;OpenAI 喺 2025 年 6 月重新設計咗 ChatGPT 嘅 Advanced Voice Mode,改善語調、停頓同共情表達。
Block 話自己係「首個完全用人聲訓練、冇文字資料」嘅,呢個同上面嘅模型有乜分別,材料冇講。
阿調搞兩下
Block 係金融公司,唔係 AI 研究機構。佢話自己研發係出於「好奇」,我聽覺好。
「完全用人聲訓練」呢句,技術上有幾重意思:訓練語料係咪純音訊?模型架構係咪冇文本處理層?而家呢啲都係 Block 自己講。
另外,語音 AI 能識別情緒唔代表佢真正「理解」情緒,同埋推理能力先係決定答案質素嘅關鍵。呢點唔單止係技術問題,仲涉及產品設計同信任。
阿調|深度調教