算力與部署
OpenAI 模型同 Codex 入 Google Cloud Marketplace
OpenAI 同 Google Cloud 宣佈將 frontier models 及 Codex workflows 帶入 Gemini Model Garden,經 Google Cloud Marketplace 提供。

OpenAI 同 Google Cloud 宣佈將 frontier models 及 Codex workflows 帶入 Gemini Model Garden,經 Google Cloud Marketplace 提供。
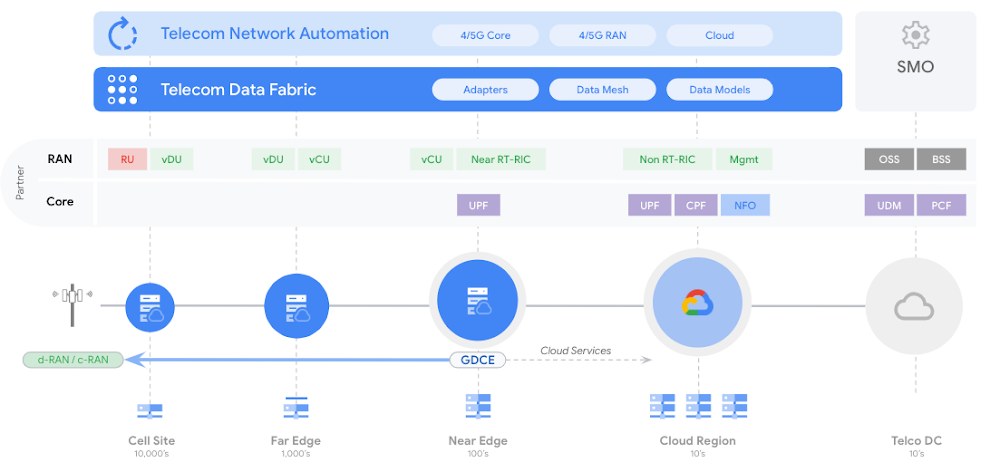
Google Cloud 同 NVIDIA 公佈 Vera Rubin 基礎設施(A5X 實例)下月轉正式可用,計劃擴展到歐洲,並逐步部署最多 96 萬張 Rubin GPU;首個用家係 AlphaGo 創辦人 David Silver 嘅 Ineffable。
NVIDIA 喺官方 blog 話,佢哋歐洲嘅雲合作夥伴正擴展區域算力。Nscale 稱用 NVIDIA DSX 平台,喺同一預設電力預算下多調度 37% GPU、聚合推理吞吐升近五成。
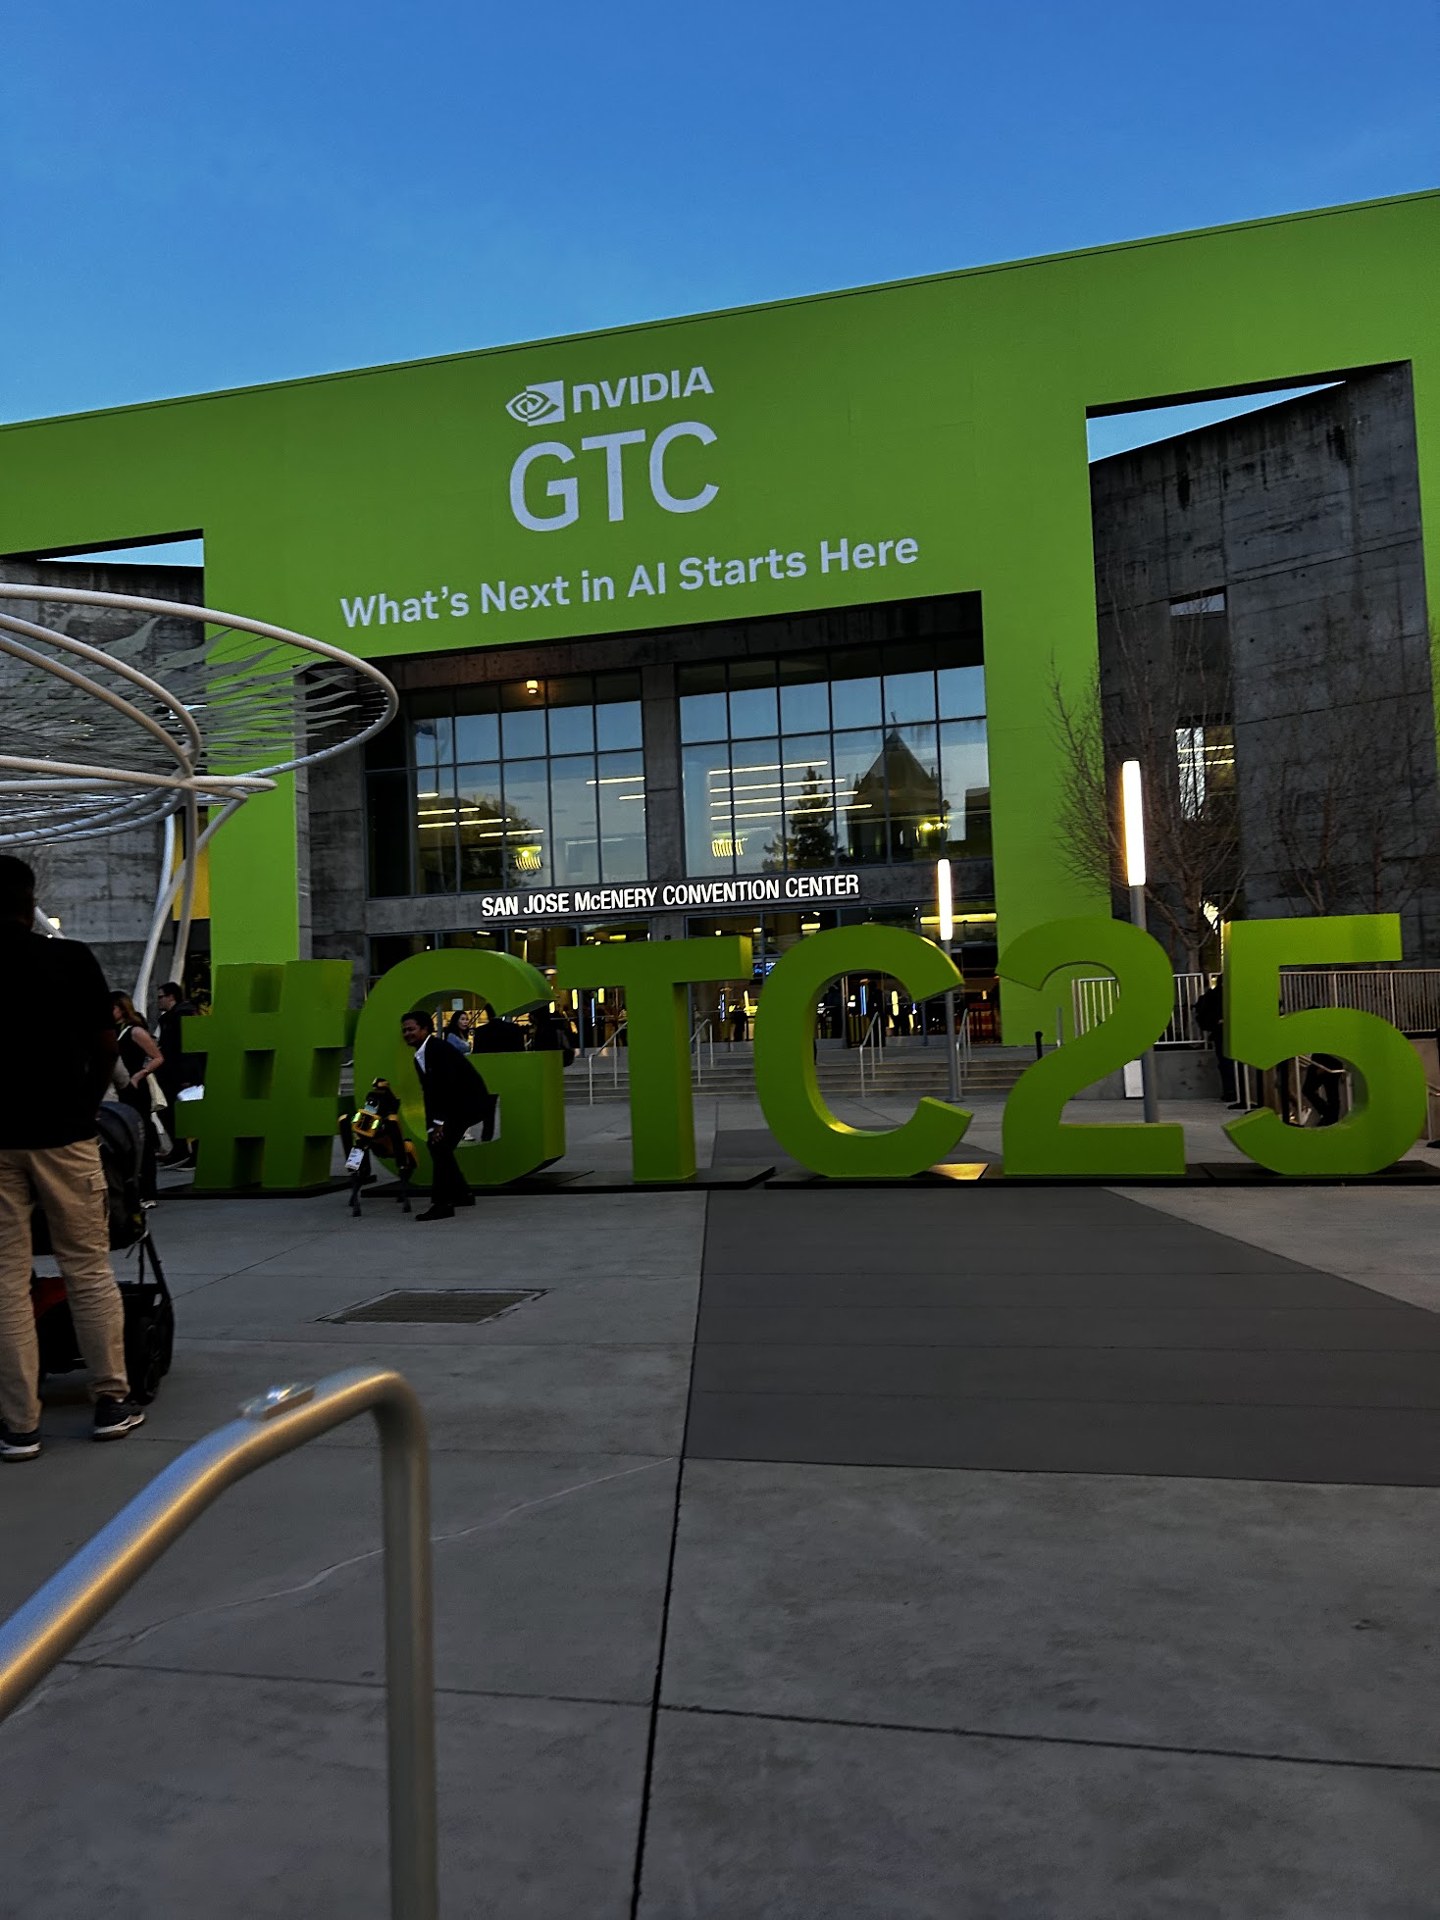
GTC Berlin 上,NVIDIA 一次過推 RTX Spark、DGX Spark、DGX Station 三條本地 AI 產品線,主打數據唔離開裝置嘅私隱路線;RT
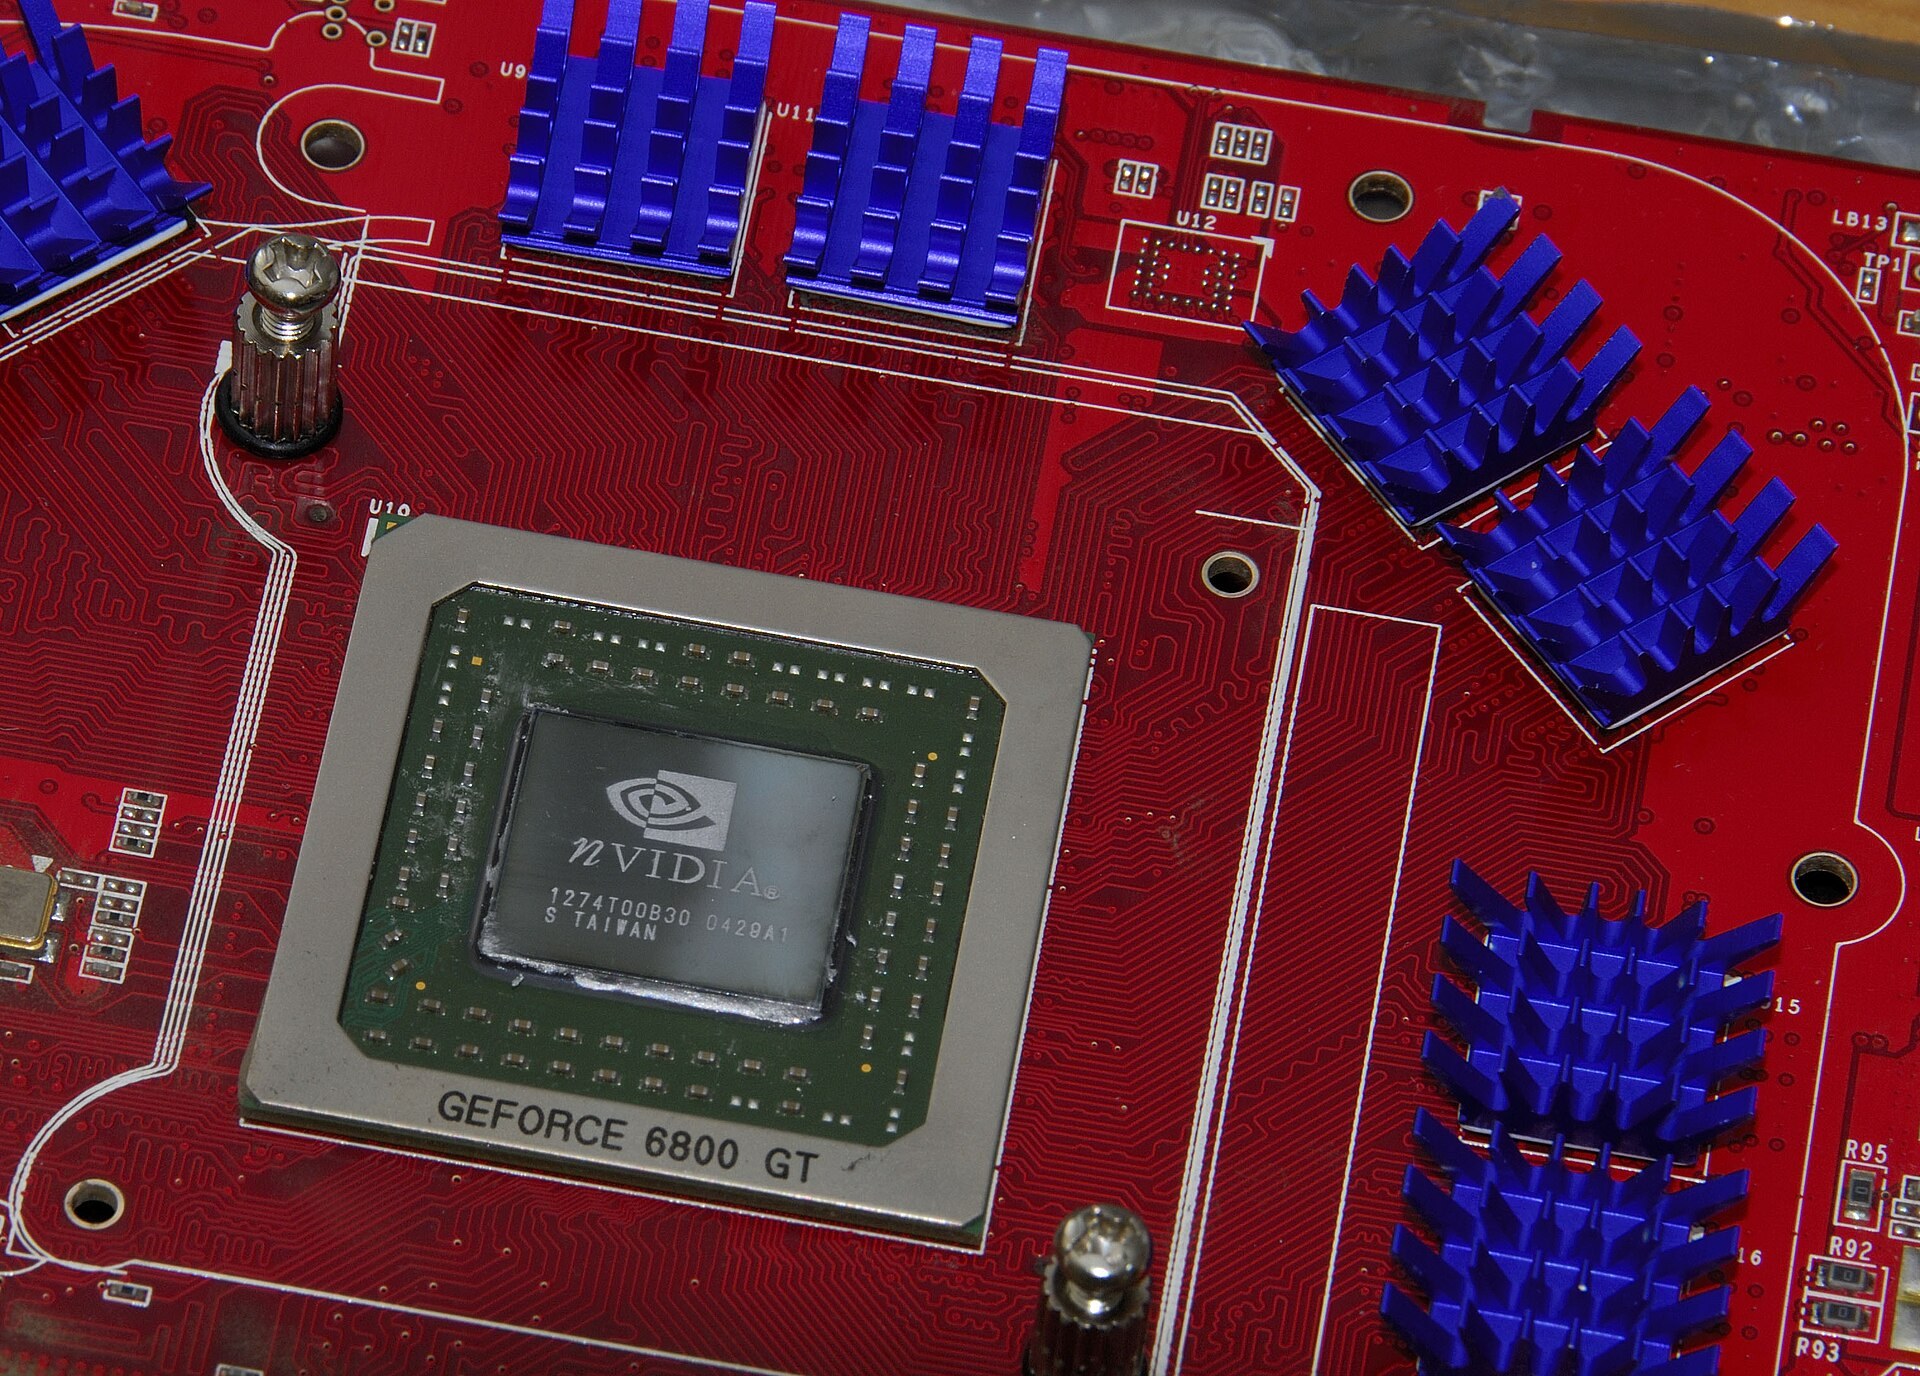
NVIDIA 今日宣佈 cuDSS 正式進入全面可用(GA),將工程同科學模擬入面最費算力的「大型稀疏系統求解」搬上 GPU。Applied Materials、COMSOL、Dassault Systèmes 等已接入,廠商自報最高提速 10 倍。
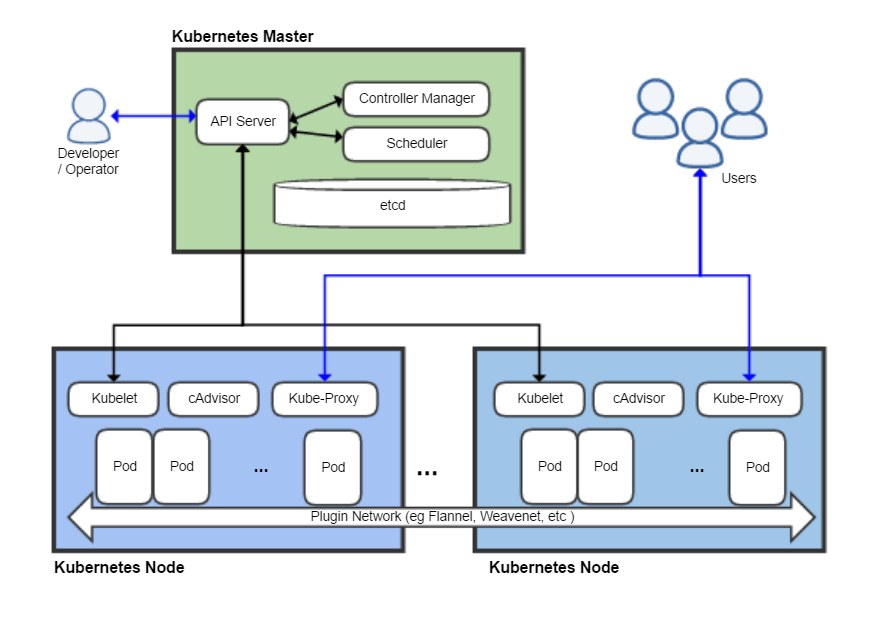
llm-d 1.0 係一個跑喺 Kubernetes 上面嘅開源推理棧,支援 vLLM、SGLang 兩個推理引擎,加多租户流量控制、零停機升級同 agent-aware routing,一個 stack 同時管 TPU 同 GPU。
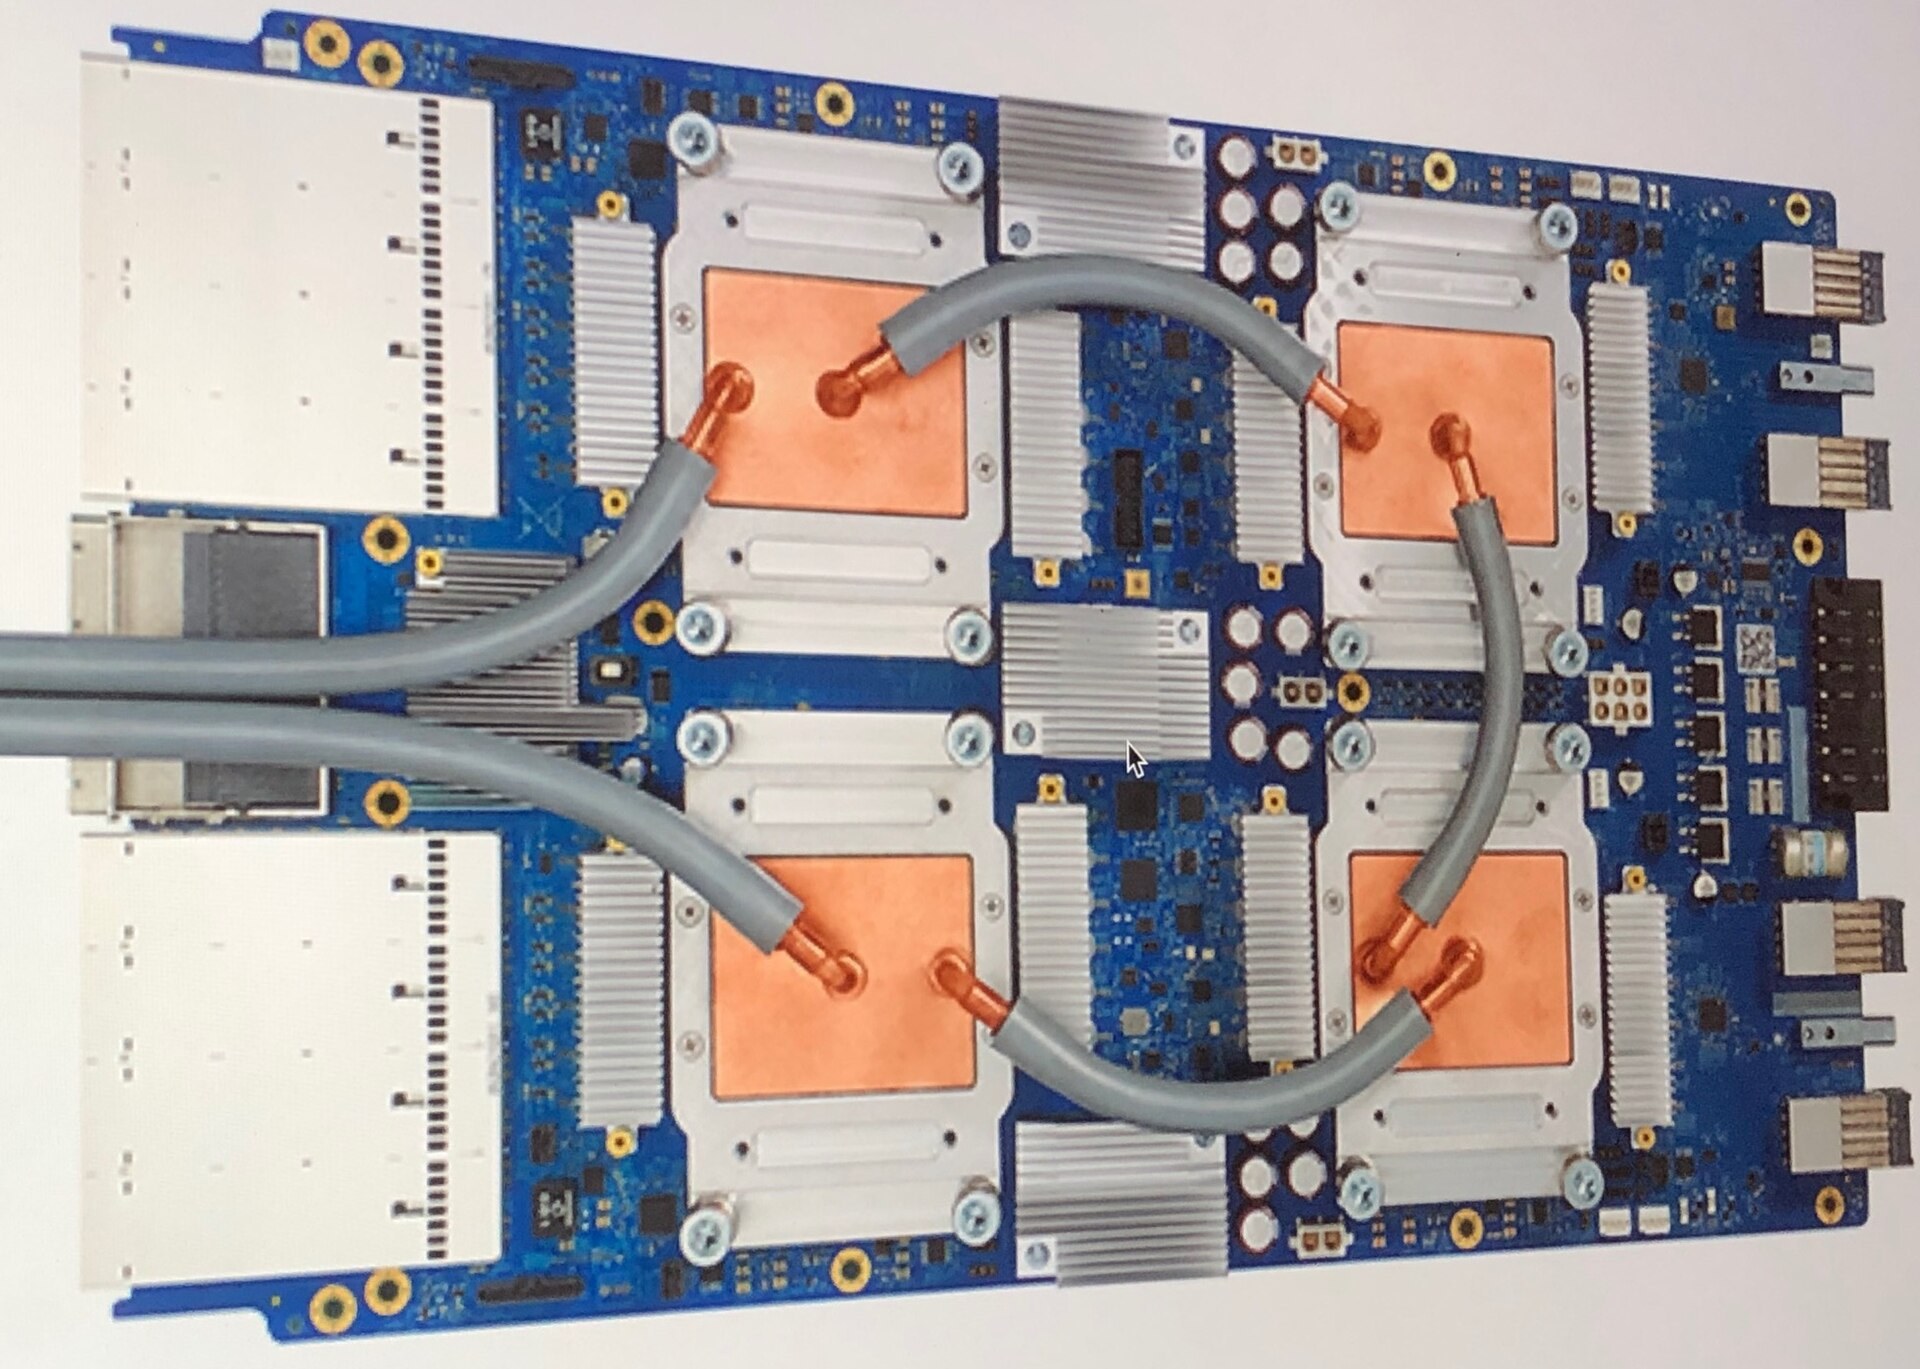
Google 喺 PyTorch 2026 大會同 Meta PyTorch 團隊公佈 TorchTPU,目標打破 Nvidia CUDA 壟斷。開發者用熟練 API 即可將模型搬去 Google Cloud TPU 訓練同部署。
Humming 係通用高性能量化推理 kernel 庫,支援 NVIDIA Turing 起同 CUDA 兼容裝置,統一處理密集與 MoE 嘅多種量化組合,官方話性能明顯贏過 vLLM Marlin、FlashInfer、DeepGEMM。

是石科技喺2026 CCF高性能計算大會發佈分佈式推理調度框架TokenFleet,含三個核心模塊。延遲同吞吐量數字全部來自公司演講材料,獨立驗證仍係空白。
Fireworks 同 fal 聯手公佈 EAGLE-4 技術分析及公開評測集 Prompt Enhancement SpecBench(400 樣本、18 個數據集),主打小批次下為影像影片生成嘅「prompt 擴寫」減延遲。

大摩最新報告點名微軟 Maia 300 係今次 Open Compute Project 峰會最重要新進展,預計 2027 年正式部署;輝達同 AMD 系統級新品有限,觀察重點轉到 PTFE、次世代互連與液冷接頭。
亞馬遜 19 日推出 TorchNeuron,宣稱開發者只需改一次設定,就能將 PyTorch 寫嘅 AI 程式直接搬上自家 Trainium 晶片,免費開源;官方指已有超過 30 家早期客户,但第一版仍有部分功能未支援。
i14 嘅 linear attention 模型 Laplace 3B 喺 AWS Trainium2 用原生 PyTorch 訓練同部署,recurrent state 固定 29.5MB 唔隨 context 增長。
Google 開源 TorchTPU、Amazon 推出 TorchNeuron,AI 應用可唔使重寫程式即由 Nvidia GPU 轉去自家晶片同雲端。
vllm-torchtpu 係 Inferact 同 Google 合作嘅 vLLM 新後端,基於 TorchTPU 堆疊,讓 vLLM 支援嘅模型直接喺 Google Cloud TPU 上服務,唔使改模型代碼。
Amazon 今個月中起,加拿大用户喺 Amazon Bedrock 上可以透過跨區推理(Cross-Region Inference)用到 OpenAI GPT-5.6、GPT-6 同 GPT-6.1 系列模型,推理處理保持喺北美。
Google 同 Meta 聯合開源 TorchTPU,TPU 自此成為 PyTorch 嘅原生後端,取代 PyTorch/XLA;Hugging Face 生態亦唔再需要 Optimum TPU。
DeepSeek 10 月 20 日開源生產級推論框架 DeepInfer,同時放 deepseek-recipe;官方 README 明列此版只含離線推論,KV 快取、Prefill/Decode 分離部署等關鍵元件全部缺席。
Perplexity喺Mac app推「本地優先」模式,令Computer嘅規劃、推理同檔案處理全部喺你裝置上跑,斷咗網都運作。要求Apple Silicon加至少36GB統一記憶體,向Pro、Max同Enterprise訂閲者開放。
IBM、Red Hat、Google 聯手維護嘅開源 llm-d 正式推出 1.0,主打多租户管理、零停機升級,想減少對單一雲端供應商嘅依賴。