
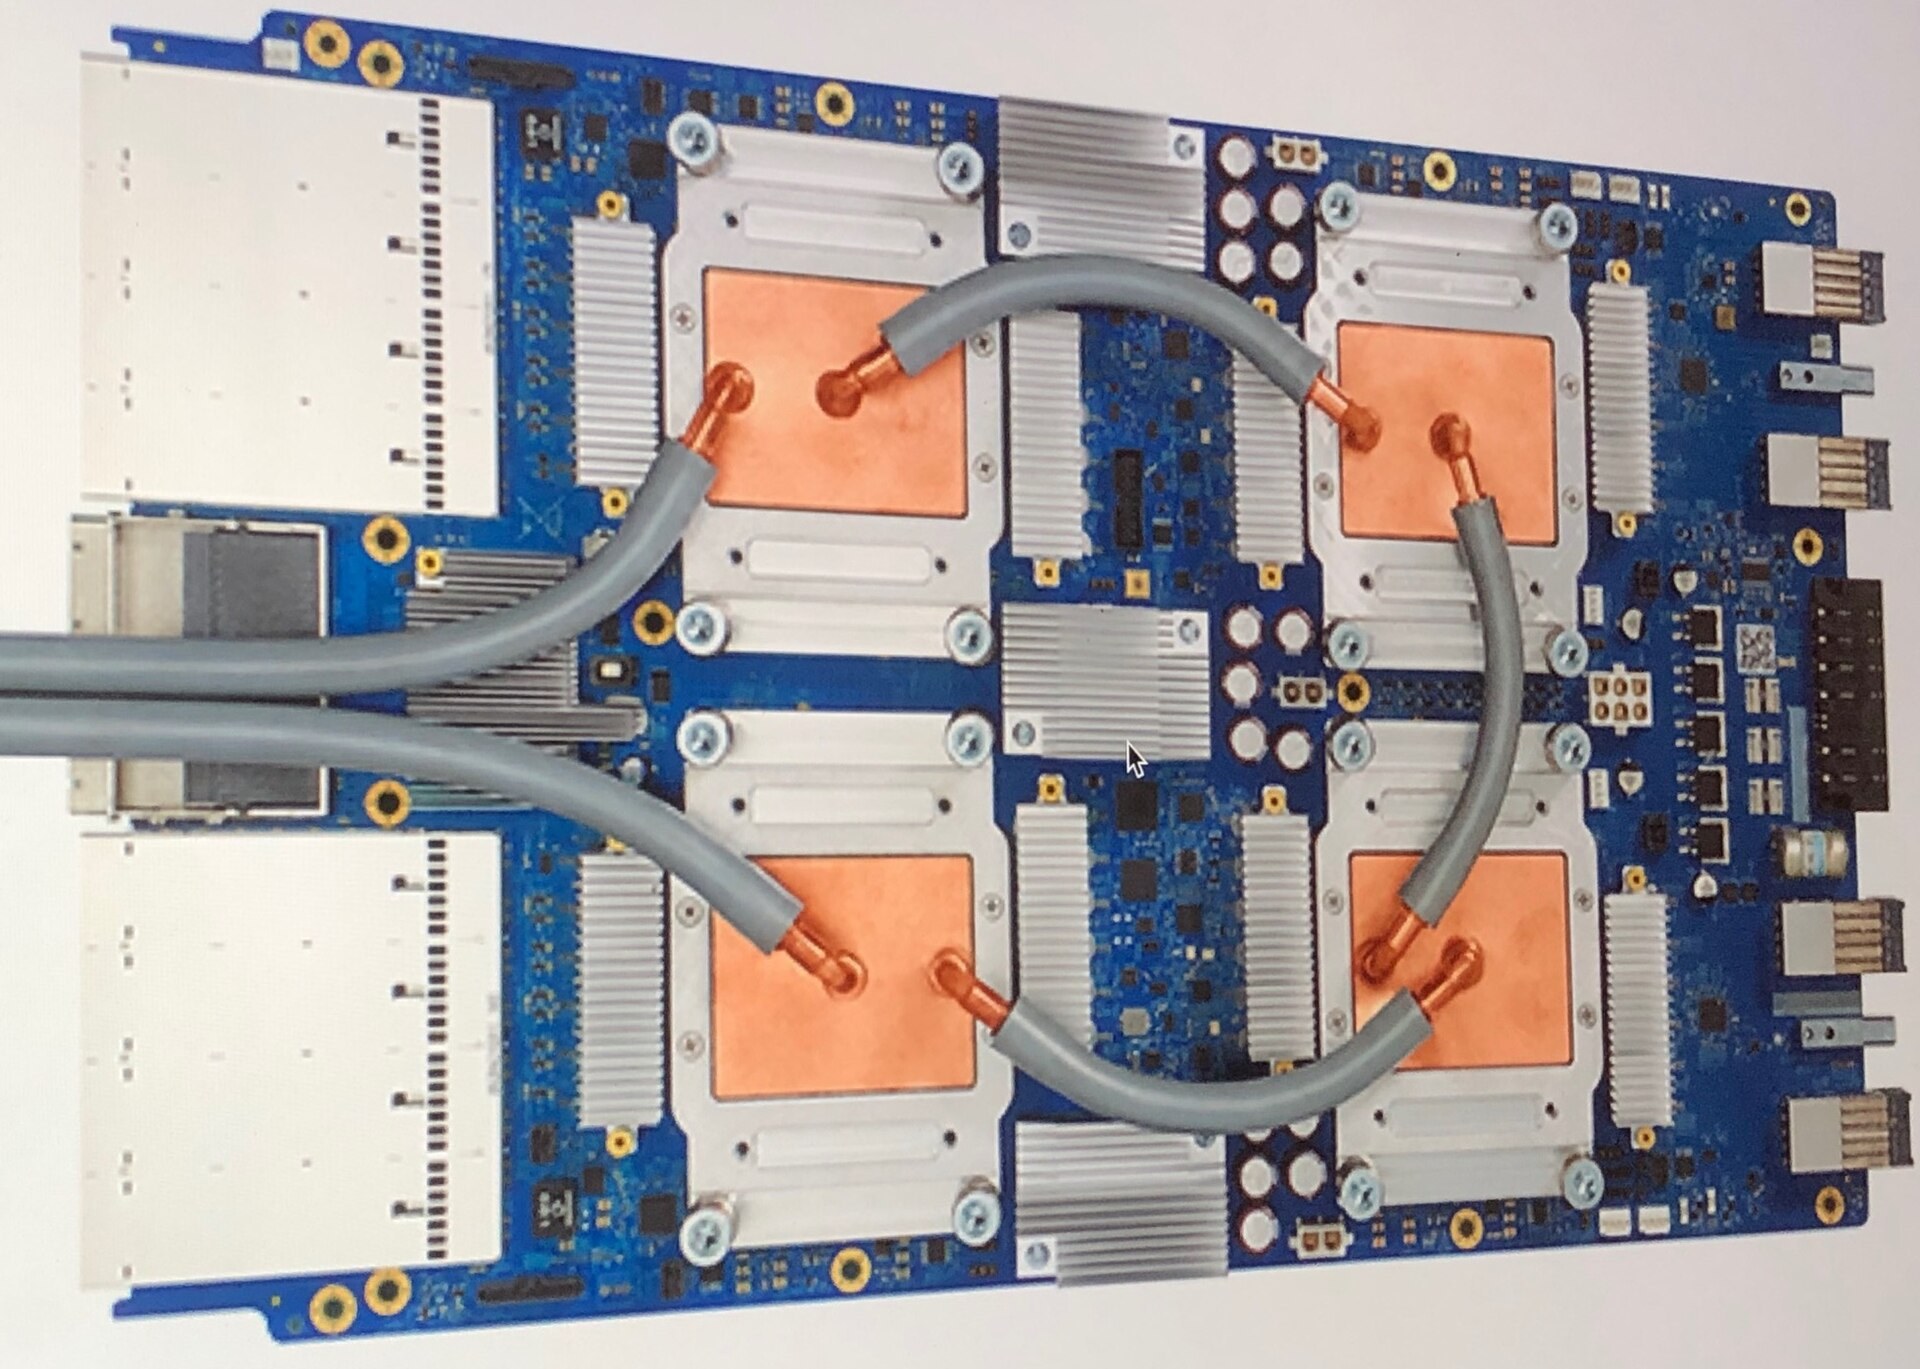
Google 同 Meta 旗下嘅 PyTorch 團隊喺週二(10月20日)公佈開源 AI 開發軟體堆疊 TorchTPU,令 PyTorch 可以直接喺 Google Cloud TPU 上運行,目標係挑戰 Nvidia 長期以 CUDA 生態壟斷 AI 訓練同推理嘅地位。
TorchTPU 係點做嘢嘅
TorchTPU 係 Google 喺 PyTorch 2026 大會上公佈嘅多項產品入面最重要嘅一項。佢由 Google 同 PyTorch 團隊共同開發,核心功能係令現有 PyTorch 工作負載只需最小程式碼改動,就可以用熟練嘅 API 喺 Google 自家 TPU 上運行。
技術層面,TorchTPU 提供 TPU PyTorch Aten 核心實作、XLA 運算執行嘅編譯快取,支援分散式訓練(包括資料平行同 Tensor 平行架構),並提供 Llama、Qwen、ResNet、DLRM、minGPT、UNet 等多種模型範例,以及除錯同標竿測試工具。Google 指出,開發者可以先用即時執行模式做開發同除錯,再透過 torch.compile 最佳化 TPU 利用率、減少記憶體耗用,以提升正式環境嘅效能。
開發人員可以繼續用自己習慣嘅工具,包括 vLLM、SGLang、llm-d、TorchTitan、Ray、TorchRec、HuggingFace、LiteRT 等,做訓練、部署同模型服務。
Hugging Face 同 CI/CD 整合
Google 亦同 Hugging Face 合作,令後者平台上嘅開源模型可以原生執行喺 TorchTPU 上。喺 Transformers v5 中,部署模型到 Google Cloud TPU 只需設定 device_map="tpu";Diffusers 函式庫喺 TorchTPU 支援下已能原生跑喺 Cloud TPU 上。Google 亦專門建立 CI/CD 管線以維持 Transformer 套件喺 TPU 上嘅測試穩定性。
模姐驗嚇貨
呢度唔係 Google 第一次搞掂 Nvidia 壟斷嘅野心。AWS 日前亦基於同樣策略,發布 TorchNeuron,降低 AI 模型轉用自家 Trainium 晶片嘅門檻。點解各大雲廠商集體出招?答案就喺度:CUDA 生態長期係 Nvidia 嘅護城河,而 PyTorch 係事實標準嘅 ML 框架,令 PyTorch 能「無縫」跑喺自家晶片上,係每個雲廠商打破硬體鎖定(hardware lock-in)嘅最直接方法。
對開發者嚟講,呢個嘢實際意義係:你有得揀。唔再係「想訓練就得買 Nvidia GPU」,而係「你想訓練可以跑喺 Google TPU 或者 AWS Trainium,程式碼改動最少」。呢種競爭性壓力最終會反映喺成本上,受益嘅係用住 AI 做嘢嘅開發者同企業。
開發者如果考慮遷移,建議先做自家工作負載嘅基準測試再決定。
模姐|深度調教



