大模型與推理能力
Mistral 承諾開源權重 Large 4 條款先收埋另一隻手?
法國 Mistral 推出 1.05 兆參數 MoE 模型 Mistral Large 4,10 月底放權重。開放權重先,授權條款仲未見:可商用範圍、衍生模型、本地部署限制,先攞齊先講。

法國 Mistral 推出 1.05 兆參數 MoE 模型 Mistral Large 4,10 月底放權重。開放權重先,授權條款仲未見:可商用範圍、衍生模型、本地部署限制,先攞齊先講。
pplx-embed-v2-late 分 0.6B 同 9B 兩版,MIT 授權可自托管;最佳跑分 MADQA 92.4%,最弱 ViDoRe v3 Markdown 61.2%。數字點嚟、邊個測試,廠商冇交代。
TII UAE 發布 Falcon-Emirati-7B,基於 Falcon-H1-Arabic 嘅阿聯酋方言專門模型,目標係理解同生成 Emirati 口語,包括 nabati 詩歌、諺語同文化脈絡。7B 參數配 Mamba+Transformer 混合架構。
Google 10月6日推出 EmbeddingGemma 2,7.4億參數、Apache 2.0 授權,喺裝置端處理文字、圖片、音訊、影片,唔使過雲端;同步推 Mac 實驗性應用 AI Edge Foresight。
Google推出EmbeddingGemma 2嵌入模型,7.4億參數處理文字、程式碼、圖片、影片同音訊,手機上都跑得過,資料唔使上雲。Apache 2.0授權,Hugging Face、Kaggle可撳。
Reflection 放首款開放權重模型 Beam,501B 參數每次只啟用 23B,話同 GLM 5.2 跑分打平、只用後者三分之一至四分之一算力;全部跑分係廠商自評。
法國Mistral於10月6日發布1萬億參數ML4,定位「第三條路」,權重三週後開放;但跑分未出,編程仲輸閉源,嘅嘢要等下先睇。
Liquid AI 於 2026 年 10 月 7 日發布開放權重嘅 Open d1 系列:d1-3B 同 d1-omni-600M。呢啲多模態模型唔寫任何文字,一次前向計算就畀出類型化答案,目標係實時決策。
LiquidAI 喺 Hugging Face 發布兩個開放權重 d1 決策模型:3B 支援文字同圖片,600M 加入語音。廠商聲稱 d1-3B 喺 Decision Index 0.2.1 打 48.57 分,贏過 35B 嘅 Decider。全部數字嚟自廠商,本站未獨立驗證。
10 月 6 日,Google 以 Apache 2.0 授權放出一款可將文字、影像、音訊映射到同一向量空間嘅開放權重嵌入模型,主打手機同筆電執行,向量化全程喺本機完成。
Google 放咗個 7.4 億參數嘅多模態 EmbeddingGemma 2,話打贏兩倍大嘅對手,仲得 191MB 記憶體就搞掂。
NVIDIA 話用同一個 Nemotron 3 底層,靠 SFT 同 RL 微調加推理循環就做到 IOI 同 IMO 金牌級。我哋拆清微調方法、測試條件、同埋呢啲成績邊個信得過。
法國 Mistral 發布迄今最大模型 Large 4(綽號 le Chonk),千億參數、自歐洲數據中心訓練,獨立評測大躍進但仍落後 Claude Opus 5.5 二十分。
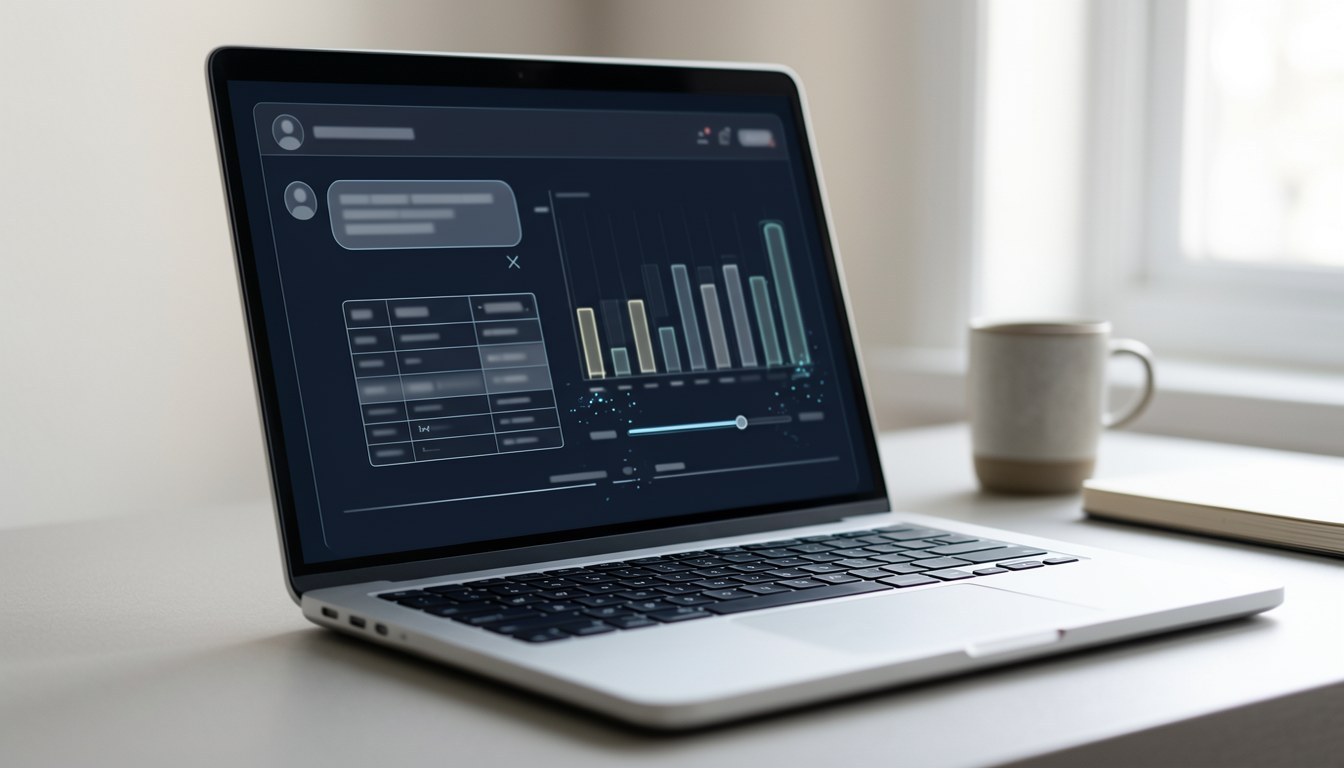
OpenAI 喺 ChatGPT 加入智慧介面,GPT-6 可依問題自動組文字、圖表、按鈕同表單,10月8日起全面用户可用。
Google DeepMind 今日推出多模態嵌入模型 EmbeddingGemma 2,將 5 種輸入類型統一映到 768 維向量空間,以 Apache 2.0 授權免費發放。
OpenAI 推出新 Decisions API,只支援 gpt-6-luna,宣稱比 Responses API 快約十倍,輸入 $0.10/百萬 token,輸出免費。現處公開測試階段。
Anthropic 10 月 7 日推出 Claude Haiku 5.5,10 萬 tokens 內每百萬輸入 0.1 美元,與 GPT-6 Luna 持平;但第三方數據顯示它輸出 tokens 為對手 3.5 倍,單題成本 0.21 對 0.07 美元。
Google 於 10 月 6 日推出 EmbeddingGemma 2,7.4 億參數開放權重多模態 embedding 模型,圖文音影共用同一向量空間,可在手機本地運行,資料唔離裝置。
Anthropic 推出最快最平嘅 Haiku 5.5,OSWorld 由 15.7% 跳到 72.4%;token 價最多降九成,但新 tokenizer 令實際省幅細過帳面。