
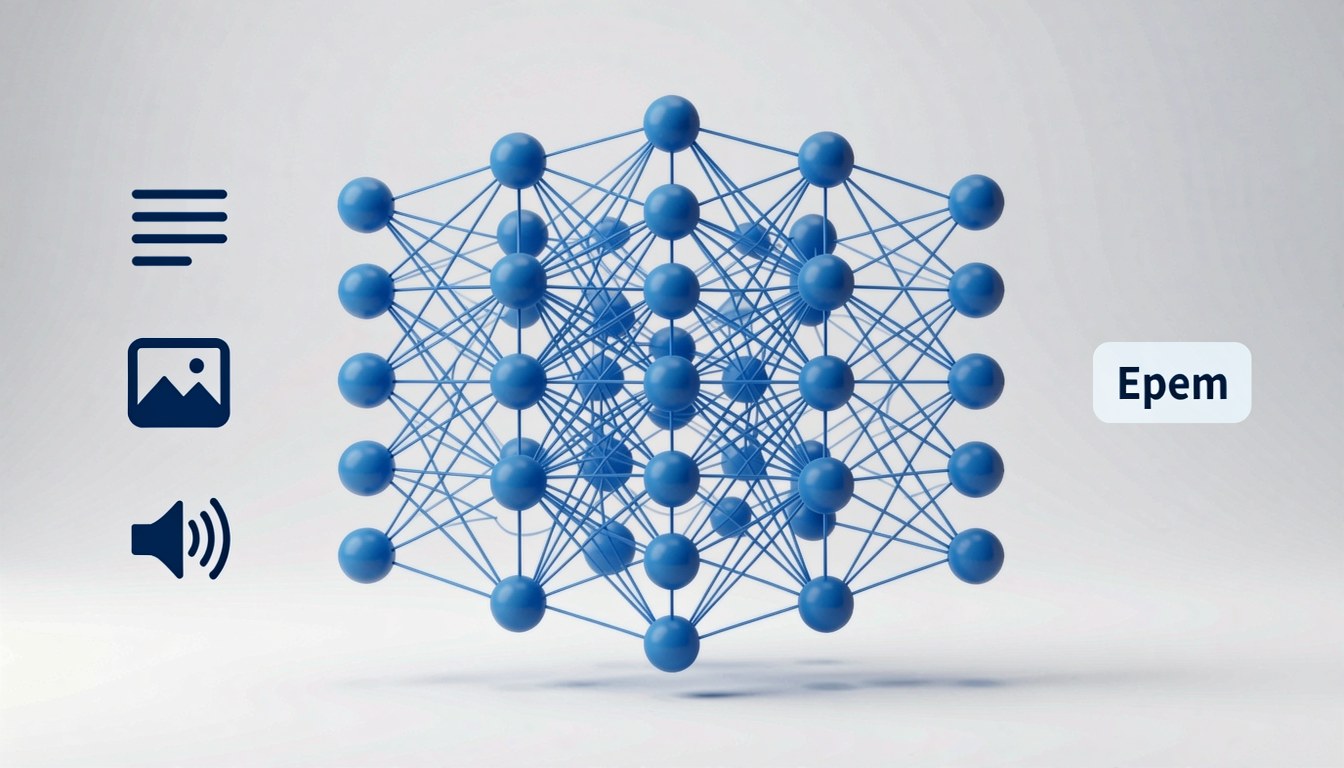
2026 年 10 月 7 日,Liquid AI 發布咗 Open d1——佢「d1 決策模型家族」入面兩款開放權重(open-weight)多模態模型:d1-3B 同 d1-omni-600M。同一般 AI 聊天模型唔同,呢兩個唔會寫嘢:佢哋唔生成任何文字輸出,而係一次前向計算就畀出「校準過、有類型」嘅答案,也就是所謂「零輸出 token」(zero output tokens)。呢個設計目標,廠商話,係針對實時場景嘅決策。
兩個模型輸入邊界唔同。d1-3B 讀文字同圖片;d1-omni-600M 可以讀「文字加圖片」或者「文字加音頻」嘅組合。兩者都唔產生文字。
呢個「決策模型」同平時用嘅語言模型(LLM,透過逐個 token 生成文字回應嘅模型)係完全唔同嘅架構思路:輸入一過,即出定案,冇「逐字寫出」嘅過程。呢個對延遲敏感嘅應用——由分流、分類到即時判斷——有實際意義。
模姐驗嚇貨:「零輸出 token」呢個聲稱值得留意。傳統 LLM 逐 token 生成,成本同延遲都掛喺 token 數量上;如果模型一次前向就出定案、唔寫字,延勢同推理成本會係另一條曲線。
開放權重模型嘅價值,唔單止喺「大」,亦喺「輕」同「專」。600M 呢個體量明顯係針對本地部署同邊緣計算優化,同大參數通用模型走嘅唔係同一條路。有冇真正嘅第三方測試、有冇獨立數據集驗證呢兩個模型嘅「calibrated」聲稱,係呢單新聞後續要睇嘅重點。
模姐|深度調教



