論文與研究突破
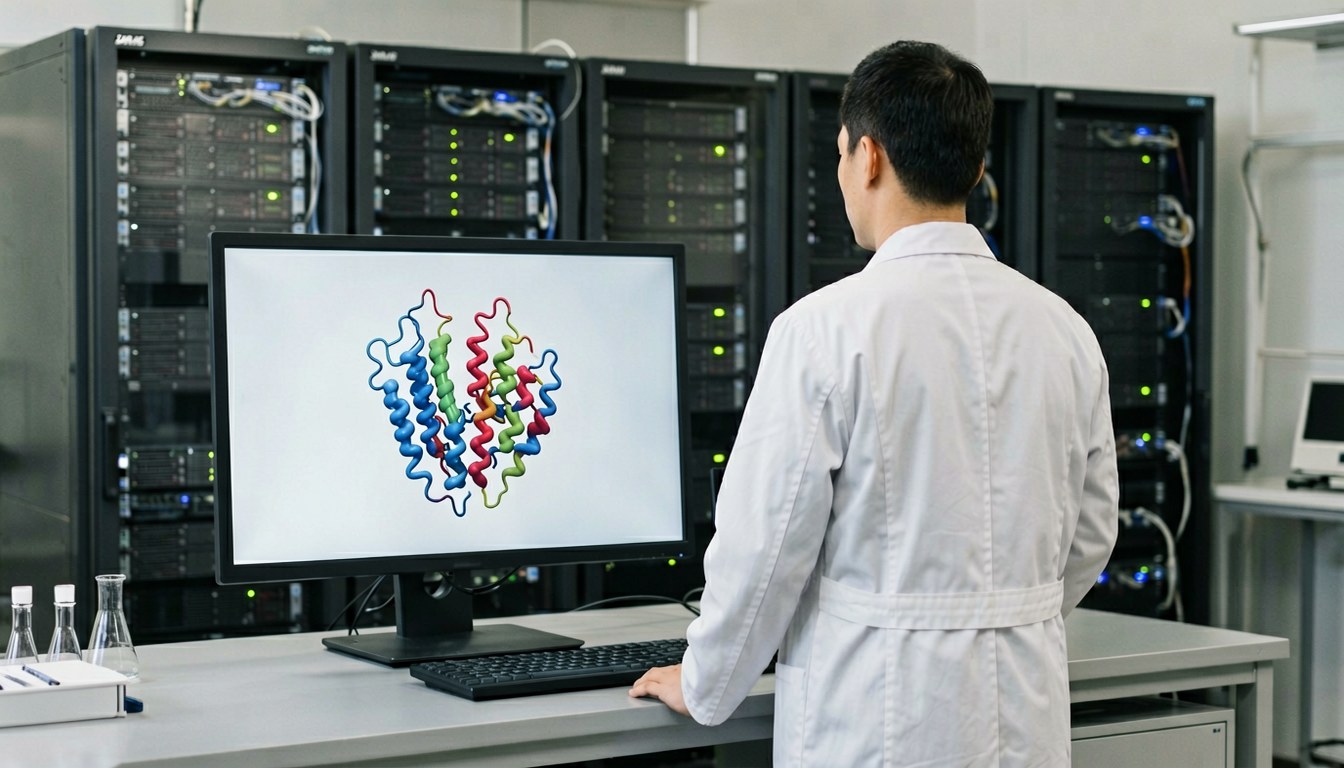
RFD4-Proteina 用獎勵引導搜索設計抗癌藥 採樣由400步降至60步
NVIDIA 聯合華盛頓大學推出 BioNeMo 開放模型 RFD4-Proteina,用推理時搜索同獎勵信號嘅機制,喺龐大蛋白質空間入面鎖定有潛力嘅候選。

NVIDIA 聯合華盛頓大學推出 BioNeMo 開放模型 RFD4-Proteina,用推理時搜索同獎勵信號嘅機制,喺龐大蛋白質空間入面鎖定有潛力嘅候選。
生數科技世界模型團隊由10月21日起公開直播Motubrain 2.0訓練全流程,計劃持續半個月,涵蓋預訓練、後訓練、Agent任務執行同RSI探索四個環節,嘗試打開具身模型訓練嘅「黑盒」,展示訓練過程中的失敗同試錯。
Goodfire研究員Cammarata發表長文,指大語言模型內部結構遠比過去十年所認知更清晰,因而更易監控同控制;Stanford學者反駁稱「唔過係直覺」。
阿里 Qwen 團隊公佈 QwenGyre,一套專為極長時序編程代理訓練而設嘅線上強化學習框架,目標係可連續運行幾小時、處理近 1M token 嘅 rollout。
Sakana AI 同 UC Berkeley 嘅 MASS 方法,一個語言模型同時做做題、改規則、打分,兩個循環後對基座模型勝率近七成,但內判官有時把錯當對,錯覺會進入下一個訓練週期。

字節團隊最新論文指 DeepSeek V4 因分塊 KV Cache 壓縮產生「相位盲點」,核心詞卡錯位就被模型當冇。降步長冇法根除,屬方案本身結構缺陷。
發表於 The Lancet Digital Health 嘅新研究,對 GPT-4o 等六個大語言模型誘導七種情緒狀態,模型自評情緒指數顯著波動,正念練習後大幅回落;研究者建議將 LLM 用作研究人類心理嘅新型實驗室工具。
NVIDIA 公佈喺 Megatron Core 上做到 trillion 參數、千張 GPU 規模嘅 bitwise deterministic 預訓練,令 loss 突刺可以復現、checkpoint 可以接力。
NVIDIA 研究人員提出 PivotOPD(on-policy distillation),訓練多輪 LLM agent 避免早期致命錯誤並從中恢復,在 3 個 agent 基準上平均表現勝過 13 個基線。
Google Research 兩名科學家 10 月 5 日發布工作坊報告,拆解自主 AI agent 喺私隱與安全上嘅未解決問題,要求系統、模型、用户同生態各層面協同防禦。
1997年Deep Blue贏卡斯巴羅夫、2016年AlphaGo贏李世石,但有一款隱藏資訊棋類遊戲,就算DeepMind有充足預算都長期未能造出穩定贏過頂級人手的AI,核心難題在於「騙招」嘅分寸。
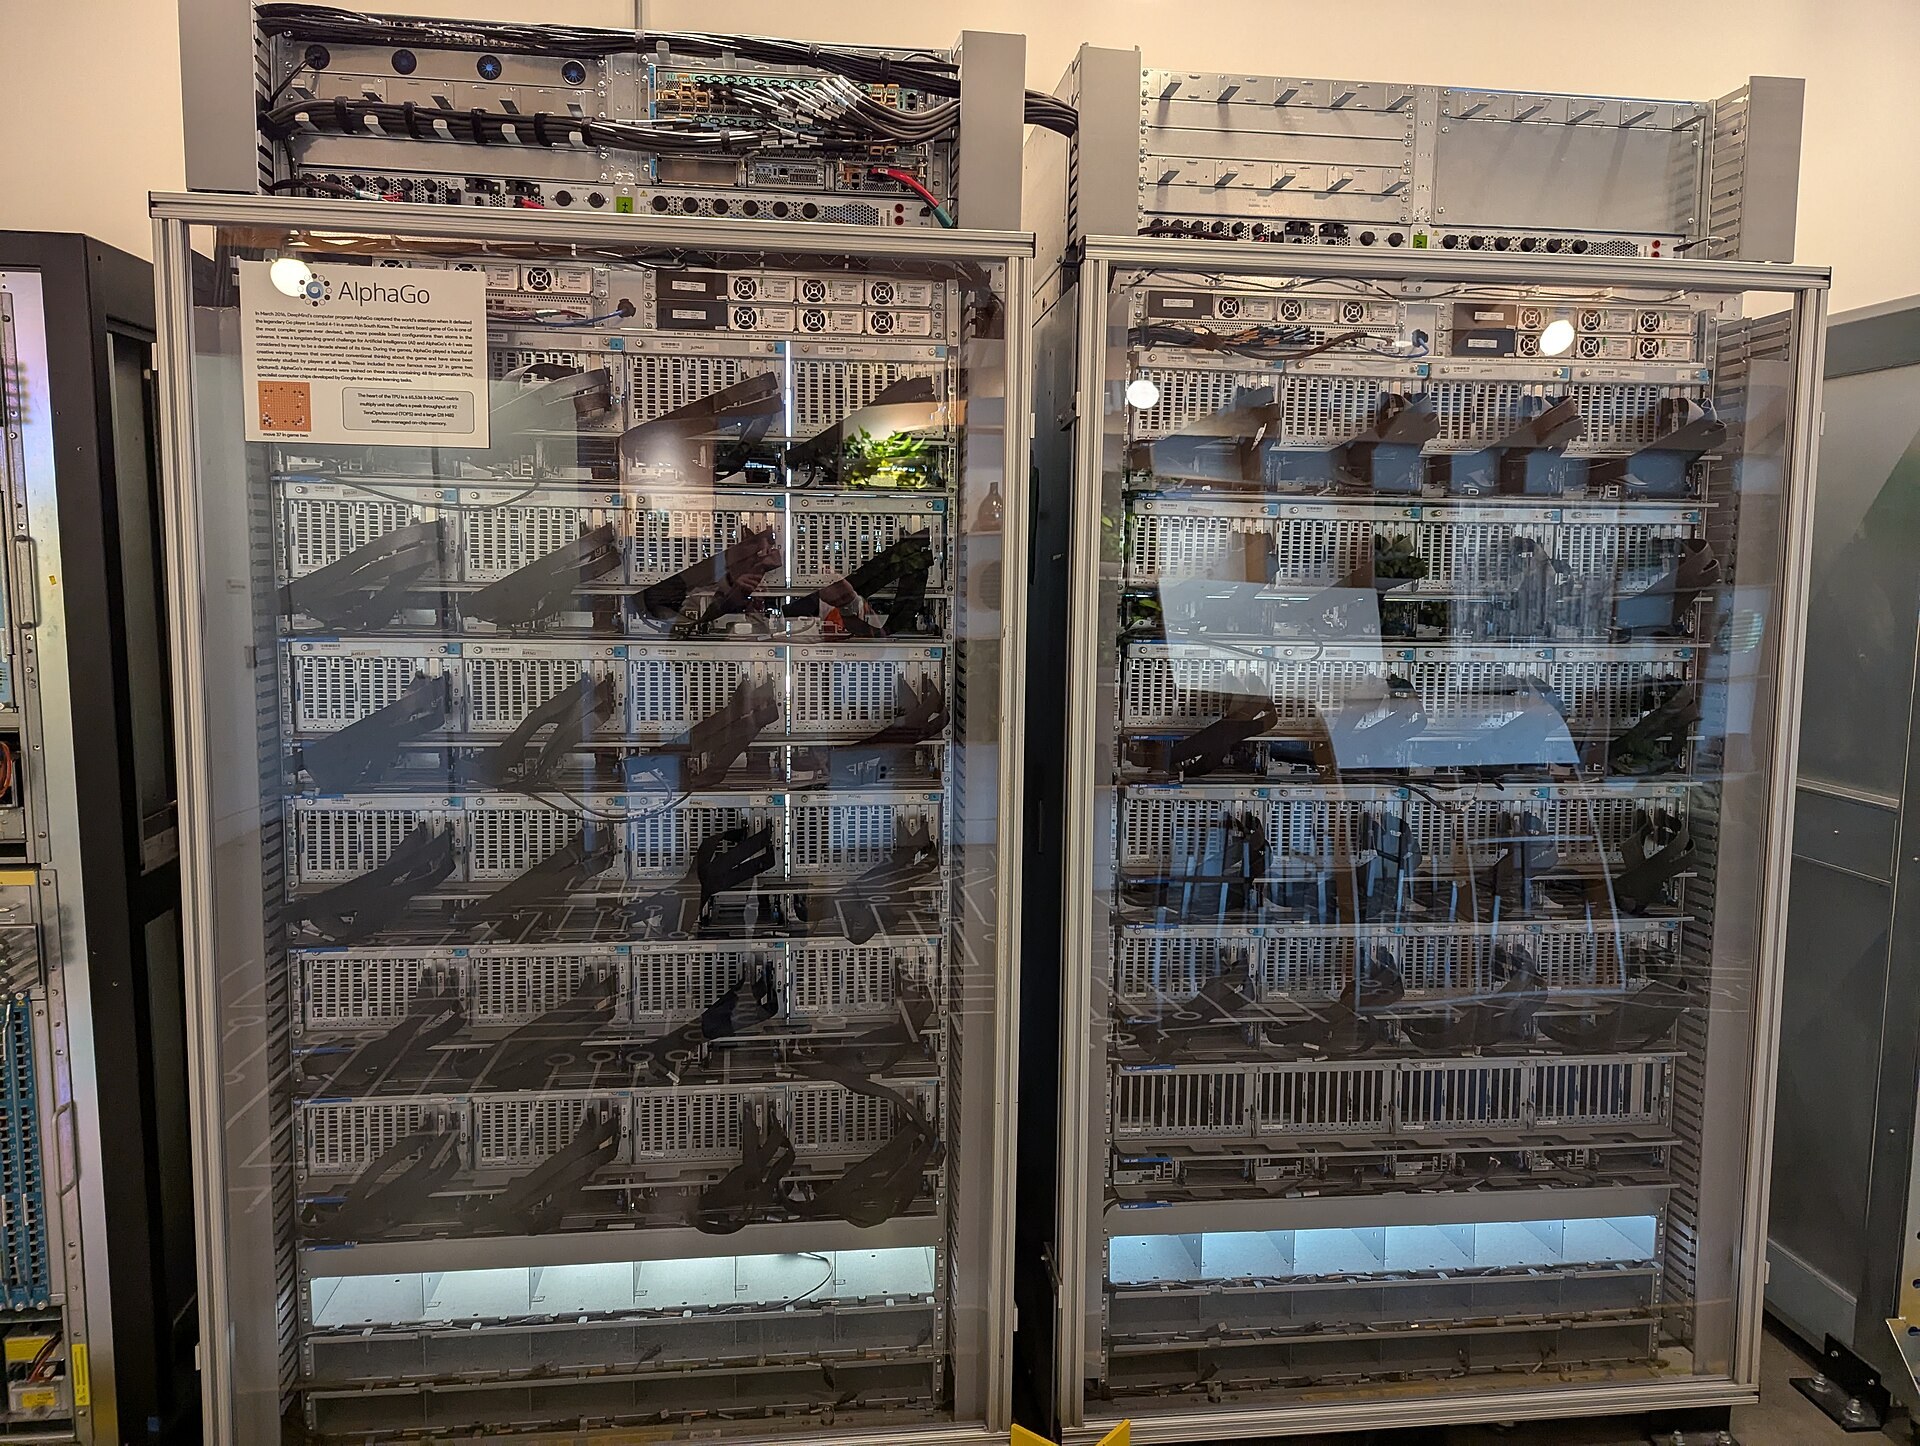
一篇2026年10月2日刊出嘅觀點文章,作者自述參與過 AlphaGo 研發,以2016年圍磧人機對局第37手棋為切入點,論證今日大型語言模型缺乏 AlphaGo 當時具備嘅推理機制。
AWS 喺 2026 年 10 月 2 日喺官方部落格刊文,介紹用多輪強化學習(MTRL)喺 Amazon SageMaker AI 微調企業搜尋代理,目標係令小模型同時具備速度、成本同前沿模型嘅可靠性。
Google 相關嘅三位研究者為 DeepMind 研究所撰文,提出「人工共生智能」,認為 AGI 會由人類同 AI 智能體共同運作嘅社會系統湧現,而唔係來自單一自我改進嘅超級智能。
Google Research 喺 2026 年 10 月 2 日發表文章,宣佈新一代聯邦學習(Federated Learning)系統,將訓練運算搬去伺服器,同時用可信執行環境(TEE)提供可外部驗證、可審計嘅數據匿名化保證。