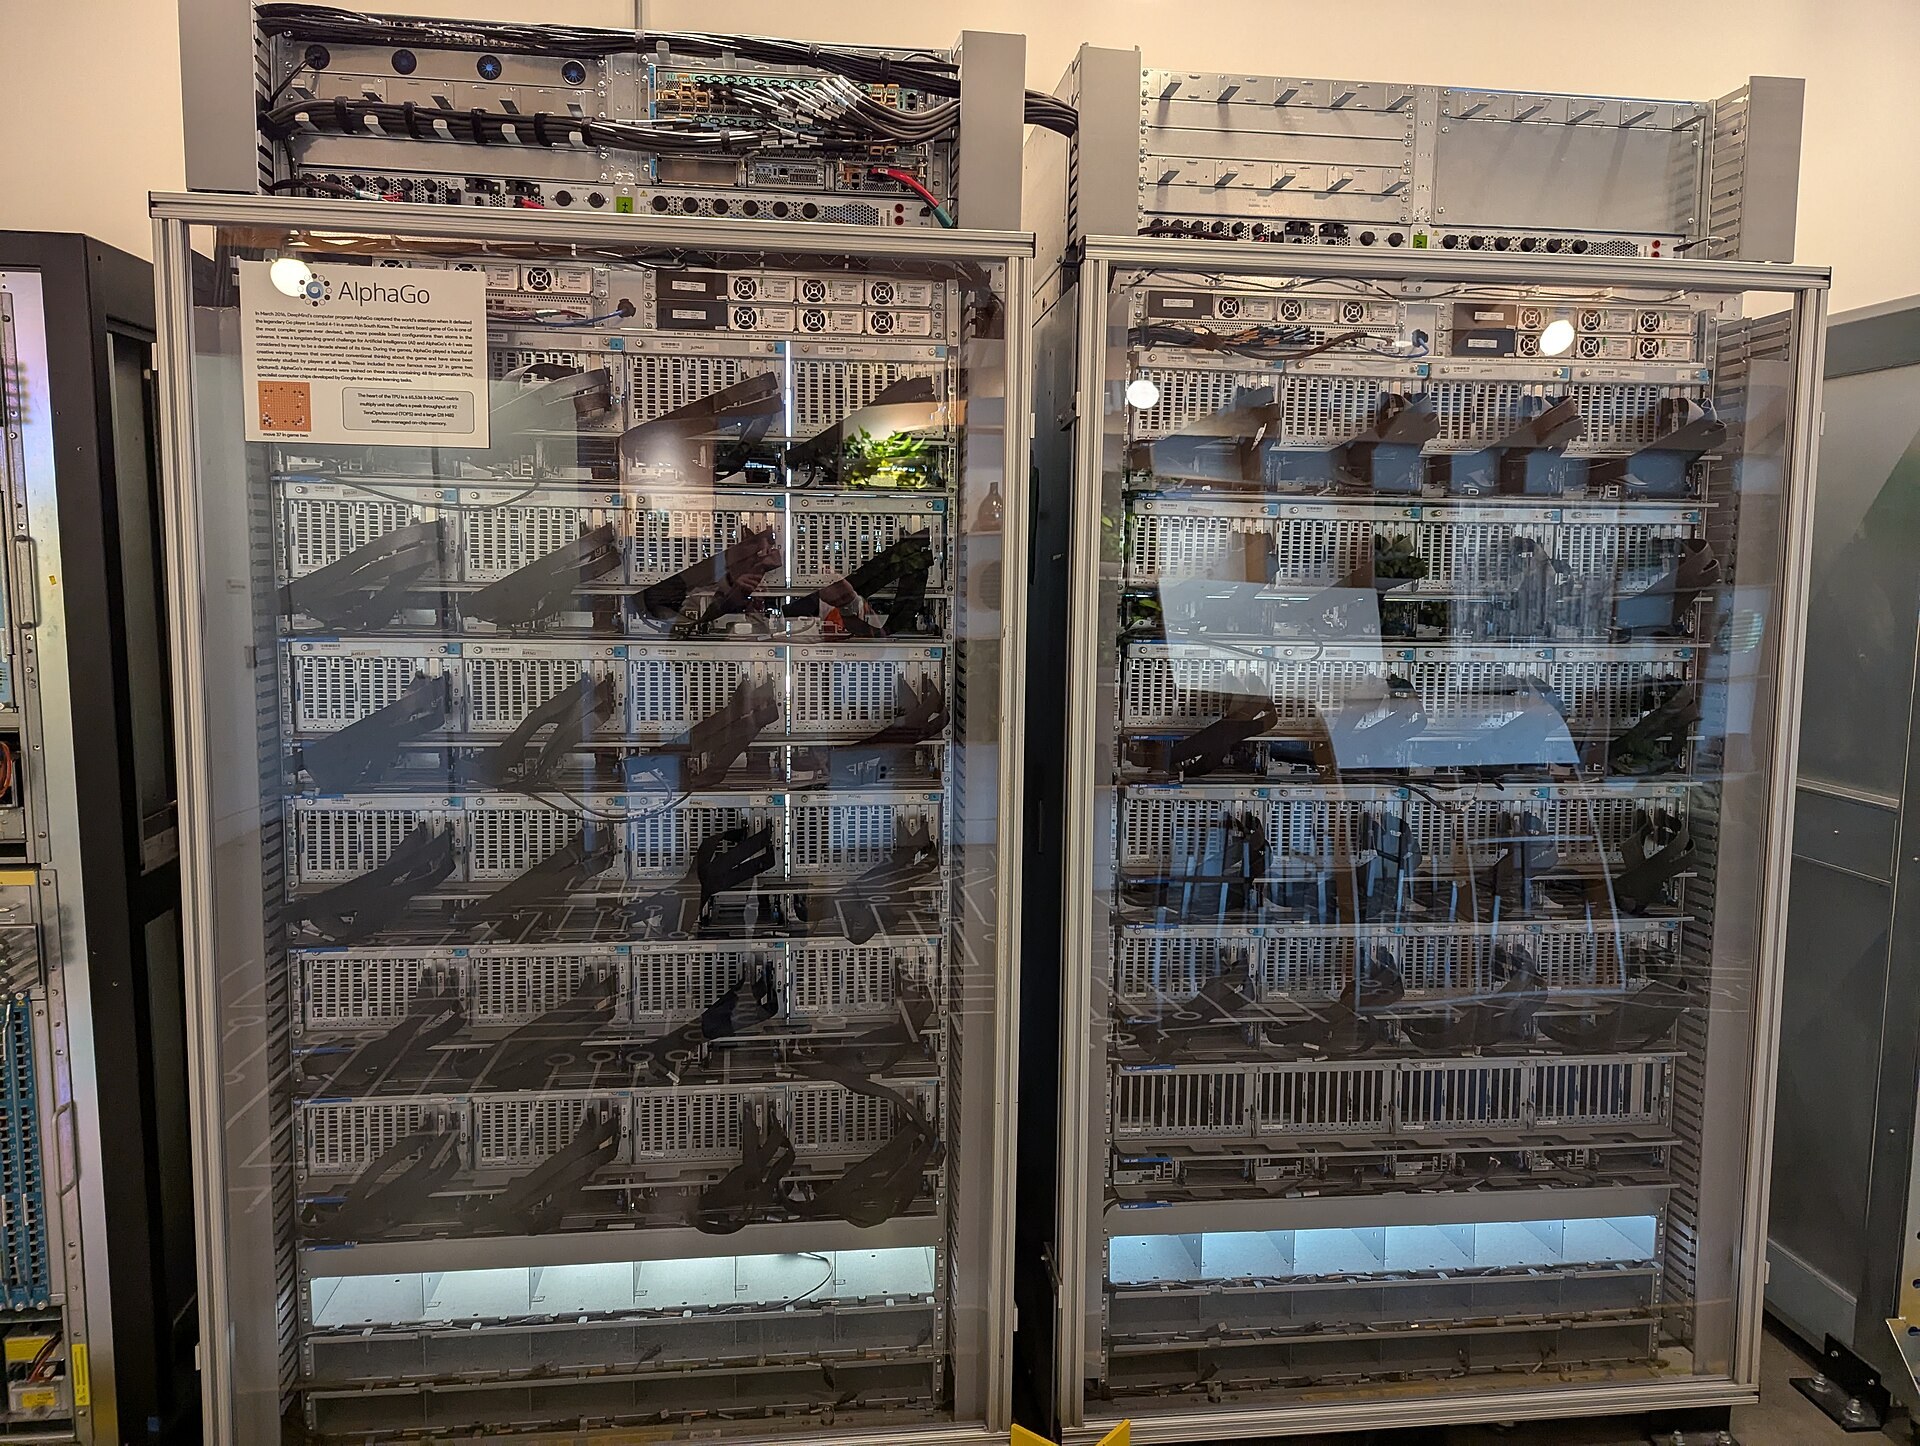
2026年10月2日,一篇觀點文章刊出,作者自述參與過 AlphaGo 研發,核心主張係:今日嘅大型語言模型(LLM,即透過大量文本訓練、以預測下一個詞為基本運作機制嘅 AI 模型)並冇推理能力,而 AlphaGo 當年的強項正正係呢啲。
文章以2016年3月首爾嘅人機圍磧對局為開頭。第二局第37手,AlphaGo 落咗一副喺圍磧界極罕見嘅棋,當時有現場評論員以為係程式故障。最終 AlphaGo 以4比1擊敗李喩範(Lee Sedol)。李喩範事後話:「我原本以為 AlphaGo 係基於概率計算嘅機器,但見到呢一手棋,我改變咗想法。AlphaGo 係有創意嘅。」
文章指出,AlphaGo 由兩個系統組成:一個策略網絡(policy network)負責預測高手會落嘅棋,一個搜索機制負責深入搜尋後續走法。策略網絡認為第37手嘅出現概率大約係萬分之一,真正促使 AlphaGo 選咗嗰手嘅,係後面嘅搜索機制——呢啱就係文章所指嘅「推理能力」。文章並指出,若我哋希望未來 AI 喺科學同醫學等領域產出可信結果同真正有新意嘅見解,就必須為佢哋裝備呢種真嘅推理能力,而非只靠統計相關性。
作為對照,文章提到1997年 Deep Blue 擊敗國際象棋世界冠軍卡斯普羅夫(Garry Kasparov)時,係靠每秒評估2億個棋局位置、每方預覽6至8步,並使用由人類編寫嘅硬編碼規則。圍磧嘅複雜程度遠超國際象棋;就算只計算可能走法嘅一小部分,超級電腦亦要數百億年。
模姐驗嚇貨
呢篇係觀點文章,作者話自己參與過 AlphaGo 研發,但未喺文中列明具名或具體職務。文中引用嘅 AlphaGo 架構細節(策略網絡萬分之一概率、搜索機制)同李喩範引語都係2016年公開紀錄已有嘅內容。文章對「LLM 唔會推理」呢個判斷,冇提供新嘅實證數據或獨立評測結果,係基於對 AlphaGo 搜索機制同 LLM 訓練機制嘅概念性比較。呢個論點喺學術界有一定支持,但「推理」嘅定義本身都仲有爭議。用嘢嘅時候,分清邊樣係模型真嘅推理到,邊樣只係語料相關性,先至最重要。
模姐|深度調教