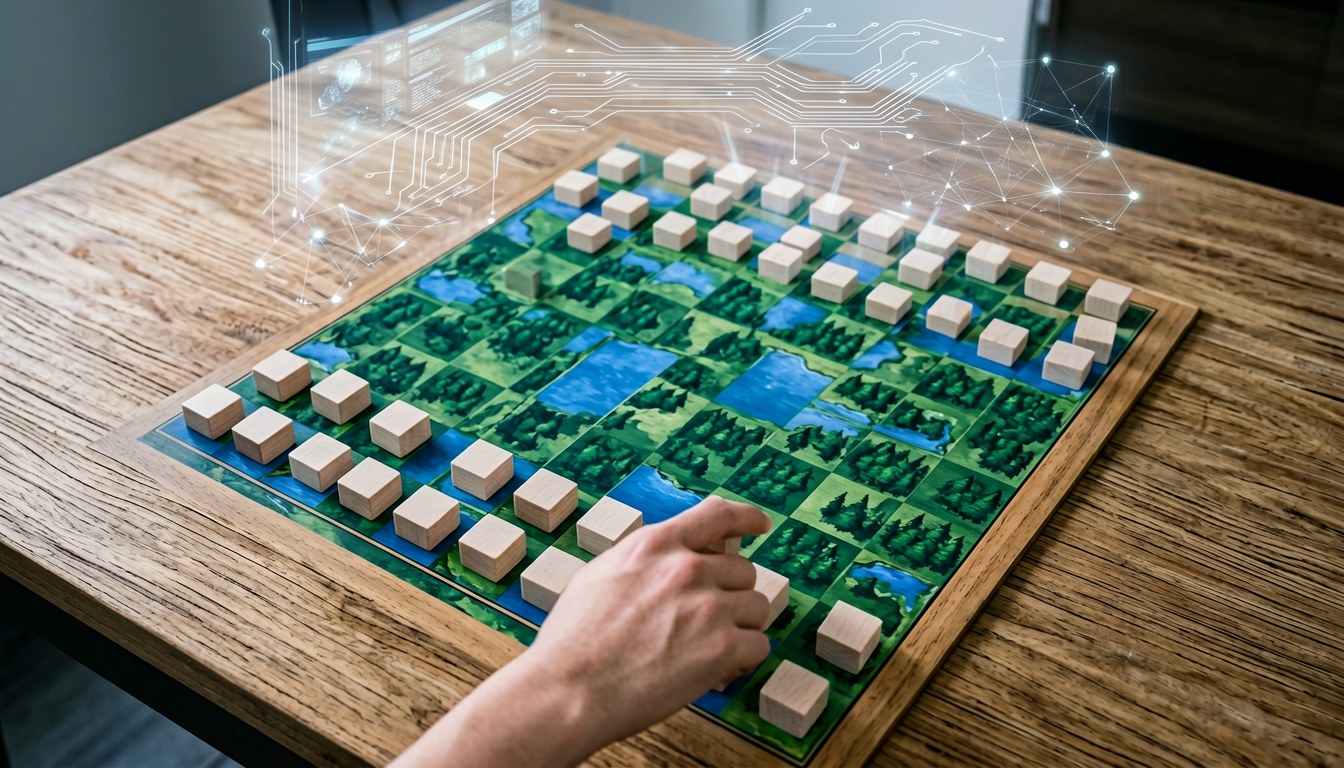
1997年,Deep Blue喺國際象棋對賽中擊敗卡斯巴羅夫;2016年,AlphaGo喺圍棋對局中贏咗李世石。呢兩宗事件標誌咗AI喺資訊完全公開嘅對弈遊戲上嘅突破。但有一款隱藏資訊遊戲,AI長期未能攻克,就係「Strategо」。
「Strategо」嘅規則:雙方各用40枚棋子(由元帥到間諜,另加炸彈同旗),喺己方陣地排列,目標係奪取對手嘅旗。對手棋子喺邊度係知道嘅,但嘅係乜唔知道。棋子身份只會喺兩子碰撞時先至揭露,弱者被移除出盤。
呢個隱藏資訊嘅挑戰,同撲克有相似但難度完全不同。德州撲克隱藏嘅手牌只係2張,可能組合1326種;「Strategо」單單棋子排列已經超過10的66次方種。棋局長度方面,國際象棋一般40手左右就結束,「Strategо」卻可以達到2000手。
最棘手嘅係「騙招」(bluffing)機制:玩家可以將弱棋當元帥咁行,嚇住對手。但騙招用得太頻繁就失效,完全唔用就畀對手讀到牌。第一作者Samuel Sokota話:「騙招用越多,對手越有預感,一次嘅價值就越低。」研究團隊指,2022年DeepMind嘅「DeepNash」就係喺呢個騙招分寸上卡住。
模姐驗嚇貨:Strategо嘅難,唔係單向搜尋深度嘅問題,而係佢將「隱藏資訊」同「長期欺騙」綁埋一齊。Chess同Go嘅AI靠深度搜尋或者神經網絡,但Strategо嘅騙招要求AI同時管理「點樣騙」同「點樣被讀穿」。DeepMind有充足預算都搞唔掂,正正就係呢個核心難點。
模姐|深度調教