算力與部署
幾千張GPU、150人爭算力 Ai2由「排優先」改「開算帳」
Ai2管理幾千張H100、B200、B300,需求長期係供應嘅2至3倍。過去優先級排程鬧到100%任務全設HIGH、GPU「泊車」亂象,而家換成時間預算+分層公平分配+時片合約,把爭算力變成透明行政流程。

Ai2管理幾千張H100、B200、B300,需求長期係供應嘅2至3倍。過去優先級排程鬧到100%任務全設HIGH、GPU「泊車」亂象,而家換成時間預算+分層公平分配+時片合約,把爭算力變成透明行政流程。
vLLM 同 Inferact 喺 DeepSeek-V4.1-Flash 發布後三週,透過 SWA bounded replay、CUDA graphs 同 DeepSeek 新 kernels,喺 SemiAnalysis AgentX 基準下將吞吐量提升 5.3 倍,TTFT 縮短約 30%。
推理佔比逐月爬升,CoreWeave 喺 Fully Connected 推出 Forge 平台同預覽版 RL Rollouts,聲稱模型重載延遲比基準快 15 倍,並開放免費層俾獨立開發者。
算力 giant CoreWeave 於 Fully Connected 大會推出 Forge 全棧平台,主打「運行、觀察、篩選、改良、評估」五段式改良迴圈,稱 Cognition AI 已喺 Nvidia Vera Rubin NVL72 機架上跑生產工作負載。
華碩 ProArt P14、P16 於 10 月 8 日在台開放預購,最高提供 1 Petaflop FP4 AI 算力與 128GB 統一記憶體,主打本地執行大型 AI 模型,10 月 16 日上架。
AMD今月6日證實對台供應鏈投資會加碼,惟新金額、幅度及時程未公佈;規劃週期由1至2年拉長至3至5年,各廠商出資比例仍未見披露。
Willow Voice 逐字入字應用公司 Willow Care 喺 Fully Connected 活動上話,選用 CoreWeave 唔單係買算力,而係對上其前線部署支援;目標兩年內令使用者開口就行、唔使打字。
AWS 喺自家技術部落格放出參考藍圖,講點樣令同一個 HyperPod EKS 集群同時俾多支團隊使用,而每個團隊各自有獨立 namespace、IAM 權限同 cost allocation,兼用 Task Governance 做到資源分配公平。
2026 年 10 月 6 日,AWS 宣佈 SageMaker Studio 新增 IDE and Notebooks 分頁,數據科學家可直接喺 Studio 介面管理 SageMaker Spaces,唔再需要 CLI。
AWS 出文講點喺 SageMaker Unified Studio 管理 HyperPod,同時唔拆散原有權限層。重點唔喺「接得上」,而係組織、項目、集群、工作負載四層控制各管各嘅嘢。
Architect Financial Technologies 推出 Liquid Inference,將每次大模型推理請求放到即時拍賣,供方出價、買方俾符合規則嘅最低價;接駁只需換一個 base URL。
長 session 嘅 KV cache 可以食盡 GPU 記憶體 1/10 至 1/20,Vast Data CTO 指分層卸載到 CPU 同持久化儲存,先至撐得住企業級 agent 記憶。
NVIDIA 喺技術博客公開 cuPhoton,一個 CUDA-X 開放源工具包,由探測器讀取一路做到分類都放喺 GPU 上跑,宣稱將數百 TB 數據嘅影像讀取加速最高 14,900 倍。
Huawei M900 同 NVIDIA CMX 都係為推理 KV Cache 而設嘅外置分層存儲。命中率越高越省 recompute,但 DRAM 同 SSD 乜樣配、呢塊「帳」點算,都仲冇標準。
NVIDIA 技術博客 2026-10-06 介紹 DOCA GPUNetIO 將 GPU 發起式網絡統一嘅架構變化,涵蓋 NVSHMEM、NCCL、UCX/NIXL 等多條產品線;材料為廠商自述,無獨立性能數據,開源版細節因原文截斷而缺失。
NVIDIA 今個月初推出 AI Cluster Runtime v1.0,將 GPU 集群嘅組件版本組合鎖定成可驗證「配方」,渲染成 Helm、Argo CD 等部署配置,並附帶簽署驗證證據。
CoreWeave 宣佈 Forge 平台,以跨區域物件儲存與熱加載權重縮短訓練間隔;You.com 稱配合 Nvidia 用八小時完成 Nemotron 3.5 Lightning 後訓練。數字與成效皆出自廠商,無獨立驗證。
新公司 Antseed 喺 10 月 6 日完成 $2.4M 融資後上線一個去中心化 P2P 推論市場,繞過大型雲 API 中間商,官方宣稱最平可平官方 API 價達 97%。
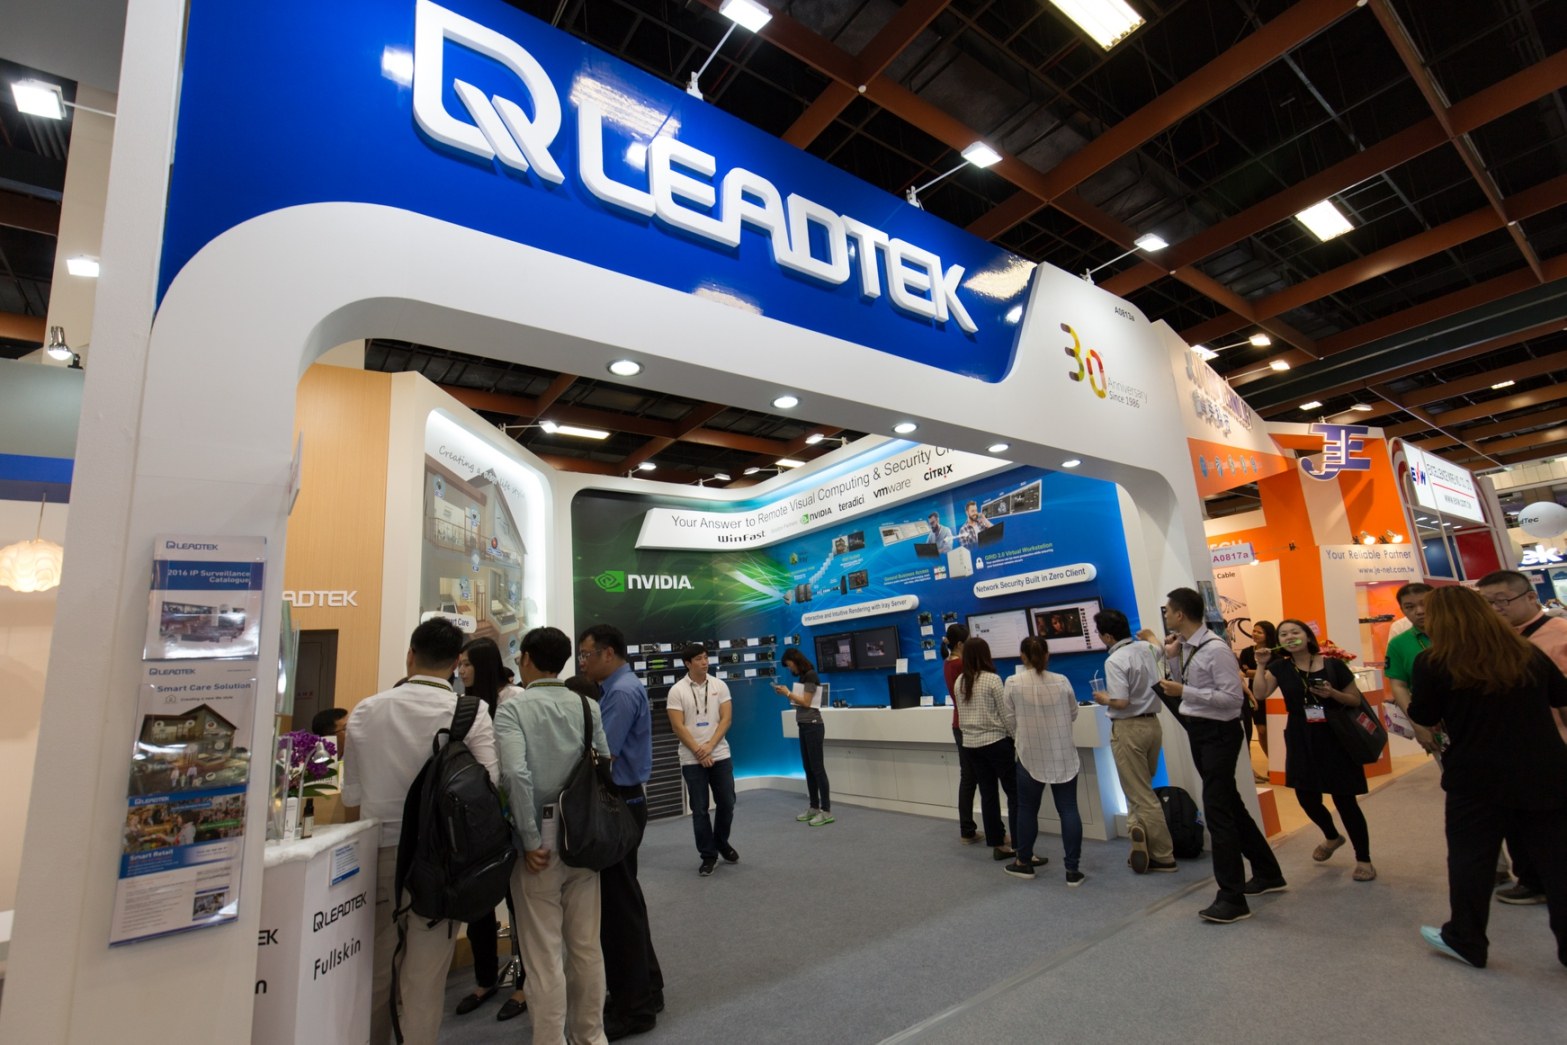
麗台(Leadtek)推 NVIDIA RTX PRO AI 工作站,定位企業 AI Agent 地端部署,並喺 10 月 6 日刊出部署分析。以下拆解雲端、地端同雲地協同嘅取捨,並註明邊啲係廠商自報數字。
NetApp 喺 2026 年 10 月 5 日 INSIGHT 大會推新一代 Novus 儲存架構,自宣聚合吞吐量超 100TB/s,並推 AI Data Engine,目標縮短原本需 6–9 個月嘅數據備料工作。全部為廠商自宣,未有獨立驗證。