
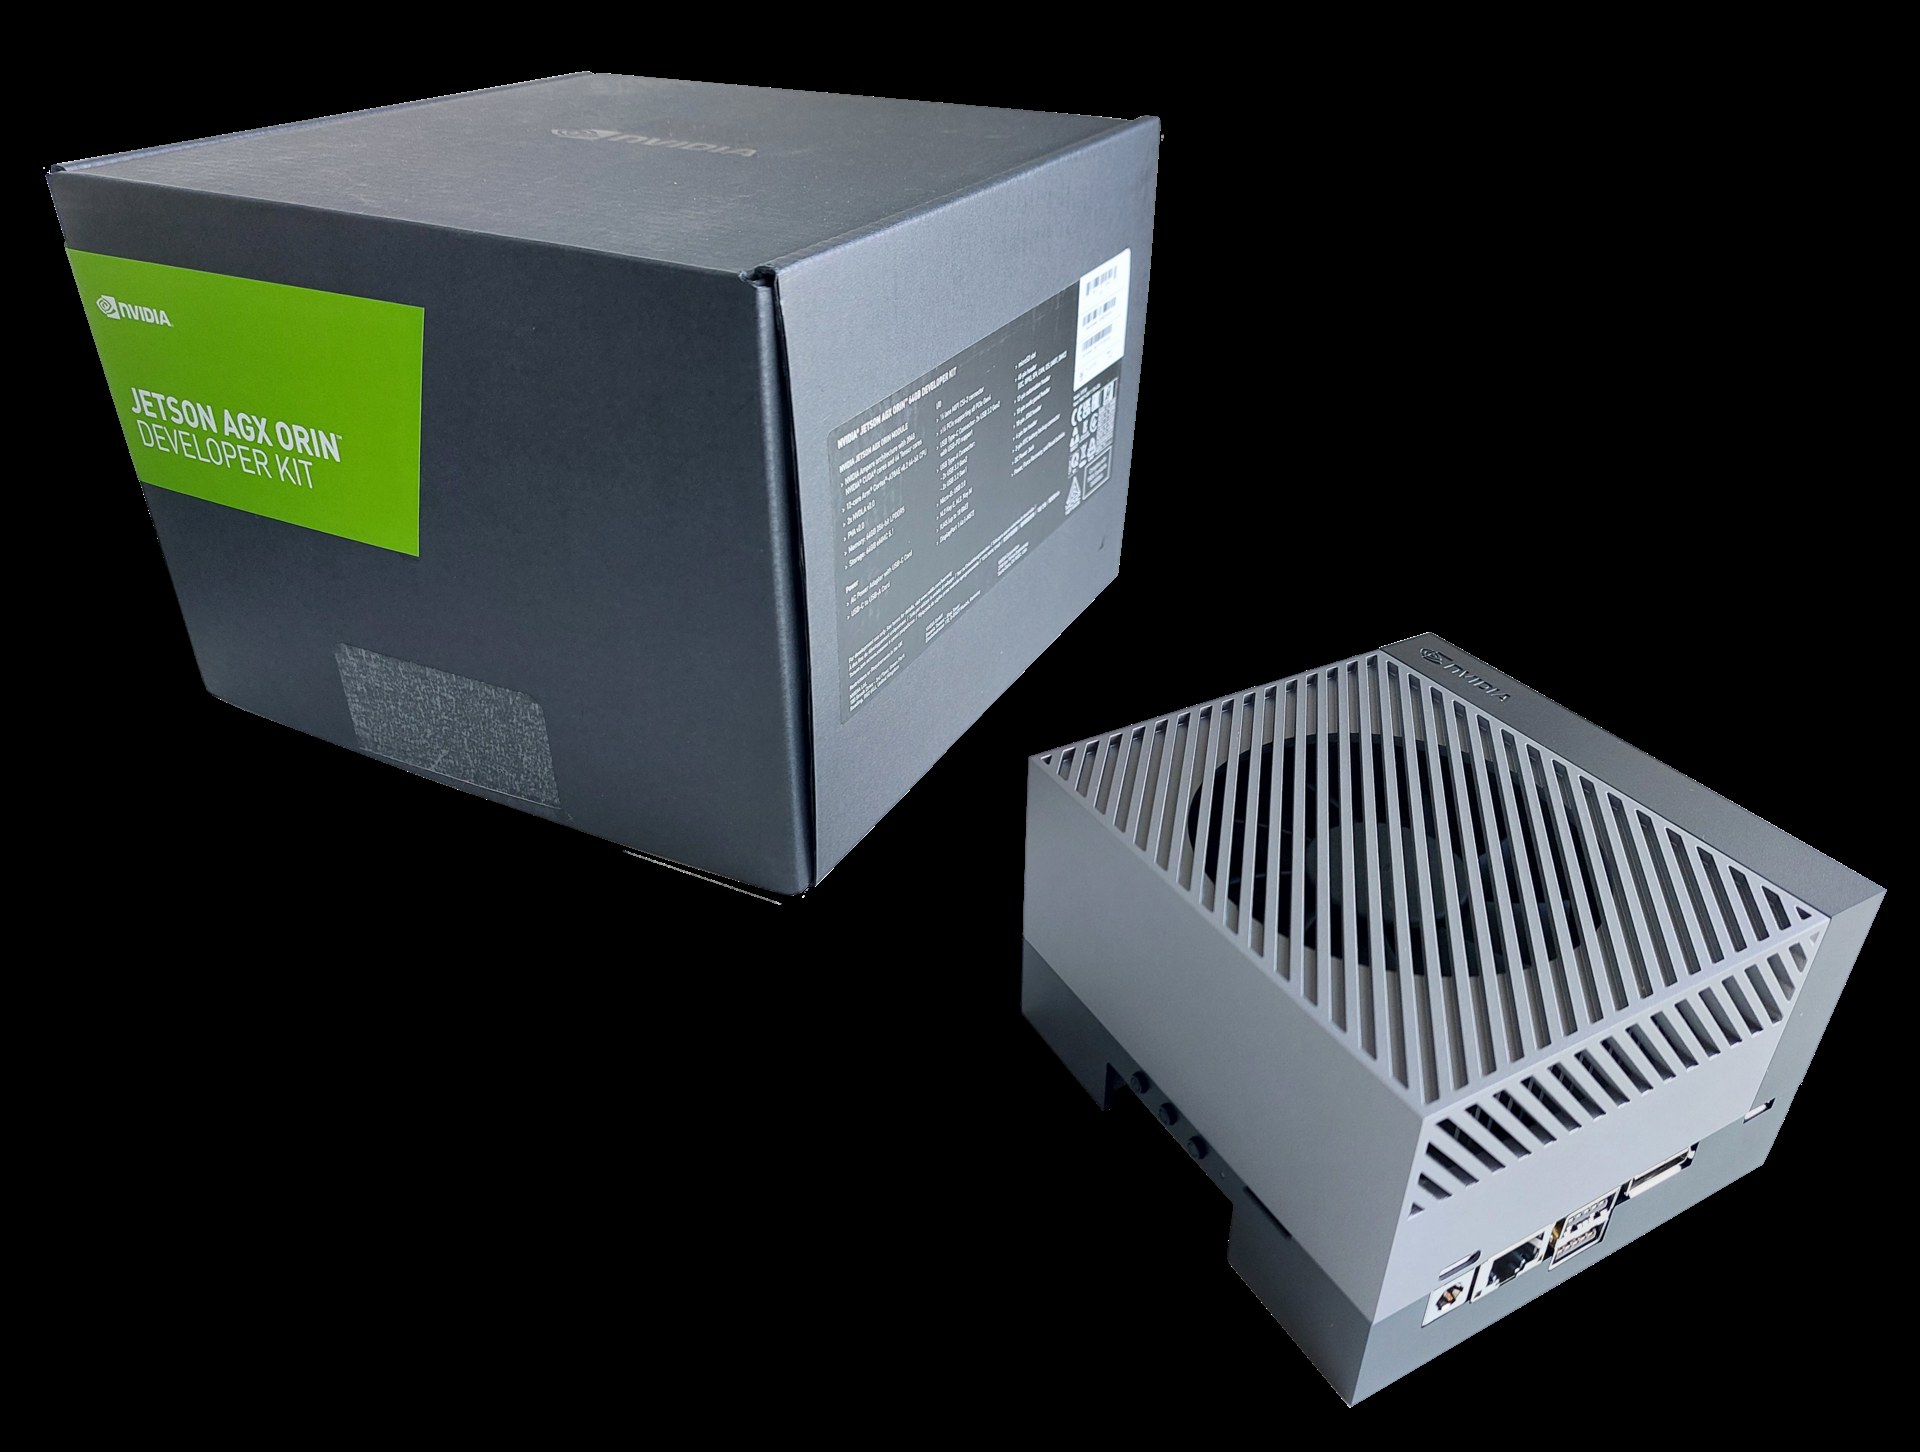
NVIDIA 喺 2026 年 10 月 23 日發布 Nemotron 3.5 Bolt E4B 4GB,一個以本地部署為目標嘅開放小型語言模型。呢個模型由 Google 嘅 Gemma 4 E4B-it 做底,經過 NVIDIA 嘅 Nemotron 後訓練,總參數 8B、有效參數約 4B,以 Q4_K_M GGUF 格式發布,NVIDIA 表示約佔 4GB 記憶體,可喺 GeForce RTX、Jetson、RTX Spark 同 DGX Spark 上運行。
模型卡列明,Bolt E4B 嘅設計重點唔係原始推理能力,而係「低記憶體、低 TTFT(Time to First Token,即第一個 token 嘅延遲)運作」。TTFT 對語音助手同遊戲角色嚟講,重要性大過推理跑分幾分——講出第一句話嘅速度,決定用户體驗好過 benchmark 多幾點。
開放範圍
呢個模型屬 NVIDIA 所稱嘅「開放模型,具備開放權重、訓練資料及配方」,模型卡列出了後訓練同預訓練所使用嘅數據集 repository,但同時提及部分私有數據集未公開。開放權重同完整開源係兩回事,呢度值得留意。
跑分:自己跑嘅分,自己睇
模型卡附帶由 NVIDIA 喺 NeMo Gym 測試框架下跑嘅比較表,涵蓋 Bolt E4B、Gemma 4 E4B-it、Qwen3.5 4B 同 Nemotron 3 Nano 4B,分 BF16 同 Q4_K_M 兩個版本。以下係 Q4_K_M 版本嘅部分數據:
- 對比自家底模:Tau2-Bench 由 38.72 升至 52.32,IFBench 由 42.67 升至 64.00——呢就係後訓練嘅目的。
- 對比 Qwen3.5 4B:各有優劣。Bolt E4B 喺指令層級(IHEval)、角色扮演、多輪約束同工具下幻覺測試領先;Qwen3.5 4B 喺 Tau2-Bench、長上下文 RULER、LongBench v2 同一般函數呼叫領先。
- 長上下文係弱點:RULER 64K 嘅分數,Bolt E4B 得 85.76,Qwen3.5 4B 得 95.37。如果你嘅 Agent 要處理長文件,先測試再決定。
模型卡註明,準確度由 NVIDIA 測量,「可能與廠商自報數字有差異」。大部分項目喺推理模式下運行,RoleBench、EQ-Bench v3 同 RULER 除外。
 圖片:Auledas/CC BY 4.0/Wikimedia Commons
功能
- 多輪工具調用:喺對話中呼叫應用程式 API,附帶非同步工具調用整合指引
- 對話模式:開關可令模型以簡短、適合語音嘅方式回答
- 可配置推理:可啟用推理處理複雜請求,或關閉以求速度,並可設定推理預算上限
- 64K 上下文
- 支援 35 種語言(底模預訓練於 140+ 種語言)
- 後訓練數據截至 2026 年 5 月
NVIDIA 喺研究頁亦發布了 accuracy vs TTFT 同 accuracy vs verbosity 嘅跨模型圖表,但未能鏡像,請到 Bolt E4B 研究頁自行查閲。
模姐驗嚇貨
呢個模型嘅定位好清楚:唔係追前沿推理,而係喺 4GB 記憶體內做一個反應快、夠用嘅本地語音 Agent。NVIDIA 話較上代模型平均質量大約高 40%,輸出較同類模型減少約 80% tokens——呢個係廠商聲稱,唔係本站實測。對住 Jetson 板、RTX Spark 或者想本地跑遊戲角色嘅開發者嚟講,呢個係一個實際選項;但所有跑分係 NVIDIA 自跑,獨立第三方驗證仍需等待。長上下文嘅差距同 Qwen3.5 4B 嘅對比,係選模型之前要自己跑一次嘅問題。
模姐|深度調教



