
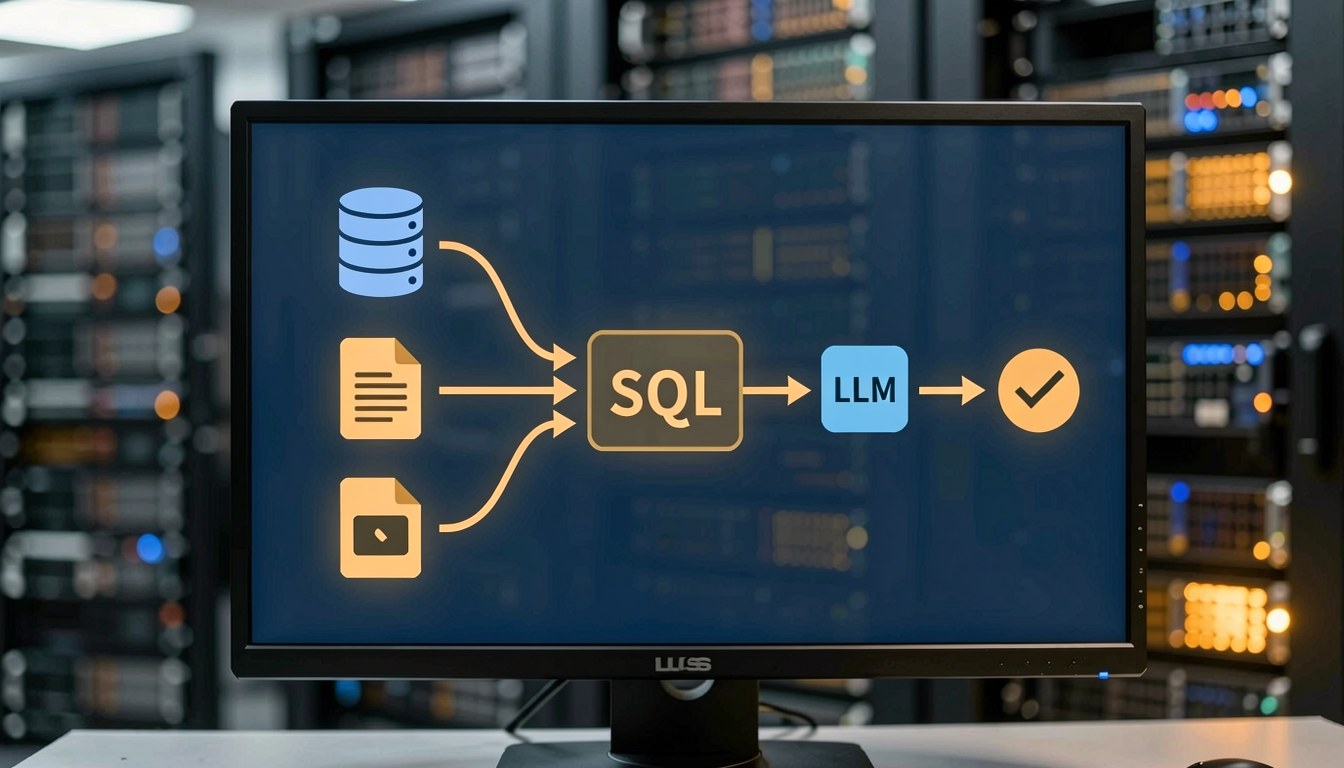
2026 年 10 月 8 日,NVIDIA 技術博聞刊出一篇文章,講 KGMON 團隊喺 KDD Cup 2026 Data Agents 組別擄咗亞軍。呢個賽叫 agent(代理,即可以自主調用工具、執行任務嘅 LLM 系統)用自然語言答覆散喺數据庫、CSV、JSON、文件、PDF、影片入面嘅問題,仲要處理分析流程入面嘅陷阱題。
重點係 KDD 規定參賽隊必須用一個小型、固定嘅 LLM 撐住個 agent,意思係你唔可以靠「換一個更大更強嘅模型」解決問題——優化空間全部喺 harness(外殼、架構,即包圍住模型嘅工具、流程、介面系統)上面。
KGMON 嘅做法可以歸納成兩條原則。
收緊行動空間
數據來源有 SQL 庫、CSV、JSON、文件、影片,KGMON 將 CSV 同 JSON 統一轉入 SQLite,再喺一個自訂持久 Python 環境入面只暴露兩個 builtin function:schema() 同 sql(query)。成個系統就只有一條查數據嘅路。呢個單一 SQL 介面減少咗 routing failures(走錯路嘅失敗)同 wasted turns(浪費嘅對話輪),畀個小模型多啲空間推理。
另外,每條任務開始之前加咗一個 read-only 嘅 schema-scouting(模式勘探)步驟:系統會先掃描有幾多張表、邊啲欄、邊啲 join key、有冇重覆名稱、相近欄、單位問題、null pattern、row grain(每行代表乜),再將呢個 context 畀 agent。呢個步驟省咗初期「揾路」嘅幾輪,減少錯欄、漏 join、搞錯每行含義嘅錯誤。
令每一步都可檢視
一次 run 可以失敗喺壞 tool call、錯 join、漏咗文件入面嘅規則、或者答案格式問題。KGMON 用 execution traces(執行記錄)、重複嘗試同 trajectory inspection(軌跡檢視)去辨識失敗嘅根源,再返去修 harness。
KGMON 喺文入面講明呢個 playbook 唔係一套萬靈丹,但佢哋提出嘅廣泛啟示係:可可靠性往往唔來自將模型做開、做自由,而來自包圍模型嗰個外殼係咪設計到對。
模姐驗嚇貨
NVIDIA 自己話出嘅經驗,用自家系統喺自家參與嘅賽事擄名,呢個係廠商自述,唔構成獨立驗證。
對香港開發者而言,呢篇文章實際可以照搬嘅係:如果你要喺細模型上面建可靠系統,第一步唔係找更大嘅模型,係將數據接入層做窄、做統一、做可審計。



