
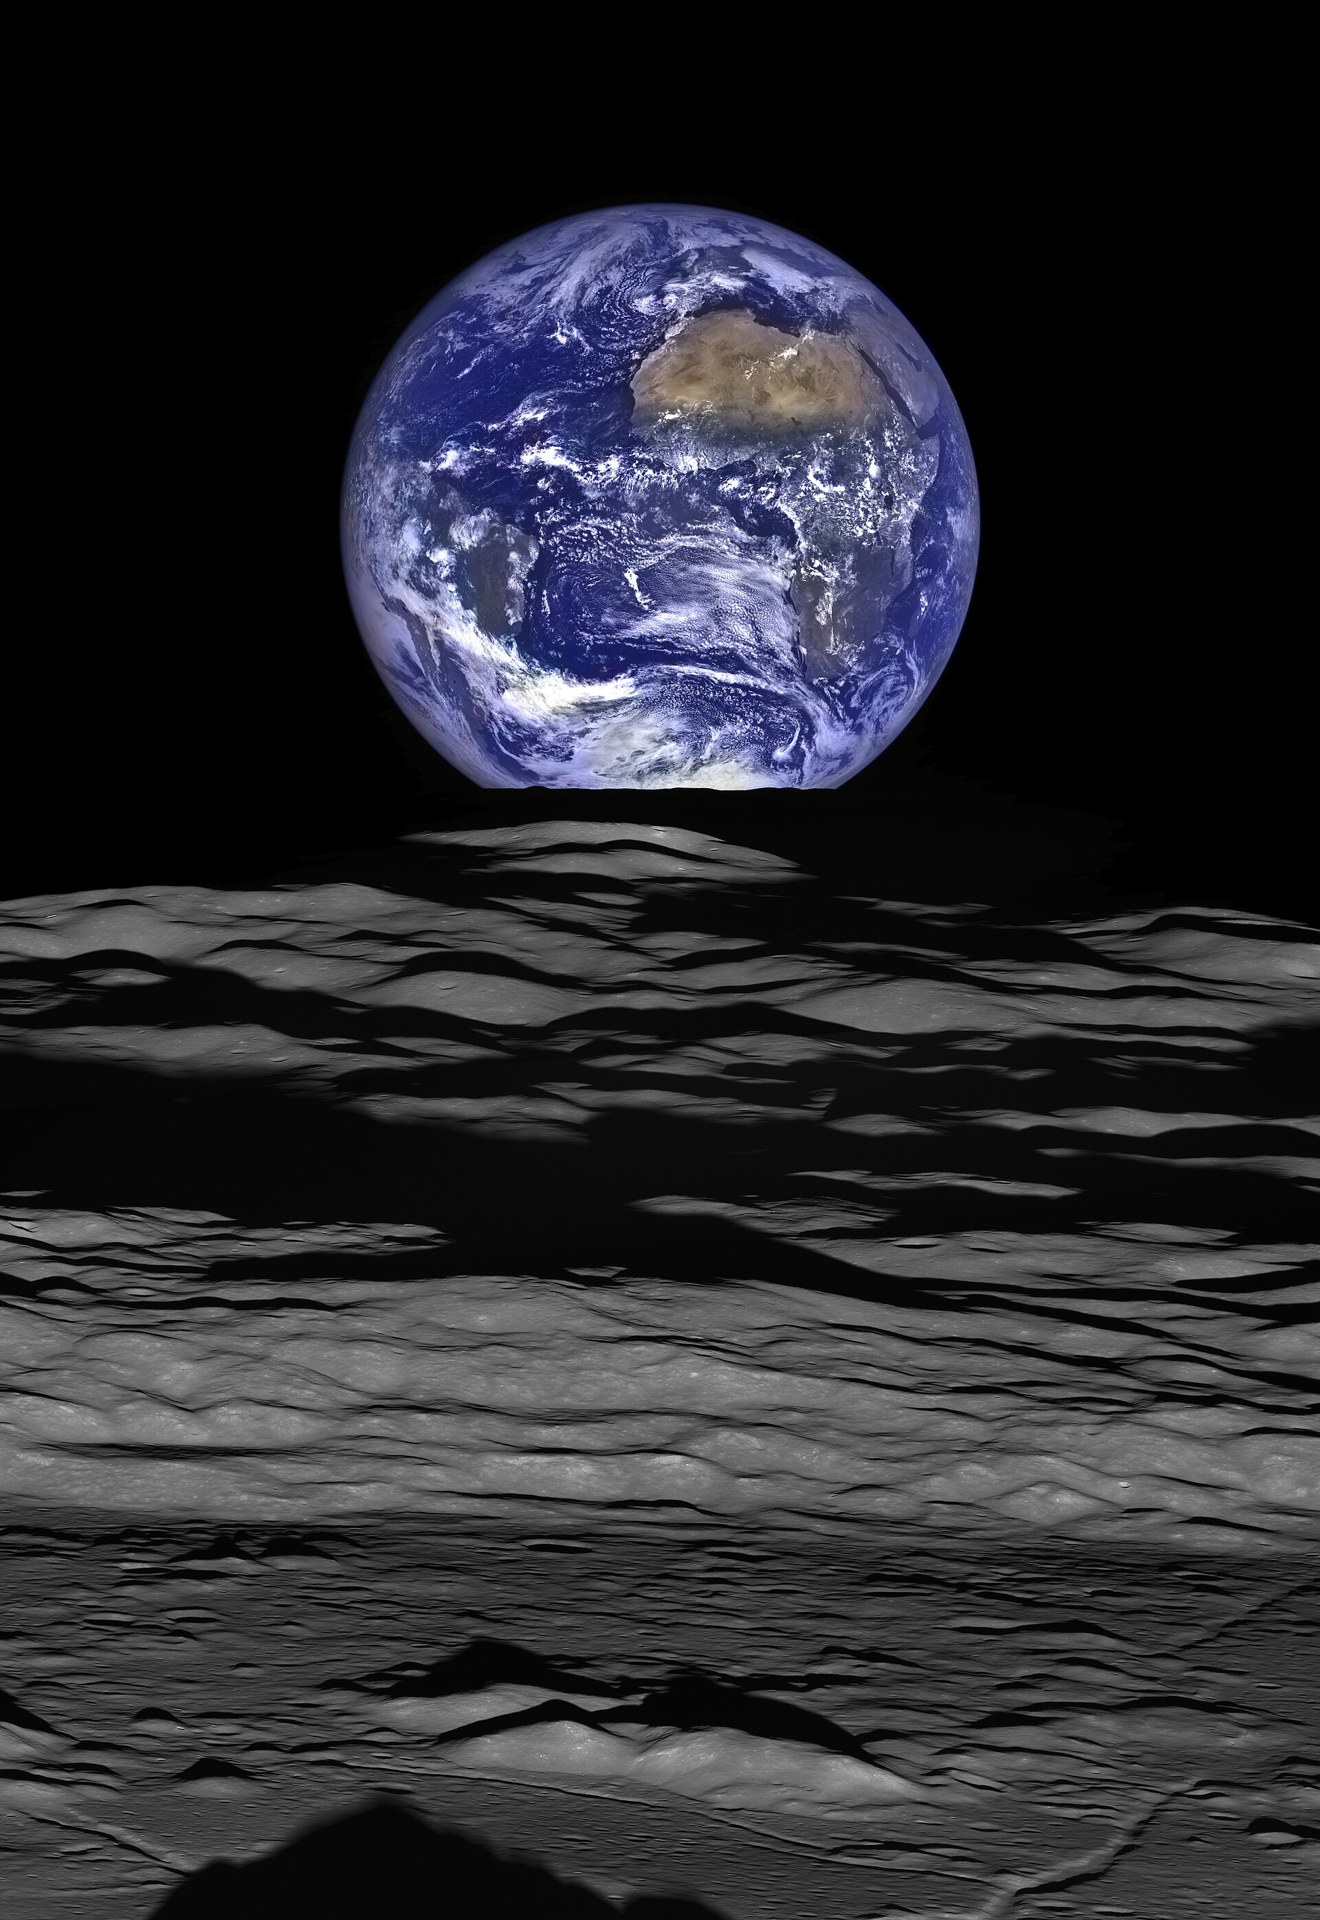
NASA同IBM同多間學術機構聯手,放咗個開源嘅「NASA-IBM月球基礎模型」。NASA同IBM話呢個係最早嘅開源月球科學基礎模型之一。NASA首席科學數據官Kevin Murphy話:「NASA用咗幾十年建咗份罕有嘅月球科學紀錄,但收集資料只係一半嘅工」,仲要畀科學家易用。
呢個模型用咗一個叫「SomBench」嘅資料集訓練,團隊稱呢個係目前最大嘅「空間對齊」多模態月球資料集,入面有接近200萬塊「tile bundle」(圖塊組合),跨11個模態、兩個空間尺度。其中約100萬張高解像度影像來自LRO(月球探測軌道器)嘅窄角相機,約1米每像素;約96.4萬張多光譜影像來自寬角相機,100米每像素。資料大部分來自LRO咗17年嘅觀測,NASA話LRO嘅資料量超過其他所有NASA行星任務嘅總和,另外加咗GRAIL(重力場)、Lunar Prospector(氫)同JAXA嘅Kaguya/SELENE探測器(礦物學)嘅資料,合共超過30個空間對齊嘅數據層,來自9個儀器、4個任務。
為咗避免訓練、驗證、測試資料之間洩漏,資料集按地圖區域划分,唔係隨機分發個別圖塊。
技術上,呢個模型基於TerraMind(一個多模態地球觀測模型),但研究團隊係從零開始訓練,唔係微調。每個圖塊,模型會直接收到成像幾何作為輸入——包括照明角度、太陽位置同圖塊範圍——因為喺月球,光照幾何對表面外觀嘅影響遠大於表面實際特性,所以團隊直接畀呢啲資訊,唔俾模型自己由原始像素去推。一個叫FlexiViT嘅技術,令同一模型可以適應唔同影像patch大小嘅任務而唔使重新訓練。
測試方面,團隊喺100米同1米尺度嘅月坑探測、極地冰礦預測,以及分節「不規則月海斑塊」(IMPs,喺月球冷卻時間線研究中具挑戰性嘅年輕火山特徵)上測試咗個模型。技術報告指出,喺所有任務中,呢個預訓練模型表現追平或超越通用基準,以及一個架構相同但隨機初始化嘅對照模型;團隊亦指出模型喺冰礦預測上優勢最明顯。
模姐驗嚇貨:NASA同IBM話呢個係開源,但權重有冇完全放開、可以點樣獲得、有冇使用限制,佢哋冇講。模型喺各任務嘅具體提升幅度,佢哋亦冇公開具體數字。呢個垂直領域嘅開源基礎模型,後續有冇其他機構接手做微調、有冇更多公開測試,都係未知。
模姐|深度調教



