
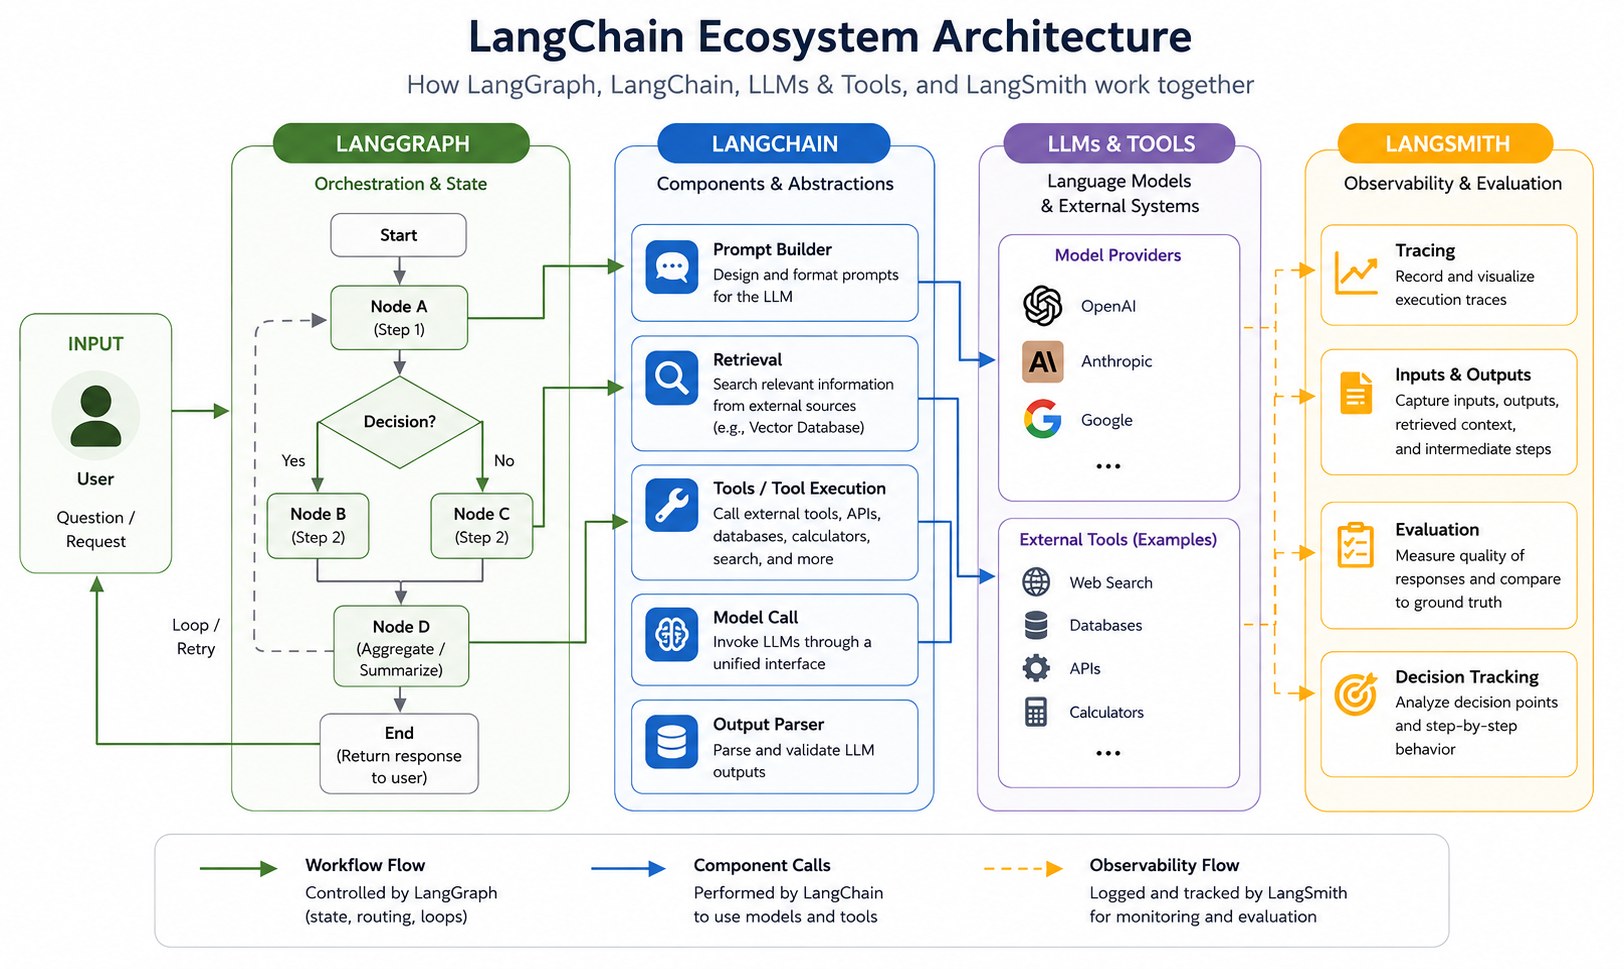
AI 代理成日要喺公司政策、手冊、工單、程式碼之間行街,揾到一段相關節嘢其實只係開頭。佢仲要知道邊條規則生咗效、邊個版本改咗、邊個文件影響咗邊個。每次都要重新拼返呢啲關係,就係又貴又容易出錯。銀行同保險呢啲政策同指引成日互相修正、取代嘅行業,呢個痛點特別明顯。
LangChain 今個星期喺自家 Blog 出咗一篇《How to build evidence-grounded agent memory with OpenWiki and Graphs》,講佢哋點樣用自家開源工具去解決。
OpenWiki:編譯成 Wiki 嘅「記憶層」
RAG(Retrieval-Augmented Generation,檢索增強生成,即係問嘢前先去揾相關文件再餵畀模型)嘅傳統做法係用語義或混合搜尋撳返孤立段,然後畀 agent 自己拼。LangChain 話揾相關段落只係一半嘢;跨來源嘅問題要追引用、解衝突規則、睇清依賴關係。
佢哋嘅答案係 OpenWiki——一個開源 CLI,建喺自家 Deep Agents 框架上面,將來源資料「編譯」成互相連結嘅 Wiki 頁面,每句都有引文返去來源。呢個 Wiki 就係記憶層:來源一改就自動更新,agent 唔使每次重造理解。呢個工具原本係俾 coding agent 用,唔使每個 task 重新「發現」架構同程式碼行為。
證據圖:畀 agent 跟 Wiki 行返去證據
OpenWiki 每句話都係一個「claim」,連住支援佢嘅來源行同嗰行嘅 hash。來源一改,hash 就變,OpenWiki 唔使叫模型就能標記受影響嘅 claim,只將嗰啲俾模型確認、修改或撤回。呢個機制令記憶層可以自我修正,同時慳 token 成本。
再喺上面加層「證據圖」——將引文同文件引用變成 agent 可以跟嘅明確圖邊。
廠商自測嘅數字(呢度要留意)
以下全部係 LangChain 自家喺**合成保險文件庫(111 份長文文件)**上嘅測試,係廠商自評,唔係獨立第三方驗證:
- 用 OpenWiki 做記憶層嘅 agent,喺跨來源問題上準確度大約係純用 grep 搜尋嘅 agent 嘅 5 倍;
- 再疊證據圖,準確度再提升 27%、引文一致性(consistency)翻倍、每個正確答案嘅成本跌 58%;
- 但喺簡單查找嘅問題,冇記憶嘅 agent 反而同準而且更快——即係呢個記憶層唔使強行派上嘅場面。
阿調搞兩下
呢篇文最值得睇嘅唔係嗰幾條跑分,係 LangChain 老實咁寫咗「簡單查找唔使記憶呢個層」。廠商自評話自己加咗層就勁五倍,呢個就係宣傳話術;願意寫出邊度唔使寫呢個架構,先至係工程嘅誠實。hash 對照做 stale detection 呢招都老毒——唔使叫模型就知道邊句記憶過時,省 token 又確定。
真正問號留喺邊:呢個方法喺真實企業文件庫、唔係合成資料,表現係咪一樣?同埋 RAG 同呢種「編譯記憶」到底係取其一,定係要行埋?呢個先係值得跟嘅問題。
阿調|深度調教



