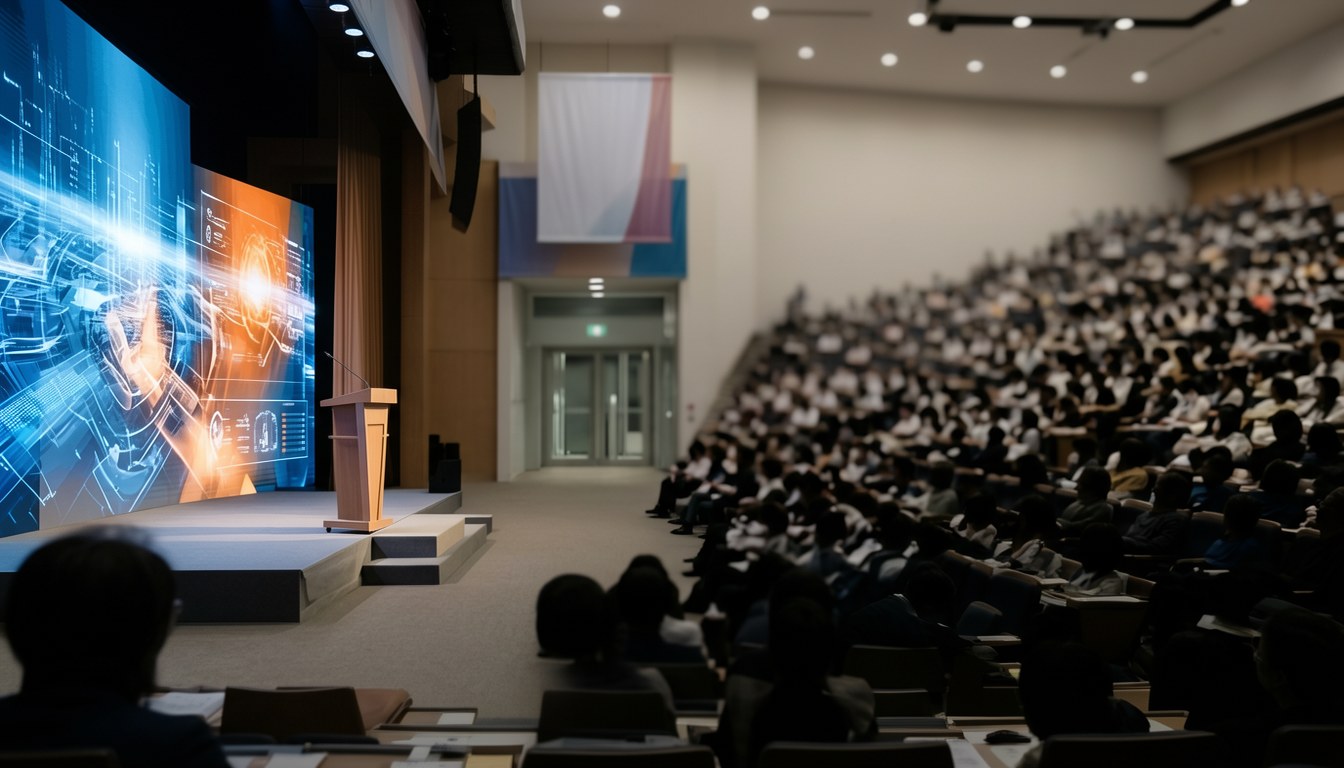
近日,2026 世界頂尖科學家論壇第二屆國際工程智能大會舉行,匯聚來自世界各地嘅科學家、院士同產業領軍者,核心議題系「工程智能」。會上,加拿大工程院外籍院士、智象元一(HiDream.ai)創始人兼 CEO 梅濤提出一個框架:大語言模型、多模態模型、具身大模型三條技術路線長遠會匯流,走向佢哋稱之謂「智能體化世界模型」(Agentic Omnimodal World Models)。
依呢個框架,世界模型主要分三個部分:
第一,LLM(大語言模型),系智能體嘅決策大腦,負責理解意圖、生成推理、制定任務規劃。 第二,Omni-Model(通用世界模型),繫世界模擬器:基於 LLM 嘅意圖,模擬物理世界運行,推演行動後果,並預判下一步動作。 第三,Embodied Context(具身上下文),對接真實物理環境,執行具身行動,並將真實觀測數據回傳校準世界模型。
三者協同,梅濤用嘅詞系「One Token Space, One World」,即喺同一個 Token 空間入面,思維世界同物理世界統一。
背景數字
演講中引咗幾個數字做背景。據 AI 模型聚合平台 OpenRouter 數據,截至今年 10 月,中國周 Token 調用量達 93 萬億,系美國嘅 4.16 倍,連續 26 周居全球第一。
另據演講指,2023 年大模型基本按 12 個月週期迭代;隨住遞歸自我改進(RSI,Recursive Self-Improvement)推動 AI 進入自我加速軌道,模型迭代已按周推進。
演講亦提 Digital AI 同 Physical AI 嘅差距:數字智能喺文本、代碼、視頻生成乃至數學研究已喺專家水平甚至超越,但物理智能受制於物理理解薄弱、交互數據匱乏同閉環執行能力不足。世界模型就係橫跨呢條鴻溝嘅橋樑。
智象嘅產品架構
智象話自研咗原生全模態(Unified Transformer,UiT)模型架構,讓文本、圖像、視頻、空間、位姿、力觸、傳感器等模態統一表徵。基於 UiT,佢哋搭建咗世界模型矩陣,涵蓋圖像、視頻、交互模型 HiDream-O1-World、具身模型 HiDream-O1-Embodied。
商業化架構系「1+1+3」:底層原生全模態世界模型矩陣,中間企業級模型平台 HiHarness,最上層三個智能體,包括 AIGC 商業營銷智能體 HiBurst、影視創作智能體「幀贊」、內容創作智能體 vivago。
應用方面,佢話喺具身智能領域,世界模型可規模化合成毫米級高精度動作視頻,為真機訓練提供數據;喺生命科學領域,與合作企業喺多尺度生物影像統一表徵上,就細胞演化嘅理解與預測,為藥物響應評估提供前置參考。
阿調搞兩下
呢個框架聽落都唔錯,但講到底,呢篇框架系佢哋自己提出,冇第三方獨立驗證,亦冇公開 benchmark。三條路線「終將匯流」呢句,系觀點,唔系既成事實;「One Token Space, One World」呢句,好 slogan,但冇技術細節跟住。至於 93 萬億周 Token、按周迭代呢啲數字,系 OpenRouter 同 RSI 框架嘅數據,同呢次演講嘅核心主張系唔同嘅事。讀呢篇演講,要清楚咗呢幾層,唔好把廠家嘅路線藍圖當技術共識。
阿調|深度調教