一個模型搞唔掂一廠鏡頭,點做?
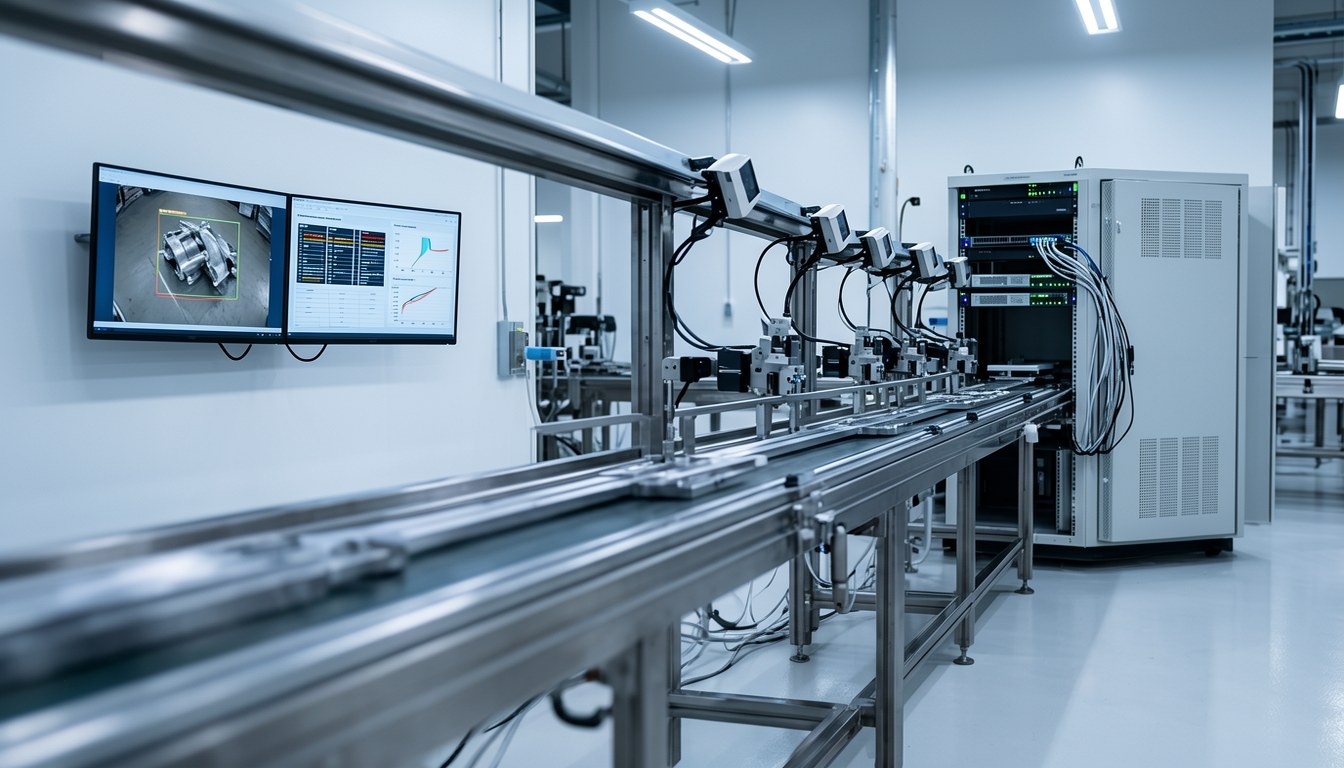
工廠質檢嘅視覺模型,一個鏡頭一個模型都係正常。但當同一樣質檢要做到 40 條產線、每條線幾個鏡頭,每個鏡頭角度唔同、同一不鏽鋼表面嘅反光都唔同、旁邊開唔開 bay door 都會影響環境光。一個用混合 footage 訓練嘅模型,唔夠「逐個鏡頭」微調嘅版本勁。問題就唔係「點訓練一個模型」,而係「點訓練、評估、版本化、部署成百上千個,而唔使每人都要人手介入」。
SageMaker SDK v3 更新架構
呢篇係 AWS Machine Learning Blog 更新 2023 年《Build an end-to-end MLOps pipeline for visual quality inspection at the edge》系列嘅新版。主要變化:已停用嘅 SageMaker Edge Manager 換做 SageMaker Neo 做邊緣優化;全架構用 SageMaker Python SDK v3 重寫。
雙分支訓練流程
每個鏡頭對應一條「雙分支」SageMaker Pipeline,每次執行跑 13 個步驟,三個入口步驟並行:Preprocess、Fetch Latest Anomaly、Fetch Latest Classifier。
- 異常偵測:小型卷積 autoencoder(自動編解碼器,一種只靠重構正常樣本來偵測異常嘅神經網絡),學「正常產品」長乜樣,再靠重構錯誤 flag 異常。
- 缺陷分類:ResNet18 分類器微調,確認係乜嘢缺陷。
兩邊各自導出 ONNX,用留出數據評估,過質量門(quality gate,唔達標就攞住唔行),先經 SageMaker Neo 編譯到目標邊緣設備,先入 SageMaker Model Registry。每次 warm-start 都按鏡頭 ID 過濾,意思係重訓永遠係從「呢個鏡頭」自己嘅歷史起步。
編排層:唔好一次湧入
重訓請求落 SQS FIFO queue,Lambda 起 Step Functions execution,每個 execution 行前向 DynamoDB semaphore 攞一個 slot。意思係就算一次湧入一堆請求,都係「慢慢行」而唔係一次全部開跑。
成本
全 pipeline 喺合成數據上跑,計算成本約 $0.07。完整 sample 喺 aws-samples GitHub repository。
阿調搞兩下
一個「每個鏡頭一個模型」嘅架構,唔係「一個大模型搞掂一切」,而係「一組小模型互相隔離」嘅工程問題。呢種設計對工廠環境係好實在——因為每個鏡頭嘅光線、角度、反光都唔同,一個模型強迫遷徙到所有鏡頭,精度會明顯掉。呢個「質量門」就係關鍵:唔達標嘅模型唔行註冊,而唔係「部署之後先發現有問題」。
邊個揸住個掣?喺呢個架構,SageMaker Neo 編譯喺 pipeline 入面,意思係「部署到設備」呢步同「訓練」一樣自動化,冇人喺中間改模型。呢個對工廠管理員係好事:模型版本追蹤、重訓歷史、質量門紀錄全部集中喺 Model Registry,冇「呢個鏡頭點解突然變了」嘅黑盒。