英國數字健康公司 Numan 日前喺 LangChain 嘅部落格分享咗佢哋點樣建構「Nu」——一個俾病人管理長期健康狀況嘅 AI 教練。Numan 嘅病人涵蓋體重、荷爾蒙同性健康範疇,好多都喺減肥計劃入面,日日開 app 跟進度。
點解標準評測行唔通
Numan 自述,最初就係跟住一般做法:預備輸入同預期輸出嘅數據集,再用 LLM 打手(judge)逐句打分。但佢哋發現呢套喺「教練」場景完全唔得:
第一,單輪靜態評測(single-turn eval on static fixtures)失真。 行為教練冇唯一正確答案,一句回覆安唔安全,要靠成段對話先判斷得出。Nu 需要喺整段對話先睇清患者卡喺邊,先至俾到合適建議,患者硬要推就要守住界線。而平均分數會掩飾個別爛回覆——幾句差答喺成個數據集入面幾乎攪唔動個數,令對話表面合規但其實冇合規。更尷尬係,有一次成組低分原來係評測本身嘅錯:rubric 預期兩輪之內同時做同理、探索同建議,但人類教練會喺多輪逐層推進。Nu 其實做得好,但過窄嘅評測錯判失敗。
第二,寫死嘅多輪腳本(scripted multi-turn)一樣崩。 寫死第二輪患者會講乜,測試就會忽略 Nu 第一輪實際講咗乜。一旦 Nu 講咗腳本預期以外嘅嘢,後面所有回合都係喺一個從來冇發生過嘅對話入面回應,評測即刻失據。
而家嘅做法:分主題、分場景評測
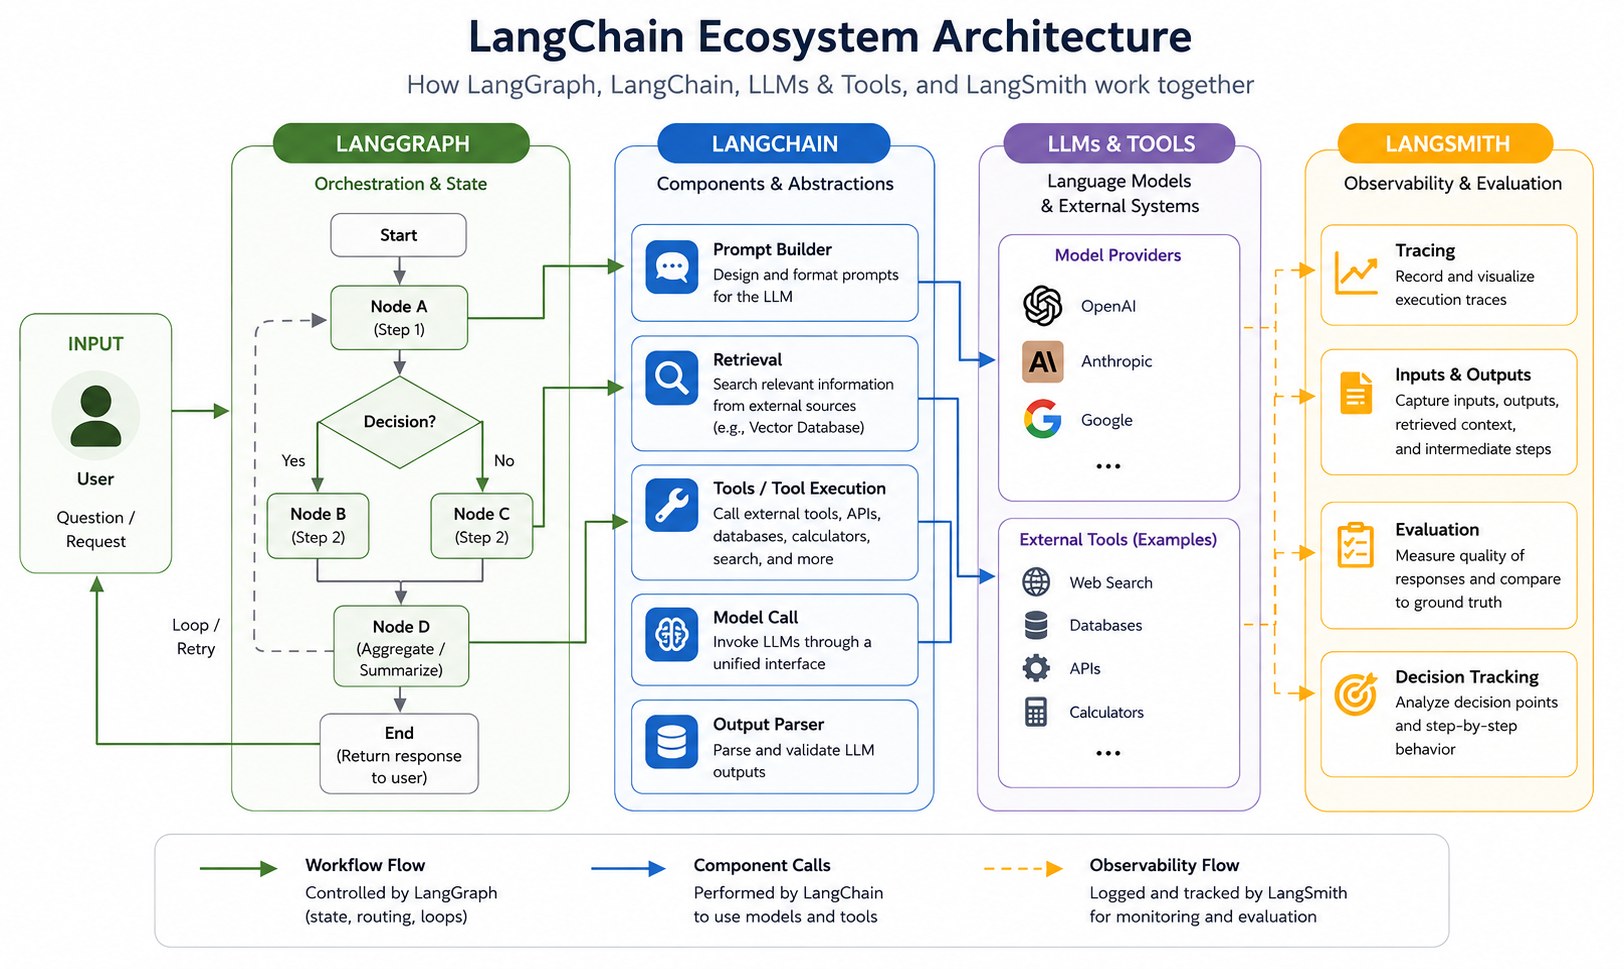
Numan 稱 Nu 係一個 LangGraph(圖結構)agent:一個 supervisor 模型協調分派畀不同領域嘅 specialist 子 agent,每個 specialist 有自己嘅 prompt 同工具。呢個組成方式有兩個好處:新增一個 specialist 成本低;更重要係所有 specialist 嘅評測表面(evaluation surface)保持一致。
部分事情可以喺單輪就判斷:supervisor 有冇分派去正確嘅 specialist、藥物問題有冇俾到安全答案、safety guard 有冇攔到該攔嘅嘢。針對呢啲,佢哋跑分主題嘅數據集,涵蓋:
- 教練質量(coaching quality)
- 安全(safety)
- 藥物查詢(medication queries)
- 路由(routing)
- 摘要(summarisation)
同原有單輪評測相比,Numan 改咗兩樣嘢,第一係每個數據集按類別打分,唔再混做一個平均分。
Numan 強調,健康教練同醫療診斷、開藥、臨床決定係明確界線,呢啲係高度受監管醫療空間嘅嚴禁事項。佢哋最初聚焦喺 agent 本身同自動化,最後發現真正關鍵係評測標準嘅質量——呢個先係確保用户體驗同時避開監管紅線嘅根本。
阿調搞兩下:健康 agent 最難嘅唔係模型幾聰明,係點樣令佢清楚知道自己唔可以做嘅嘢。做診斷、開藥呢啲界線唔可以由 prompt 一句「你唔好做」就搞掂,要靠成套可驗證嘅評測體系先至信得過。Numan 呢套分主題、分層次嘅 eval 先係值得其他醫療 AI 團隊參考嘅做法。
阿調|深度調教