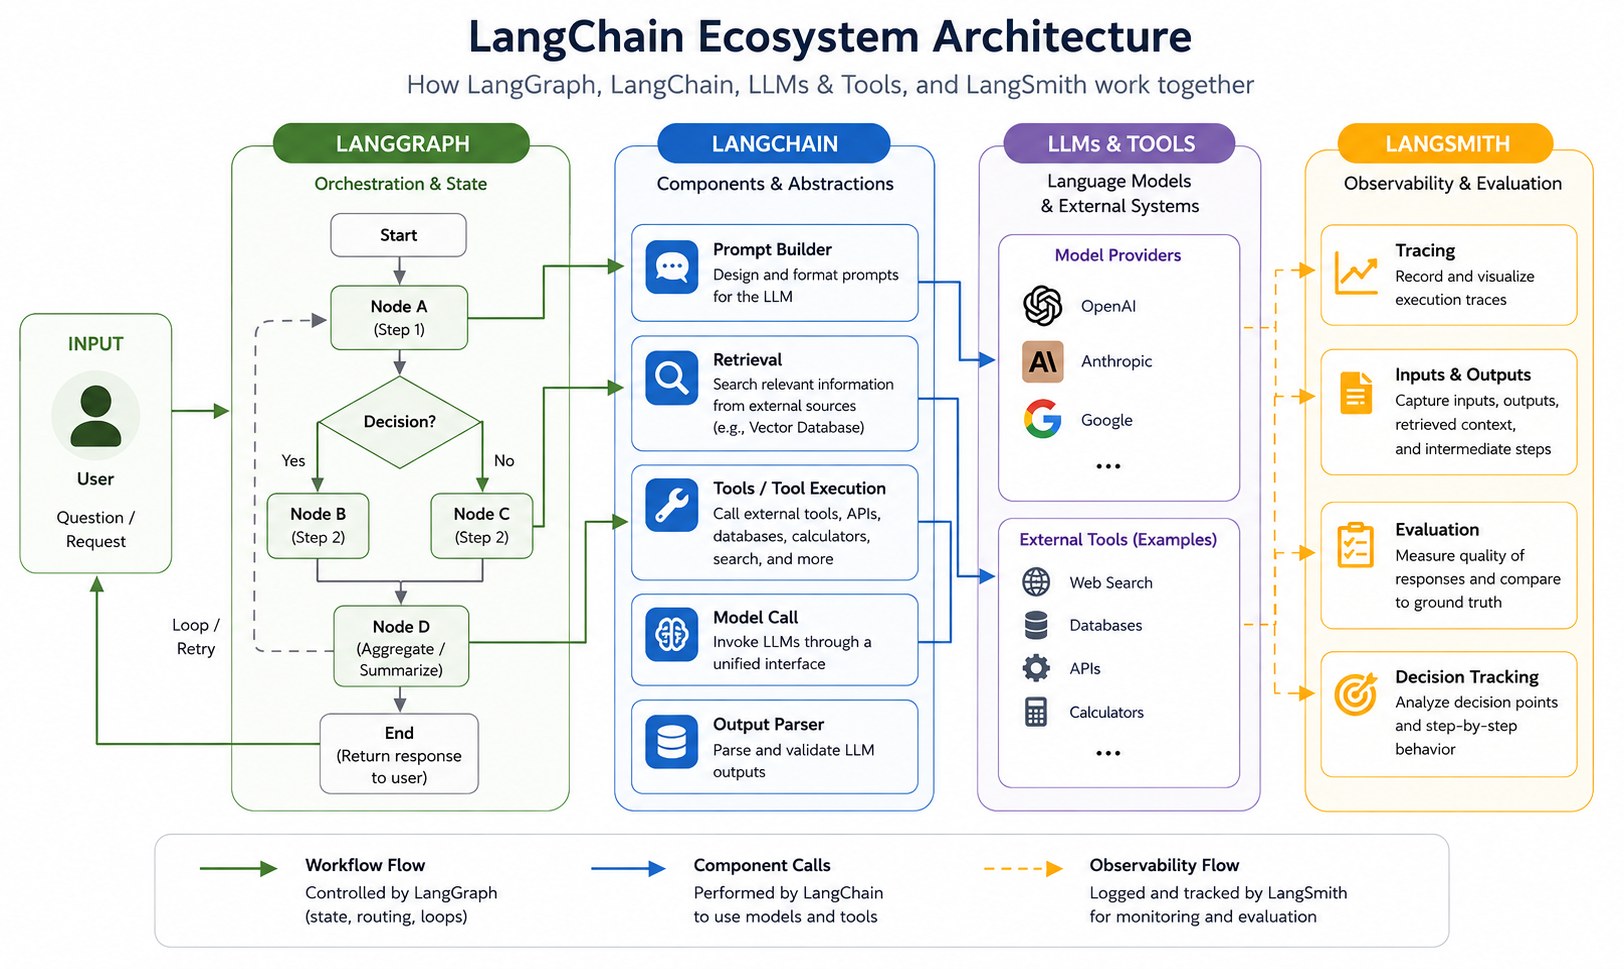
LangChain 喺 2026 年 11 月 3 日發表了一篇博客,講明喺 AI Agent(能自主執行多步驟任務嘅系統)走向更長、更複雜嘅任務過程中,人類審查(human review)唔係可選附加,而係「戰略必需」——因為單靠自動化評測已經睇唔到所有問題。
文章列出三個原則,拆解點樣將人類專家嘅判斷變成可持續推動改進嘅數據。
原則一:專家判斷定義「乜嘢叫夠好」
每段 Agent 嘅執行紀錄(agent trace,即用户訊息、模型回應、工具調用同中間步驟嘅完整記錄)本身唔會講「邊度好、邊度唔好」。領域專家(domain expert)帶入嘅判斷——呢個工作入面「夠好」嘅定義係乜、用户想做嘅嘢係乜、Agent 應該點做先啱——呢啲係紀錄本身冇嘅東西。
博客引述 Snoop Dogg 喺 CSU Long Beach 嘅畢業典禮演講:「Nobody can do you, like you do」,意思係呢種專家判斷極度針對性,同公司、崗位、個人經驗綁住,係做出有差異化 Agent 嘅關鍵。
另外,專家審查未必只係指出 Agent 答錯咗,仲可以發現評測標準本身有問題——例如某條 eval 嘅計分邏輯有誤,或者評分準則(rubric)有漏洞。一條 annotation queue(標註隊列)入面嘅簡短備註,可以揭示出評測器本身需要修嘅更大模式。
原則二:上下文先至令判斷站得住
根據前文結構,呢個原則講嘅係:審查者需要睇到完整對話脈絡——包括之前嘅訊息同工具調用——先至有能力判斷 Agent 點樣、點樣走到某個結論,而唔係只看最後一句輸出。
在 LangSmith 平台,隊列項目可以係單一 run(單一步驟)或者 thread(完整多輪對話)。睇到完整 thread,審查者見到嘅係用户同 Agent 真正發生嘅對話,唔係被割開嘅其中一步。
原則三:人類反饋係未來評測嘅基礎
結構化嘅評分同審查者備註,可以用嚟:
- 校準 LLM judge(用大模型做自動評判嘅系統)
- 改善在線評測器(online evaluator)
- 建立 golden dataset(金標準測試集)做持續測試
即係,專家嘅單次審查唔係一次性消費,而係被儲存喺 run 或 thread 上面,作為「分數 + 審查者理由」,供下一次迭代參考。
阿調搞兩下
LangChain 呢篇文章嘅核心論點其實好直接:自動化評測可以挑出「有嘢唔啱」,但「乜嘢算啱」呢個問題,自動化唔能夠自答。呢個唔係 AI 能力唔夠,而係定義問題本身就係人嘅工作。
值得留意嘅係,呢套框架對企業用户嘅實際意義:如果你嘅公司正喺部署 Agent 處理業務流程,呢三個原則嘅落地成本唔低——你需要訓練有領域知識嘅審查者、建立結構化嘅標註流程、將備註轉成可重用嘅評測數據。呢個唔係「加個 AI 就搞掂」嘅嘢。
問題嘅另一面係:呢套 human-in-the-loop 嘅數據,由邊個擁有?審查者嘅判斷同專家經驗,最後係歸公司資產定係歸 Agent 廠商嘅訓練資料?呢個問題 LangChain 嘅文章冇講。
阿調|深度調教