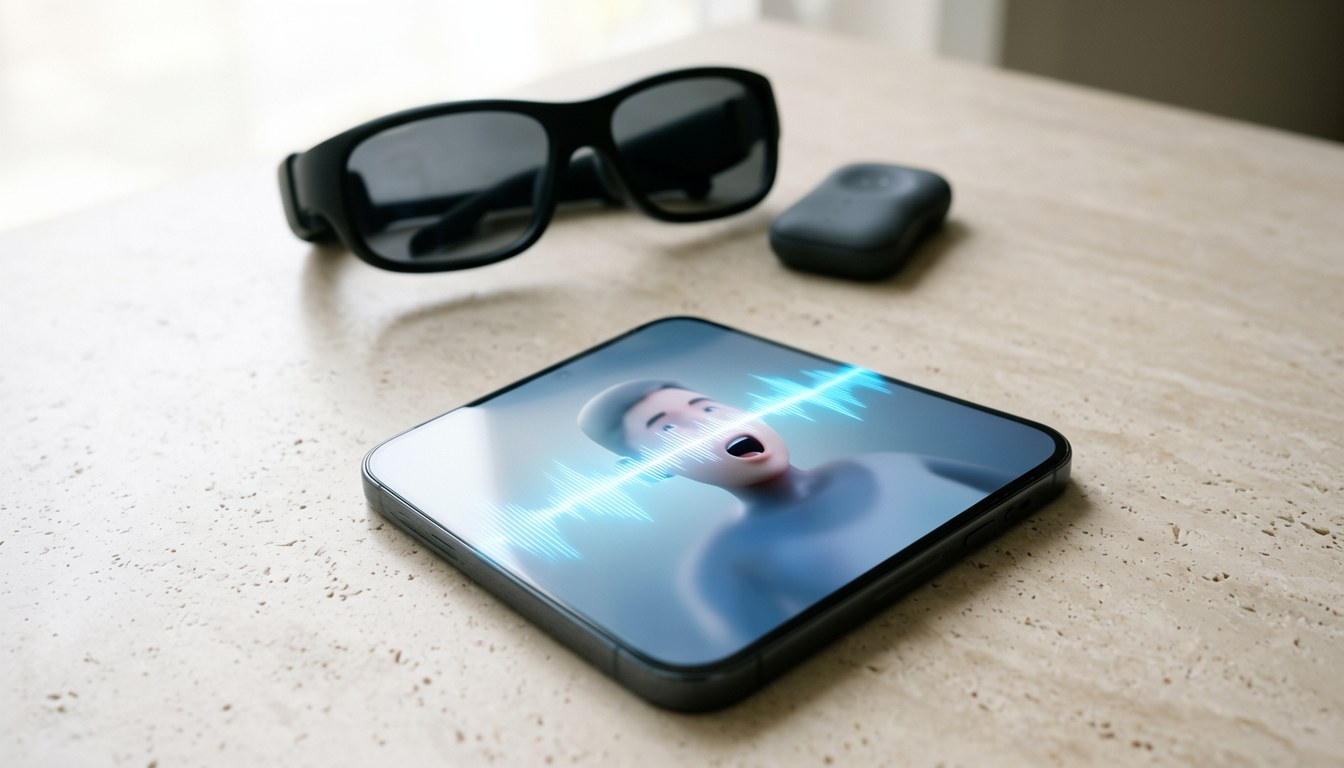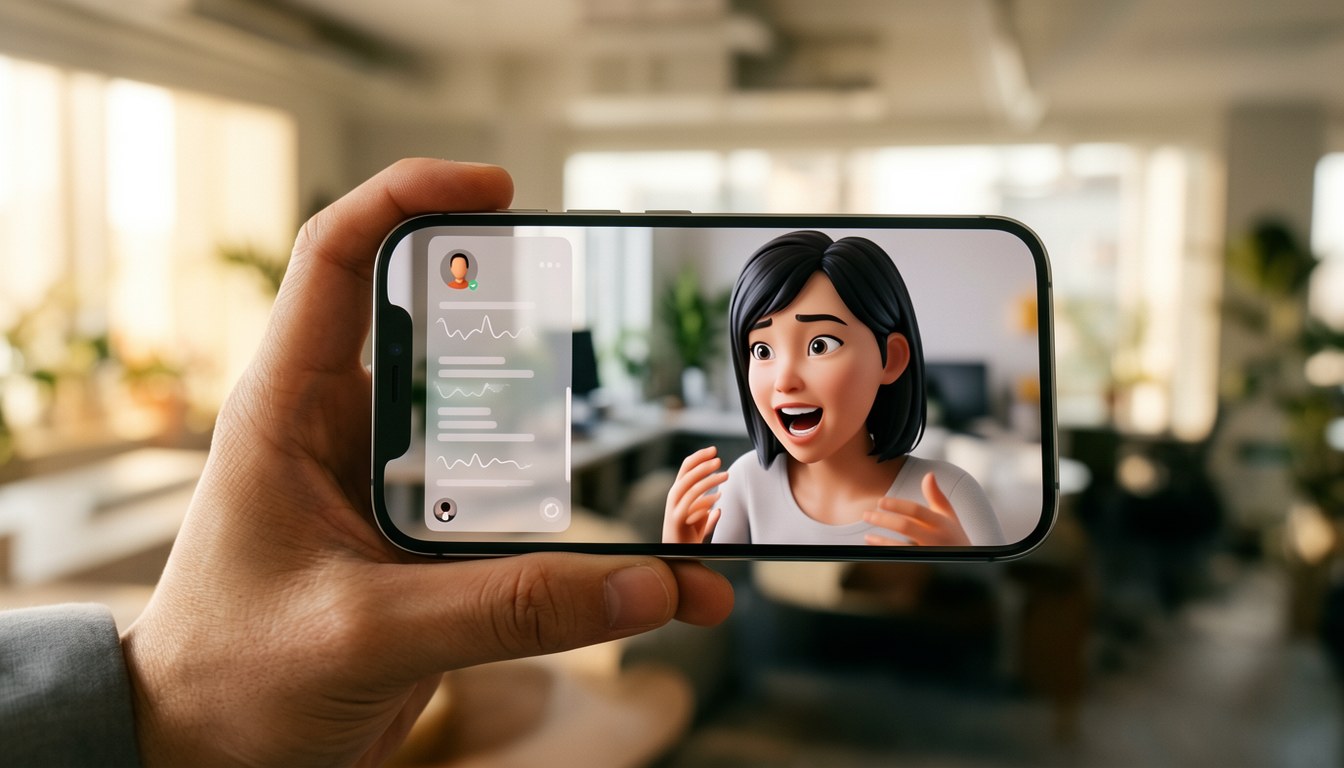
Meta 喺美國時間 11 月 5 日喺自己嘅個人 AI 代理 Muse 度開咗個大閘:即時語音對話,仲附送一個會做表情、比手勢嘅虛擬形象(avatar,Meta 起咗個名叫做 Jolly)。呢個功能而家先限美國用,其他幾時有,Meta 冇講。
點用
手機、網頁同 Mac 三個平台都有。畫面右上角個電話 icon 撳一下就開工,講緊嘢都可以隨時打斷佢,跟真人傾偈冇分別。畫面提供三個顯示級數:淨係有聲、形象放喺對話旁邊、全螢幕面對面。聲音有幾百種揀。
形象會用細微表情同手勢配合語氣,你講緊嘢佢都有反應,唔會扮死。用户亦可以自訂形象,改成人類、動物或者其他任何角色。Meta 認為將 AI 擬人化可以令用家同自己嘅 AI 建立更強嘅連結。
背後點做嘅
呢個功能由兩個新模型驅動:Muse Realtime Voice 同 Muse Realtime Avatar。
Muse Realtime Voice 負責聽同講,輸出一串編碼過嘅「語音 token」(語音編碼),同時帶住語義同語氣。呢串 token 一邊變成聲,一邊交畀 Muse Realtime Avatar 去生成畫面,所以嘴型、表情同聲能對得上。
Muse Realtime Avatar 係擴散 Transformer(diffusion transformer)模型,將影片切成一小段一小段逐段生成,每段最新畫面做下一段嘅參考,對話幾長都可以跟住生成。
技術上嘅難題係速度。原本嘅「老師模型」每段要 120 次運算。Meta 用蒸餾(distillation,即俾小模型跟大模型學)做出「學生模型」,只需 2 次運算,少了 60 倍,畫質跟老師模型接近。
規格:直式 448×768、每秒 25 格。由用户講完到收到第一個畫面同聲,延遲約 870 毫秒。喺一顆 NVIDIA GB200 上,每步生成 8 格(0.32 秒)只需 20 毫秒。經 4 位元量化等調校後,服務容量比基準高 8 倍,單顆 GB200 可以同時跑 12 個即時對話,呢個調校係 Meta 同 NVIDIA 合作嘅。
比別家差幾多?
呢個係 Meta 自己做嘅評測,唔係獨立測試:評測者用同一個角色分別同 Muse、Runway Characters、HeyGen LiveAvatar 各聊 2 到 3 分鐘,再比畫質、舉止等。整體偏好 Muse 對 Runway Characters 係 78% 比 22%,對 HeyGen LiveAvatar 係 88% 比 12%。但 Meta 自己註明「舉止」呢項同 Runway 嘅差距喺統計上唔顯著。
佢未講嘅幾件事
第一,收費。Muse 免費用但有限額:Power 方案每月 20 美元、每週 5 億 Muse token;Maximum 每月 100 美元、每週 30 億。但説明頁冇提到語音或形象,新公告亦冇講語音對話係咪付費、食幾多額度。呢個而家冇答案。
第二,開放範圍。Muse 9 月先喺美國上線,10 月 28 日新加坡先開,限 18 歲以上。語音同形象呢,先限美國,其他地區 Meta 冇公佈時程。
第三,形象上傳。Meta 研究部落格寫模型可以拿「任何圖片」當參考即時動態化,但新公告冇講用户可唔可以上傳自己或他人嘅照片當形象。
另外,Meta 話生成嘅影片會用 Video Seal 技術嵌入不可見浮水印,用嚟追溯來源,唔會加延遲。語音對話「即將」支援 AI 眼鏡同 Muse Charm 口袋裝置;Meta 計劃喺年底推出類似 Tamagotchi 嘅穿戴裝置,虛擬形象會顯示喺塊小螢幕上。
馬斯克 11 月 1 日喺 X 上講 Grok Bot 嘅服務成本相對於營收高到唔持續。Muse 形象喺一顆 GB200 上同時只撐 12 人對話,免費版讓人講幾耐、付費版有冇包含呢項,Meta 都未交代。
阿調搞兩下
Meta 今次嘅手腳幾快,但最有趣唔係技術本身,係佢故意唔講嘅嘢。免費版幾耐、有冇語音、其他幾時開——全部冇講。呢個唔係疏忽,係策略:先喺美國測試、收數據,其他市場跟住先開。對於用家,最實際嘅問題唔係技術好唔好,係你嘅數據、你講嘅嘢,被生成咗成一個有表情嘅動畫人物,邊個揸住個掣?答案而家仲喺 Meta 部。
阿調|深度調教