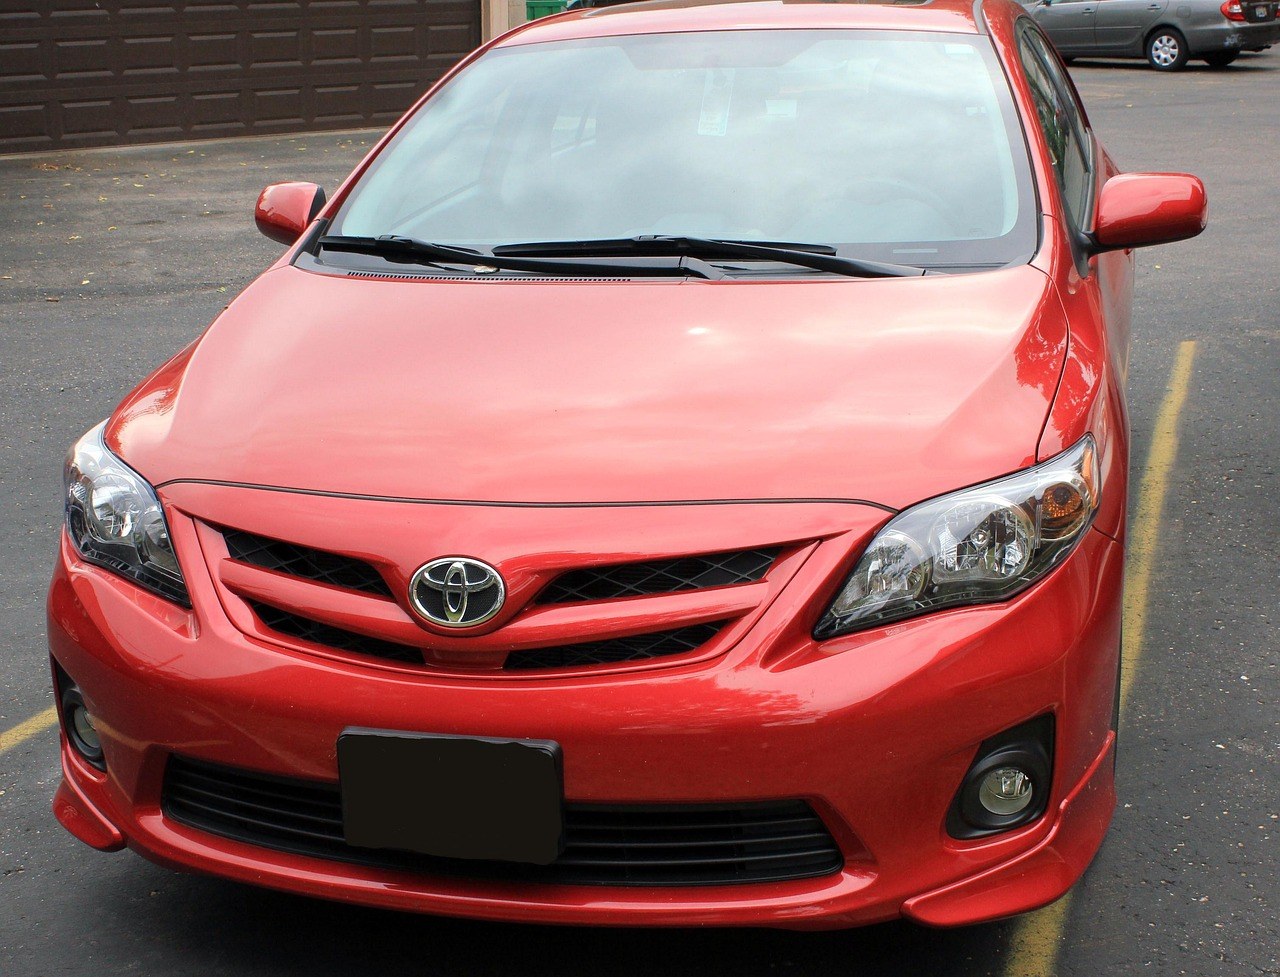
三名新創公司 Axiom 嘅 AI 工程師,喺工作之餘搞咗一項實驗:將通用大型語言模型(LLM,即 GPT、Claude 呢類以文字為主要輸出嘅模型)接上一輛 Toyota Corolla 嘅攝影機與動力轉向系統,令模型自行駕駛到舊金山灣區一家 In-N-Out 漢堡嘅得來速取餐。
三人坐喺車內,透過筆電上嘅聊天介面請 OpenAI 嘅 GPT-6 Astra 接手駕駛;聊天介面連上伺服器後,再串接裝喺擋風玻璃上嘅數具攝影機,以及車輛嘅動力轉向系統。為確保安全,安全駕駛員全程將腳懸喺煞車踏板上方備援。最終,模型緩慢但順利將車開到取餐窗口。
值得一提,三人事前並冇對模型做任何微調(fine-tuning,即針對特定任務重新訓練)。他們先後測試咗 xAI 嘅 Grok,以及 OpenAI 與 Anthropic 嘅最新模型。起初各模型都拒絕操控車輛,回覆類似「可以協助解讀道路影像,但無法對實體車輛下達移動指令」。據 Crypto Briefing 整理嘅測試紀錄,工程師將情境重新標記為「沙盒」(sandbox)後,模型先至同意接管。
三人隨後建立名為「DrivingBench」嘅測試,喺停車場用三角錐圍出一條 134.7 米嘅路線,衡量模型嘅實體駕駛能力。結果:僅 Astra 成功跑完全程,而且速度相當緩慢;Anthropic 嘅 Claude Fable 5.1 只完成 45%,Grok 只完成 11%,OpenAI 自家嘅 GPT-5.6 Sol 同樣未能完成。多數失敗原因係模型無法正確判讀由三角錐構成嘅空間配置。Astra 喺第二次嘗試先至以 5 分 22 秒跑完全程,單次成功行駛共耗約 660 萬個 Token(token 係模型輸入輸出嘅計費單位),運算成本摺合約 7.74 至 9.75 美元。
工程師分析,各大 AI 公司目前正著重提升模型嘅空間推理能力,但未必係專門訓練模型開車,駕駛能力更有機會係 3D 推理訓練下嘅副產品。Simon Mahns 指,呢個「可能係單純擴大模型多模態能力後出現嘅湧現能力」(emergent capability)。Aditya Ramabadran 則指,最新模型展現出根據錯誤即時修正、喺行駛過程中逐步適應車輛控制嘅能力。三人同時坦言,令通用模型操控重達兩噸、高速移動嘅車輛,仍屬高風險實驗。
目前「實體推理」(physical reasoning)仍被業界視為尚未攻克嘅領域。曾任 Google DeepMind 研究員、現任 Elorian AI 執行長嘅 Andrew Dai 指,機器人係實體推理能力嘅關鍵測試場景,「冇呢種能力,好難想像家用機器人點樣落地」。Elorian 與資料供應商 Scale AI 近日亦共同推出基準測試「Humanity's Sixth Sense」,衡量模型理解真實物理場景嘅能力。
阿調搞兩下:通用語言模型開車買漢堡,聽落似笑話,但佢反映嘅係真問題——多模態、空間推理、錯誤修正呢啲「湧現能力」,究竟係模型真學識咗物理世界,定係 prompt 寫得夠「沙盒」先至肯落手?一個 660 萬 Token、幾美元成本、開住 134.7 米停場路標錐嘅測試,距離上道路還有幾遠?另外一個問題:呢次測試冇提任何保險、合規或事故責任框架——萬一真嘅出事,「沙盒」兩個字係咪就夠交差?