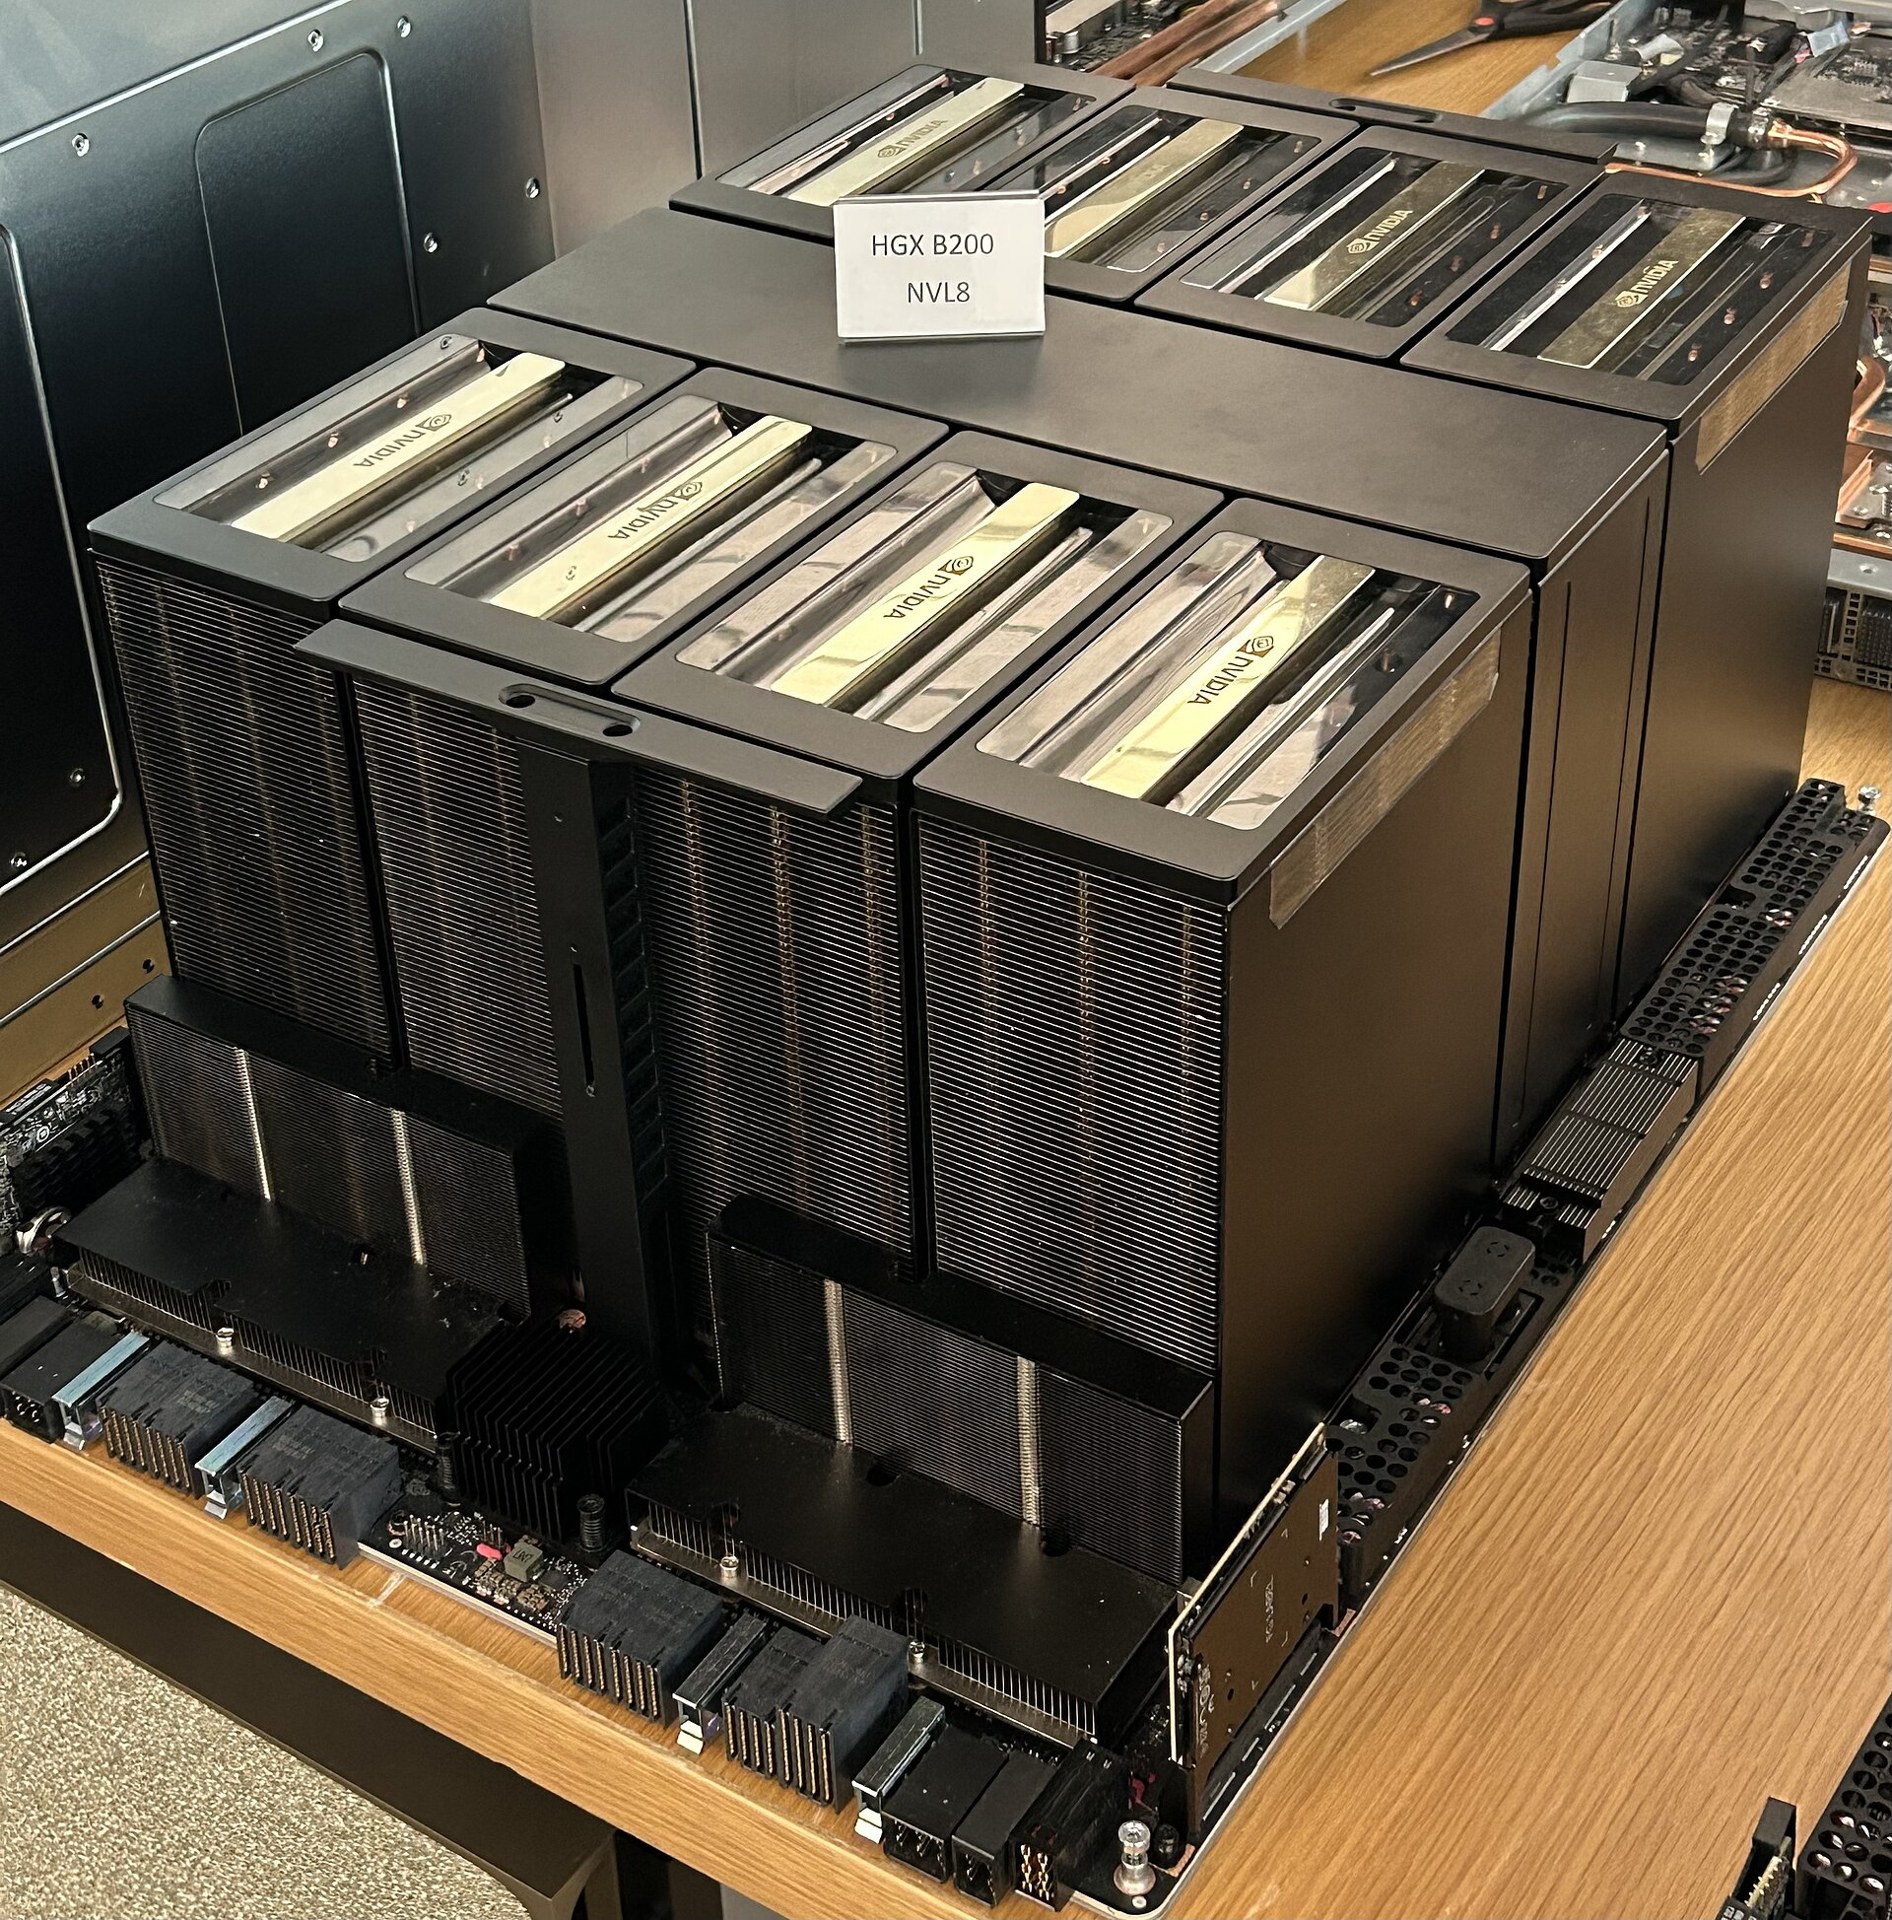
NVIDIA 今個月初喺自家技術部落格(NVIDIA Technical Blog,2026-11-06)刊登了一篇部署教學,示範點樣將 Black Forest Labs(BFL)嘅 FLUX 3 Image Klein 喺自家 Blackwell 系列 GPU 上面跑,並逐層拆開推理加速嘅每個優化層面,最後喺自家 GPU 上面量出提速數字。呢篇嘢,講清楚係「廠商教你點樣喺自家嘅晶片上面跑自家嘅 stack」,呢個定位先至係理解下面所有數字嘅前提。
模型本身點樣組成
FLUX 3 Image Klein 係 BFL 出嘅圖像編輯同生成模型,文章交代佢喺 NVIDIA GB200 NVL72 上面訓練、針對 NVIDIA GPU 優化,提供 Base 同 distilled(蒸餾)兩類 checkpoint,對應唔同延遲同品質嘅需求。架構上拆三層:文字端用 Qwen3-VL-4B-Instruct 做 conditioning,中間一層係 diffusion transformer(DiT,擴散變壓器,負責將帶噪聲嘅 latent 逐步去噪)精煉 latent,最後由 autoencoder 解碼成圖,亦負責將圖生圖(image-to-image,I2I)嘅參考圖編碼。文字、目標圖同參考圖三條流先各自獨立處理,再用 joint attention 合成。
 圖片:Javils00/CC0/Wikimedia Commons
NVIDIA 測試嘅條件
教學入面嘅對比測試跑喺單張 NVIDIA B200 GPU,2048×2048 輸出。Base checkpoint 用 50 步去噪、classifier-free guidance(CFG)scale 3.5;蒸餾版 Klein 只行 16 步、無 CFG。文章交代結果係兩輪 warmup 之後再平均 10 次請求,基準線係未編譯嘅 BF16 inference。
優化路徑係由低精度量化開始:VisualGen(TensorRT LLM 入面嘅專屬運行時)上線即支援 BF16、FP8、NVFP4。NVFP4(4-bit 浮點)單單換量化就交出了 T2I 最多 1.62 倍、I2I 1.58 倍嘅提速。喺 NVFP4 基礎上再疊 fused kernel、稀疏 attention、caching 同多 GPU 並行,文章寫出嘅結合提速係 T2I 最多 3.46 倍、I2I 最多 4.45 倍,對象係 FLUX 3 Image Klein Base,對比係未編譯嘅 BF16。FlashInfer 嘅 PrimsTS GEMM kernel(基於 CUTLASS Primitives)係加速量化推理底層嗰層。
 圖片:Pronoia/CC0/Wikimedia Commons
模姐驗嚇貨
全部數字出自 NVIDIA 自家嘅測試同自家嘅 GPU。呢次唔係本站嘅實測,我哋冇獨立重跑、冇第三方數據可以對照;廠商自家 stack(晶片+推理框架+自家調優)度出嚟嘅「自家晶片跑自家最熟嘅負載」,跟住呢個定位讀就夠,唔好將佢當業界通用基準。另外呢篇教學本身冇提 BFL 對 FLUX 3 Image Klein 嘅權重開放、授權條款,我哋亦冇獨立核實過呢個模型嘅開放權重狀態;NVFP4 相對 BF16 嘅輸出品質差異,文中有對比圖,但冇量化嘅品質評估指標,只係視覺並排。
模姐|深度調教