長庚大學今年延伸「人人有 AI」專案,推出「AI Tutor」,主打「時間點感知」功能,配合全校覆蓋;為應付運算需求,資工系同資訊中心聯手麗台科技引入 16 部 NVIDIA DGX Spark,喺地端搭建 Blackwell 算力叢集。呢個係由通用 AI 帳號普及,走向「每一門課都有專屬跟課 AI 助教」嘅升級。
通用 AI 答非所問,點算?
校方指出,學生用通用型雲端 AI 問功課,經常遇到看似完整、但同老師上課內容完全對唔到嘅答案;通用 AI 唔識課程進度、用緊邊份教材,往往俾出超出課綱嘅回覆,反而拖慢學習。AI Tutor 嘅設計就係針對呢個落差。
唔係雲 API,係先消化成堆課
AI Tutor 並非單純呼叫公有雲通用大模型,而係將教師一整學期嘅課堂錄影、音訊逐字稿、簡報、講義同補充文獻完整吸收,做到「一門課、一個專屬助教」。
佢嘅核心賣點係「時間點感知(Time-aware Context)」:學生喺教學影片某一秒暫停,系統會自動抓取前後語境嘅逐字稿、同步檢索對應投影片頁數同教材章節,即時對齊再作答,唔使學生自己切視窗、翻講義、copy 文字。呢個同一般 RAG(檢索增強生成)只做文本關鍵詞搜尋唔同,因為佢多咗一層「錨定影音時間軸」嘅對齊。
三大難題:算力、併發、資料主權
資工系技術團隊指出三個核心挑戰:
- 海量多模態教材整合:一門課一學期可達數十小時錄影、龐大音訊檔、數百頁講義,要對齊「邊份講義對應邊段影音」,同時做語音轉文字、語意切分、跨模態關聯。
- 高峰併發同長上下文推理:期中考、期末考前或同步線上課,請求量會瞬間爆量;每一次暫停提問都牽涉長上下文(Long Context)比對、高維向量檢索(RAG)同 LLM 即時推理,冇足夠算力就會塞。
- 資料「出唔出校」嘅合規:教師多年教案、未公開講義、研究資料,同學生個人學習軌跡,皆屬高度敏感資產;依賴公有雲 API 有資安、版權同成本風險,校方因此決定地端私有化部署。
點解選 DGX Spark?
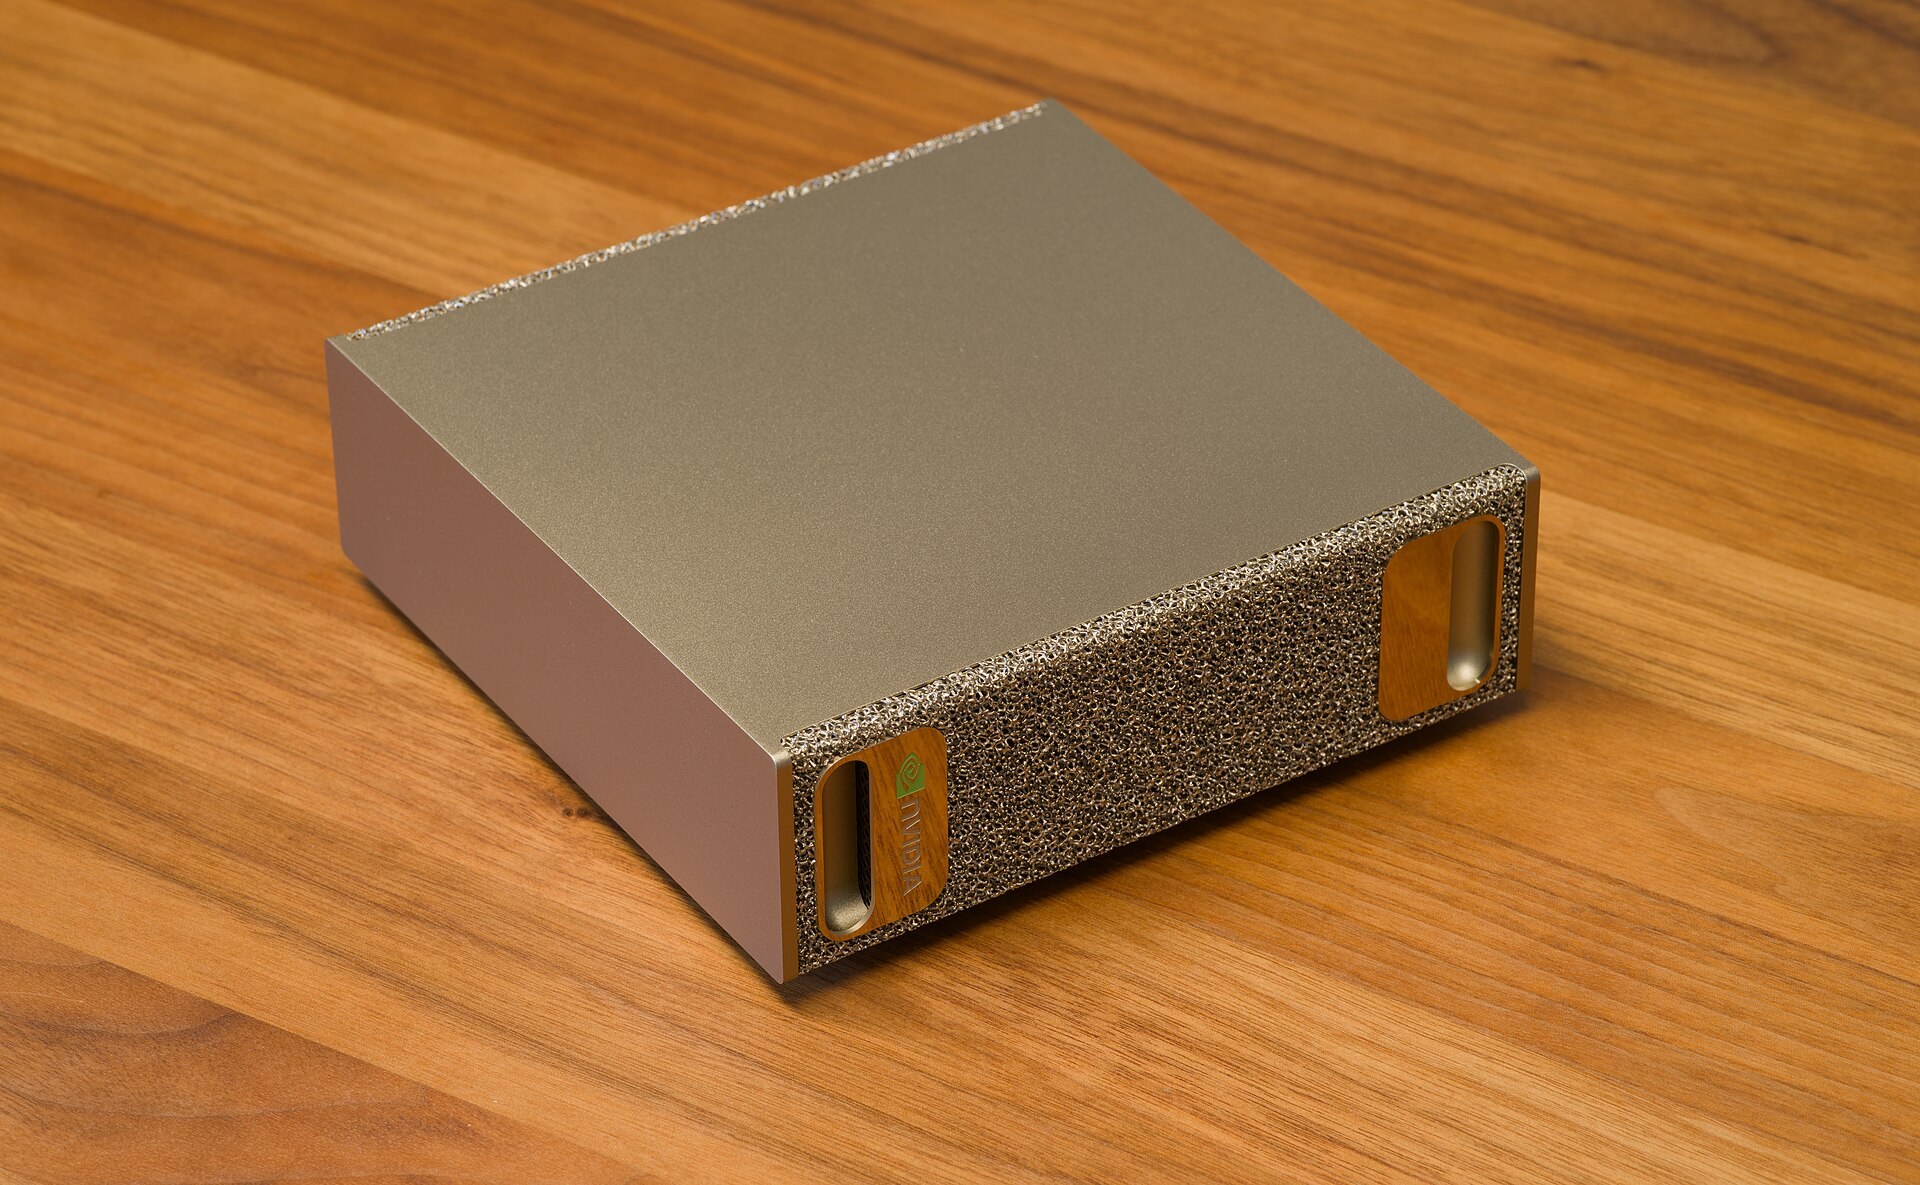
長庚大學資工系主任謝萬雲教授指出,NVIDIA DGX Spark 有幾個特點:
- 搭載 GB10 Grace Blackwell 超級晶片,AI 運算效能達 1 petaFLOP
- 單機 128 GB 統一記憶體(Unified Memory),可喺地端獨立運行高達 2,000 億(200B)參數嘅開源大模型
- 支援多節點高速串聯,按需擴充
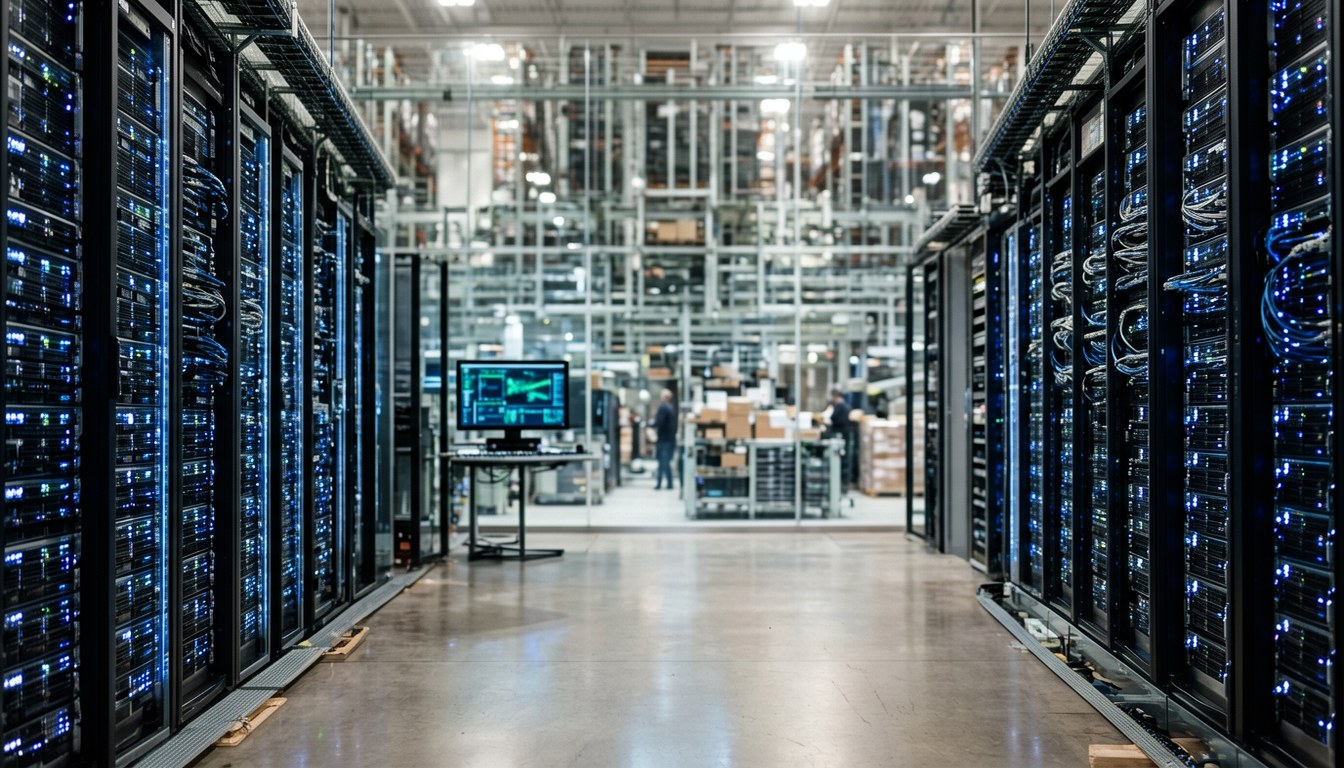
16 部 DGX Spark 組建核心叢集,專門處理高難度前處理同高階生成任務,再整合校內原有約百片 GPU,組成高、中、低階階層化算力池。
資工系碩二生游仁杰(參與雲地整合同 API 服務開發)提到,過去校內 GPU 規格有限,地端模型參數規模受限制;引入 DGX Spark 後,統一記憶體更充足,可實測嘅模型種類多元咗,方便揀出最切合系統需求嘅方案。
資工系碩一生吳松諭則分享多機串聯測試心得,指 2 至 4 台主機協同運算,可將龐大模型負載分散處理;佢稱全校學生喺課程影片任意時間點同時暫停提問,系統都能即時回饋。
學生實戰場
謝萬雲強調,AI Tutor 同時係資工系學生嘅實戰場:由功能推廣、瞭解用户需求,到系統開發、營運,全程參與。佢指系所除研究外,更重視實際開發經驗,配套已包括模型、API、容器化開發環境同 AI 工具鏈,目標係建設一個完整嘅 AI Development Playground。
模姐驗嚇貨
呢個案例最值得一睇嘅,唔係 16 部機器,而係「為何要地端」。教材智財、研究資料、學生學習軌跡——三樣嘢放喺公有雲 API 上,確實有真實風險;地端部署唔再受廠商計費同政策變化擺佈。呢個邏輯放喺任何機構都適用,唔止高校。
模姐|深度調教