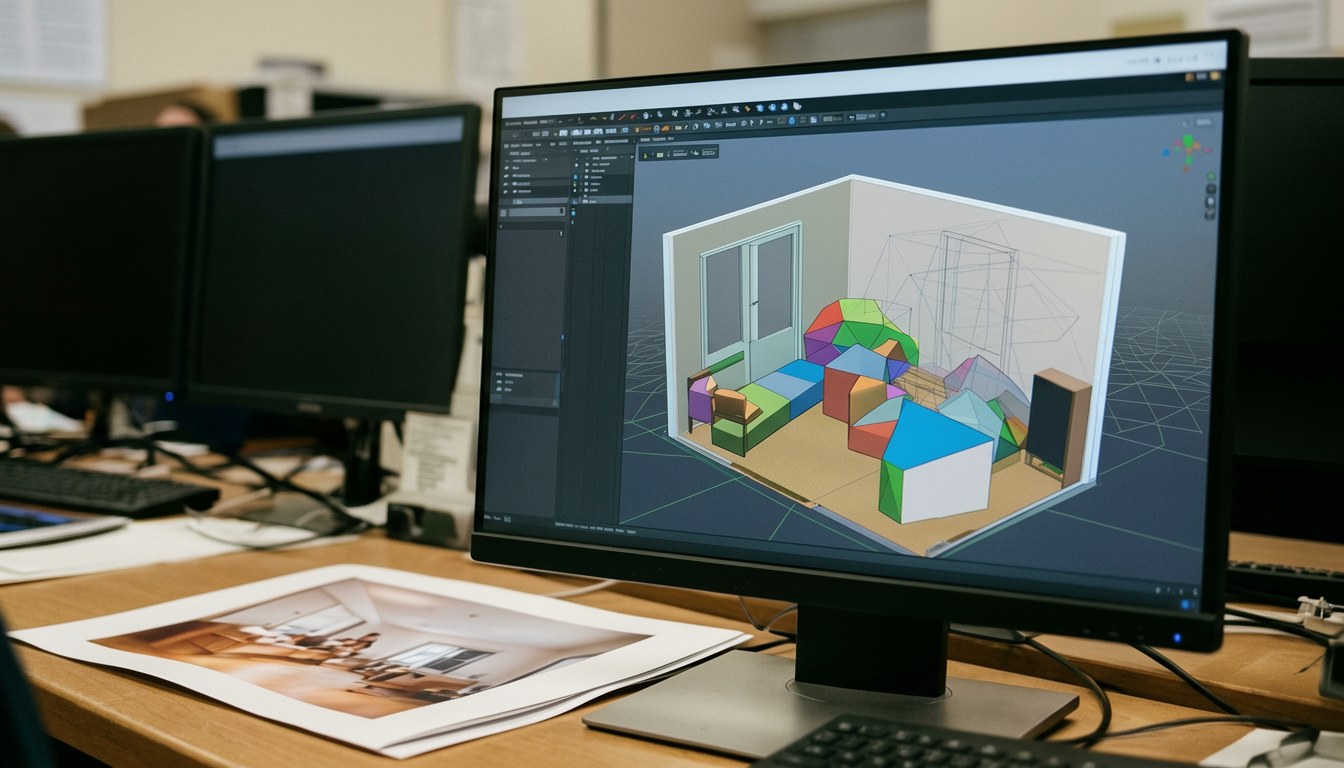
美國馬里蘭大學同 AWS 嘅研究員出咗個 LEGO-Anything 項目,思路係「Image-to-Code」:一個會寫代碼嘅 AI 編程代理(coding agent,即可以自主寫同執行程式嘅 AI)收到一張相,就為開源 3D 軟件 Blender 寫代碼,逐個物件砌出個場景。佢唔係一次過生成,而係反覆寫代碼、運行、睇結果、再改,直至跟住原圖為止。
呢個做法嘅賣點,係輸出係一套可執行嘅程序,唔係一張圖。物件、幾何、佈局同鏡頭位置全部寫得清清楚楚,你可以好似處理其他程式碼咁去運行、檢查、修改個場景。
研究團隊另設咗 LEGO-Bench 來量度代理表現,入面有 208 張相、來自 104 個室內同室外場景,用咗 443 個登記資產。佢哋解釋,真相冇精準 3D 答案可以對照,純粹合成圖又唔自然,所以佢哋用專業製作嘅模擬器場景去渲染測試相——入圖睇落自然,但精確幾何、深度同物件對應全部隱藏,做自動評分嘅「答案」用。
測試按三條軸線打分:validity 睇有冇交付到一個可用嘅場景;reconstruction 睇可見幾何準唔準;appearance 係重新渲染交回嘅場景,逐像素同原圖比對。
結果點?六個受測 GPT 配置幾乎次次都交付到可用嘅場景,但準確度落差好大:表現最好嘅 GPT-6 Astra 室內場景攞 53.4%,室外只有 39.6%;弱嘅配置大約 15%。場景越複雜準確度跌得越多,室外亦比室內難。研究員提高咗模型嘅推理預算(reasoning budget)之後,GPT-6 系列明顯進步,Astra 喺一個辦公室測試子集嘅分數由 32.3% 升至 61.8%。
最要緊嘅發現喺呢度:研究員分析咗代理嘅工作步驟,發現常見問題包括開頭做差、改動反嚟抹銷之前進度,同埋自我評估唔可靠。當模型要喺兩個版本入面揀邊個更符合原圖,佢哋嘅幾何判斷喺隨機水平附近甚至以下——代理基本上睇唔出自己嘅場景有冇越改越好。研究員結論:改得好唔好要靠具體量度,唔可以靠代理自己判斷。
基於呢個發現,作者建咗 LEGO-Plugin,一個唔需要額外訓練嘅擴充:佢將起始場景錨喺參考相上,用具體量度取代唔可靠嘅自我判斷,同時保護正確嘅進度唔被退步式改動抹銷。呢個插件令全部六個模型都有改善。
阿調搞兩下:AI 由一張相砌出可編輯嘅 3D 場景,聽落已經唔錯;但研究同時證明,個代理根本唔知道自己砌啱冇。想令佢做啱嘢,靠佢「自我感覺良好」係冇出路,最終都要靠人訂下嘅量度同錨點。你將一個工作流程交畀 AI 代理,監督同驗收標準一定要獨立於佢自己,唔可以畀佢自己批自己卷。
阿調|深度調教