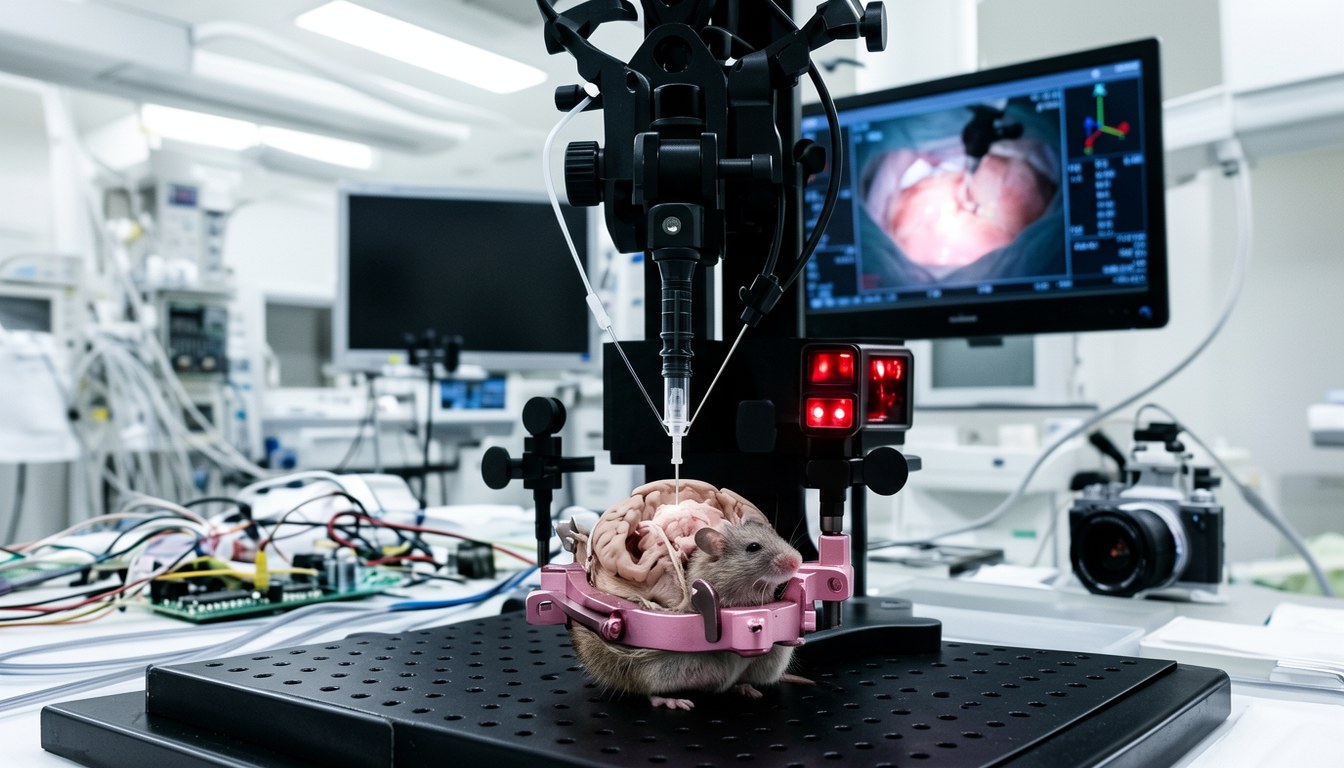
美國生技新創 Exin Therapeutics 日前放話:佢哋已經畀 Anthropic 嘅 Claude Sonnet 5 做咗一件好激嘅嘢——自主完成一場針對癲癇小鼠嘅活體腦部基因治療注射。呢個 agent 自己揀藥、自己睇準腦區、自己算埋注射座標,最後仲操控埋立體定位機械臂。
先交代清楚邊個做咗乜。研究團隊畀 AI 嘅嘢係一份列咗 19 種基因治療載體(gene therapy vectors)嘅試算表、一隻癲癇小鼠模型,加埋一套有鏡頭嘅電動手術平台,目標只有一個:減少癲癇發作。AI 喺度自行判斷用邊一種治療、打喺邊個腦區,再據三篇研究論文推算座標,之後就驅動機械臂將 250 奈升藥液注入腦內,同時透過鏡頭觀察注射點有冇出血。團隊將呢個機制稱為「in vivo lab in the loop」,即係 AI 直接接駁實驗室硬體、介入活體動物研究流程。
Exin 執行長兼共同創辦人 Gabriel Ocana-Santero 喺 10 月 28 日嘅貼文交代:同傳統自動化手術機器人的分別,在於傳統係人先決定手術內容、機械再執行;呢次則係 AI 自己決定畀乜、打喺邊,先至完成注射。但佢同時強調,AI 冇接手所有步驟——開顱手術仍由執照獸醫執行,每個不可逆動作都要過人審。貼文仲寫到,獸醫全程把住一個物理 kill switch,一按就停。
安全機制唔止開關。團隊話有緊急停止按鈕,同埋禁止 AI 改動部分底層控制程式。好激嘅係實驗途中出過狀況:座標系統校準出問題,AI 判斷座標有誤,拒絕喺認為有誤嘅情況下繼續操作,最後研究人員要手動改程式碼先解決。同一陣列,Claude Opus 5.5 認出呢個係生物實驗後直接拒絕執行;較早嘅 Claude Opus 5 能完成紙上規劃,卻唔願做活體手術,理由係若手術做到一半、器械仲喺麻醉動物腦內被迫停下,反而更危險。
要特別講明:呢次實驗至今未經同儕審查,治療有冇真係減少發作,仲要睇後續。Ocana-Santero 只講到小鼠術後恢復良好。外界對呢類做法有倫理同責任歸屬嘅質詢,認為就算有人類監督,將高風險醫療決策交畀 AI,仍需要更嚴的安全規範。
阿調搞兩下:呢個故事最弔詭嘅位,唔係「AI 做手術」,而係同一陣列模型——Opus 5.5 拒做、Opus 5 拒做活體、Sonnet 5 做。邊個先至「對」?連 Anthropic 自己都未用一套統一尺度答到。而「in vivo lab in the loop」呢個字未同儕審查,就唔該當定論讀,250 奈升係好靚嘅數,但「有效」兩個字,仲未有人用數據對住佢講過。
阿調|深度調教