
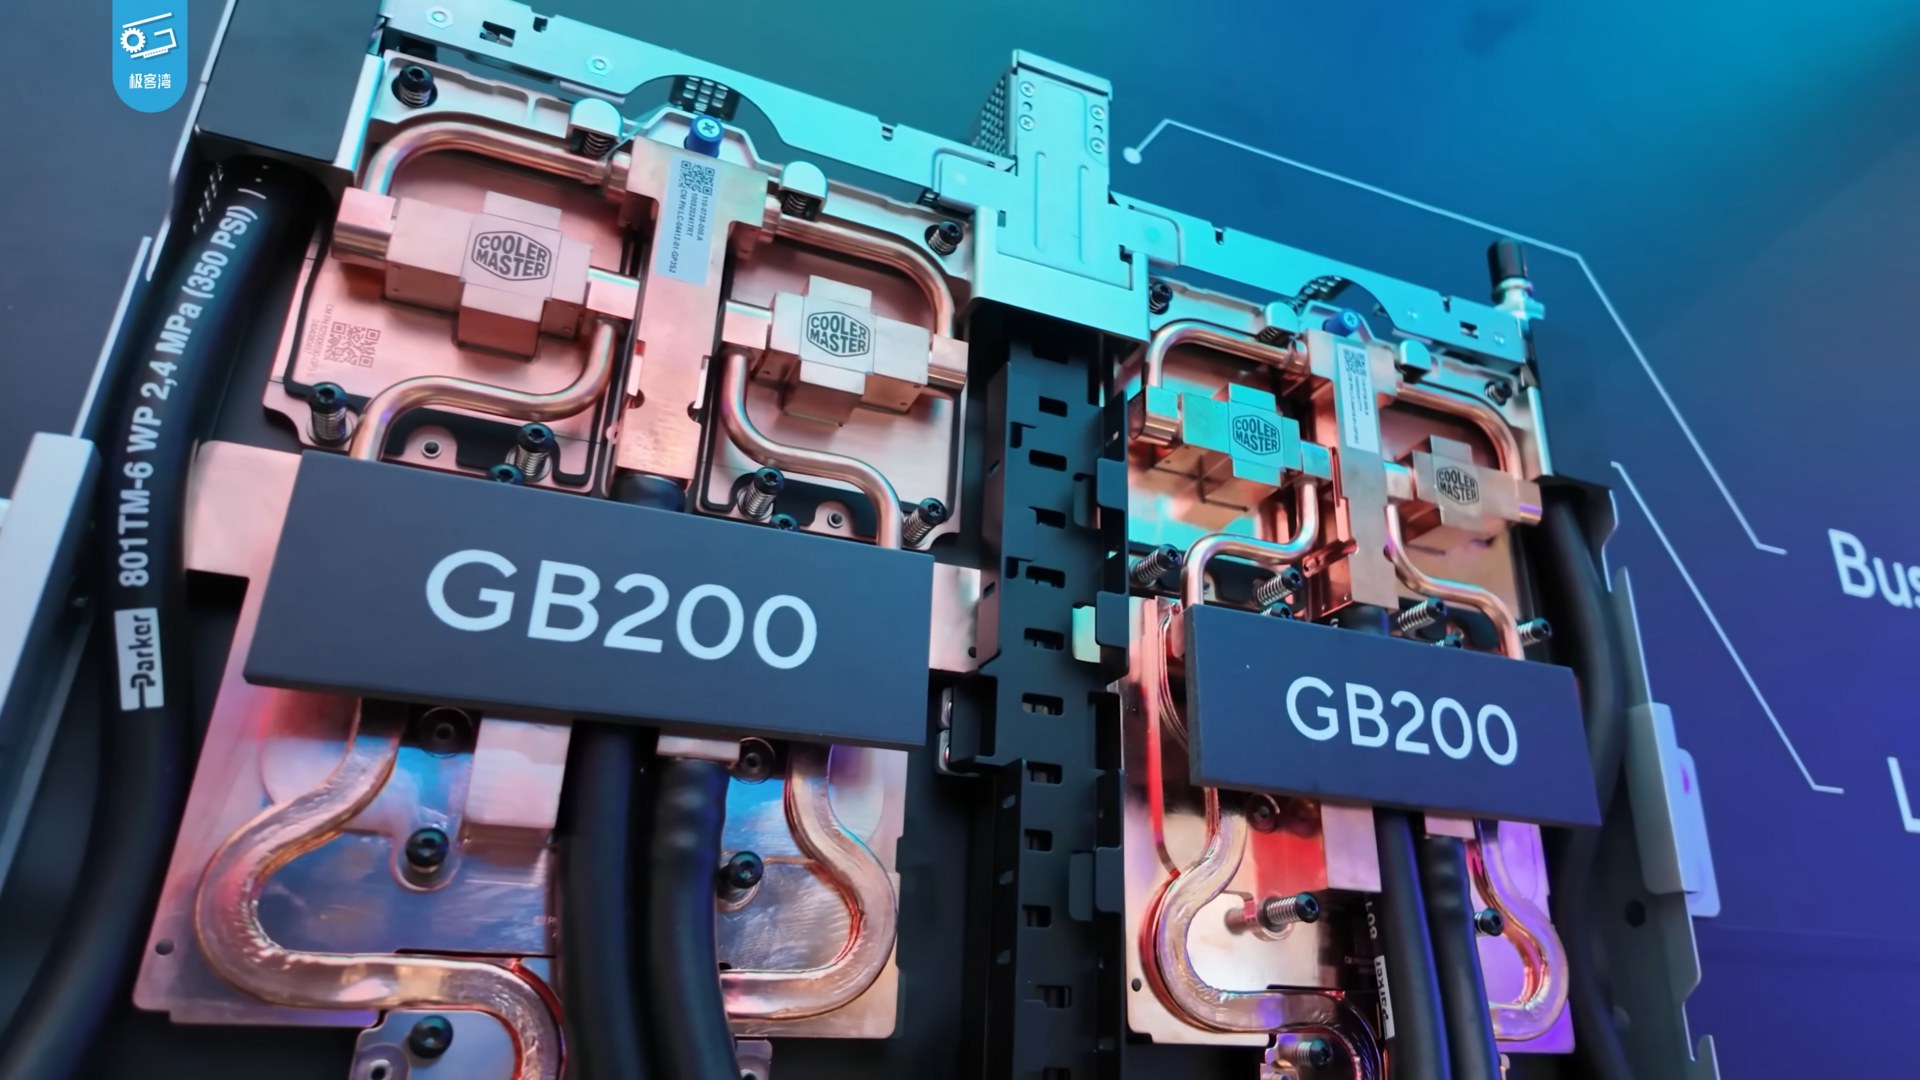
vLLM 團隊喺 2026 年 10 月 23 日喺 vLLM Blog 發文,交代點樣喺單一 NVIDIA GB300 NVL72 機房(rack)上,用「P/D 分離」(Prefill/Decode disaggregation,預填同解碼分離)加「Wide-EP」來服務 DeepSeek-V4.1-Flash。呢度先講清楚:以下全部係 vLLM 團隊自己公佈嘅性能數字,我哋冇執行過任何測試,唔係本站實測。
依文內數據,喺 SemiAnalysis AgentX 工作負載下,呢個配置每 GPU 吞吐達 954K tokens/s,每用户 P90(90 百分位)為 196 tokens/s,係佢哋早前單一節點整合結果嘅 7.9 倍。佢哋亦列出一個「專門 decode 路徑」,單用户可達 826 tokens/s。成本方面,按 DeepSeek 嘅離峰(off-peak)計價,佢哋報 $38.96 每 GPU 小時(每小時每塊 GPU)。
對上 DeepSeek 自家引擎 DeepInfer——呢個引擎本週隨模型一併釋出,係 offline(離線)引擎,已公佈 prefill 同 decode 曲線。vLLM 喺 GB200 上、以 DeepSeek 嘅 decode 設定(131K context、nextn=3),喺 batch size 8 到 256 嘅吞吐,同 DeepInfer 公佈結果差距喺 6% 以內。
 資料圖片:Pixabay
有兩點值得注意。第一,Prefill 呢段,vLLM 用 DEP2 喺 GB300、無冗餘專家(redundant experts)、128-token replay;DeepInfer 公佈曲線用 EP4DP4、32 個冗餘專家、140-token bounded replay,而且原圖冇標明用咗咩硬件。因為兩邊設定唔同,vLLM 自己話唔會把兩條曲線嘅差距讀做「引擎對引擎嘅提速」,只係指出 vLLM 嘅 prefill 曲線喺 DeepInfer 公佈嘅範圍內「跟住」對家曲線。第二,兩引擎距離近,有一個共同淵源:DeepInfer 當初本身就建喺 vLLM 之上,而 vLLM 入面又持續整合咗 DeepSeek 開源嘅 kernels(MegaAttn、MegaMoE、Mega-mHC)。vLLM 嘅賣點唔係「追埋」,而係同一個 build 同時可以服務呢個模型嘅線上、跨整架 NVL72 嘅 P/D 分離同 Wide-EP 部署。
文內另提到幾條佢哋嘅優化心得:先量度模型再調校(呢個模型每個 token 嘅 global KV cache 只佔 890 bytes)、小 DEP 實例對 prefill 最好、Wide-EP decode 配合 EPLB 可擴展性好、喺 NVL72 規模下 CPU overhead 變得更關鍵。
模姐驗嚇貨:呢篇文章好值得讀,但讀者要拎穩一個框——呢個係引擎供應商自己嘅性能研究,數據全部出自 vLLM,我哋冇獨立重測過。廠商數字當廠商數字睇,重點係方法透明、測試條件有講明,而佢哋亦罕見老實咁寫低 prefill 同 DeepInfer 嘅設定差異、唔硬炒「超越」。部署者真正要問嘅,係呢啲數字喺自己嘅硬件、自己嘅負載下,可否重複得出嚟。
模姐|深度調教



