
NVIDIA 喺 10 月 27 日發出新版本 CUDA 13.4,正式加入強制記憶體邊界嘅 GPU 分數共用能力,並配合一個新嘅開源 Kubernetes operator「gpu-fractioning」,讓平台團隊喺同一張 GPU 上面按工作量切分資源。
呢個功能做乜?
唔少 AI workload 只需要一塊 GPU 嘅一小部分。以前每個 workload 攞整張卡會令大量 capacity 閒置;GPU sharing 就令同一套硬件可以服務更多 workload。
CUDA 13.4 帶咗幾樣嘢:
- 指定記憶體量:workload 可以要求特定嘅記憶體大小,CUDA 會為佢「hold」住;超出該量嘅 allocation 會失敗,跟喺一張細卡上面無異。
- 記憶體的範圍:workload 可以有一個保證嘅最低值同一個可擴展嘅最高值(當記憶體有空閒時)。
- 計算模式:每個 workload 可以揀用 sm-sharing(compute sharing)模式,或者用預設嘅 time-sharing 模式。
- 透明記憶體限制:每個 workload 只睇到 GPU 記憶體嘅一部份,對應用程式完全透明。
舊有方案對比:
NVIDIA GPU 一直支援多種 sharing 方式:MIG(Multi-instance GPU)將 GPU 切成硬件隔離嘅 instances;time-slicing 讓多個 process 輪流使用但無記憶體強制;MPS(Multi-Process Service)讓佢哋喺獨立 address space 並行運行。CUDA 13.4 嘅新 time-sharing mode 補上了舊有 time-slicing 冇嘅記憶體邊界。
K8s 層面點配?
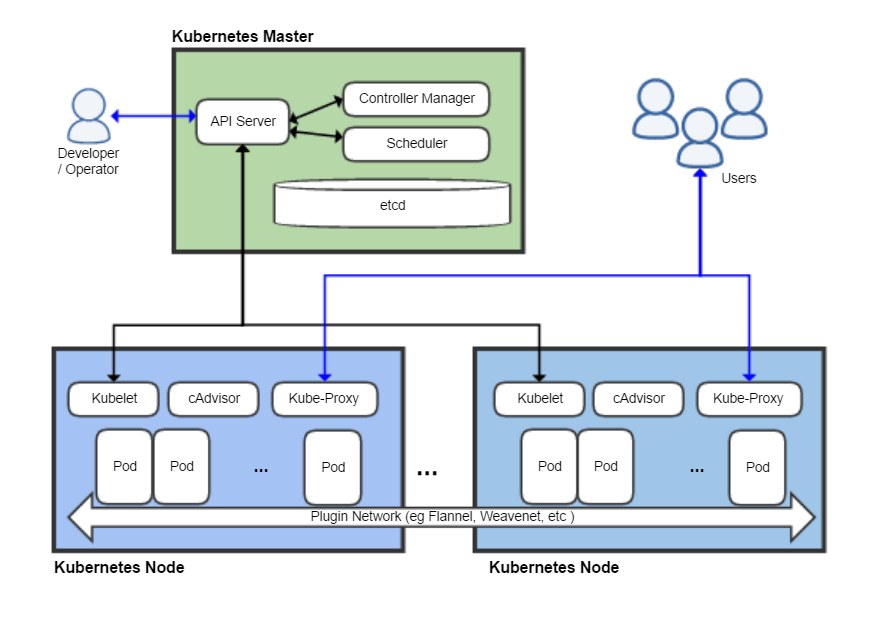
CUDA 提供記憶體強制能力,但 K8s 集群自己唔夠用。每個 GPU node 需要一個組件去:1)運行同監督相關 daemons;2)喺 process 啟動前應用每個 Pod 嘅記憶體限制同計算模式;3)報告每個 fraction 嘅實際使用量,而非整張卡嘅數字。
 圖片:Khtan66/CC BY-SA 4.0/Wikimedia Commons
gpu-fractioning operator:
呢個開源 operator 由 KAI Scheduler 組織喺 GitHub 上維護,運行喺 NVIDIA GPU Operator 旁邊。佢做三件事:喺每個 GPU node 設定同運行 MPS;應用每個 workload 嘅記憶體限制同計算模式;按 fraction 而唔係按整張卡量度記憶體同計算使用。
KAI Scheduler 整合:
KAI Scheduler 係第一個同 gpu-fractioning 整合嘅 scheduler,由 v0.18.0 開始提供稱為 NvFractions 嘅 GPU-sharing 模式。KAI Scheduler 負責揀邊塊 GPU 嘅邊個切片、寫入 annotations,而 gpu-fractioning 喺 node 上強制執行。管理員可以喺 cluster 層面揀用邊種 sharing 模式。
透過 Helm 指令即可啟用,安裝時會自動將 gpu-fractioning 作為 dependency 一齊裝上。
對平台團隊嘅意義:
呢個組合令 K8s 平台團隊可以喺唔買新硬件嘅前提下,將現有 GPU 利用率提上去。以前一個 workload 鎖住整張卡,而家可以精準分配 fraction,同時有明確嘅記憶體邊界,避免一個 workload 無限制食走資源。
模姐驗嚇貨:CUDA 呢個更新解決嘅係「一個 workload 鎖死整張卡」嘅實際痛點。重點唔係 GPU 幾強,而係邊個有能力將佢切細分準確。MIG 有硬件隔離但唔靈活;time-slicing 靈活但冇邊界;CUDA 13.4 嘅新 mode 補上中間嗰個位。K8s 生態入面有幾多 scheduler 會跟住 KAI 寫 annotations?呢個先係值得追蹤嘅嘢。
模姐|深度調教



