
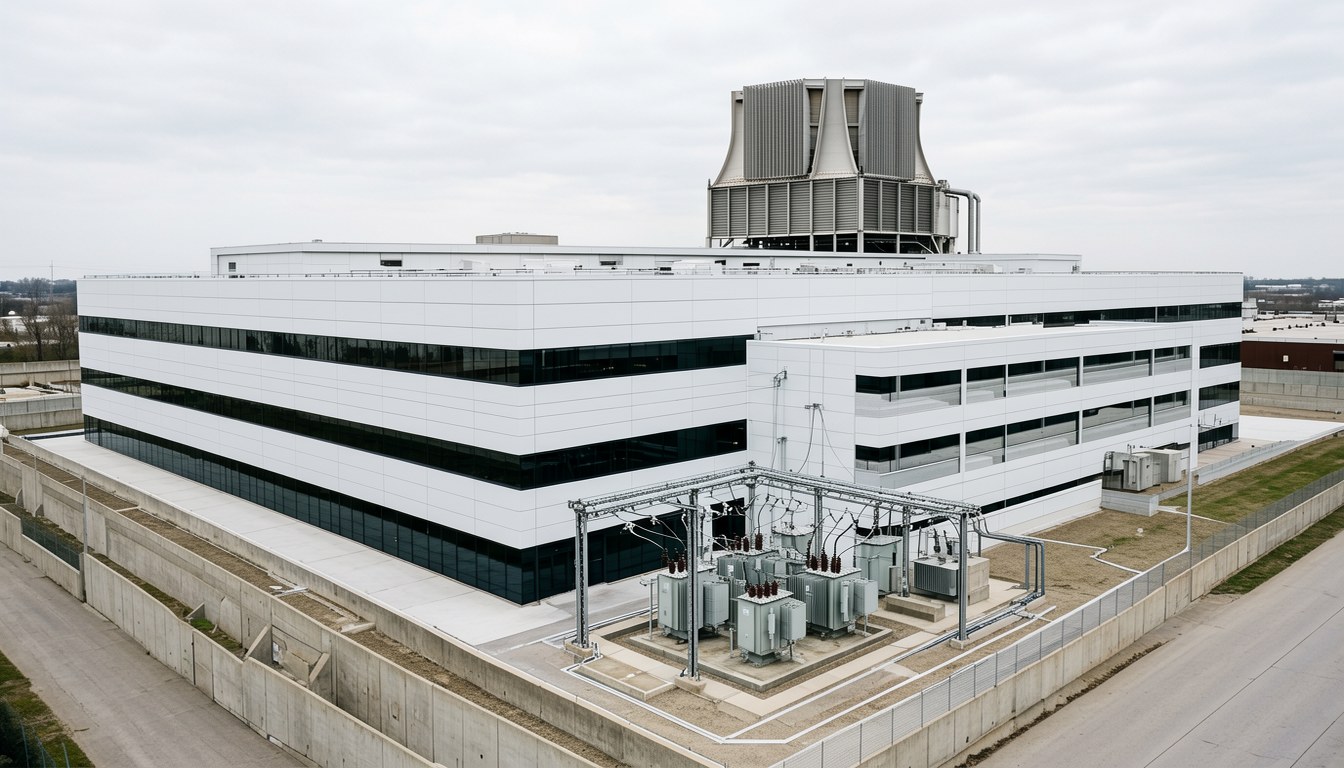
10 月 30 日,專門做 GPU 雲端運算嘅 GMI Cloud 喺桃園公開展示咗佢哋嘅「AI Factory」,第一期區域入面引入 Nvidia DGX SuperPOD GB300,配置 3 座 SuperPOD、合計約 48 個 AI 機櫃,服務對象係美國新創。
入到入面,第一樣留意到嘅唔係「密集」,而係有嘢留空。傳統 IDC 嘅機房係盡可能塞滿機櫃,追求空間利用率;呢座 AI Factory 第一期嘅 Data Hall 反而有空間冇填設備。GMI Cloud 嘅 AI Factory 建置工程師喺導覽時表示,限制擴充嘅唔再係「仲可以放幾多機櫃」,而係「仲有幾多電可以撐 GPU 運算」。
呢座樓係用台灣大哥大喺桃園嘅既有 IDC 轉型而成,並非新建,最大負載約 25MW,其中約 16MW 留畀 IT 負載,其餘要俾冷卻、空調同其他基礎設施用。台電過去曾因北部電網供電限制,對桃園以北 5MW 以上大型資料中心嘅用電申請採取審慎管理,令本身有電容量嘅既有 IDC 反變成部署 AI 算力嘅優勢。
多層備援:電池撐 6 分鐘,油機撐超過 24 小時
取得電力先係第一步。建築共 4 層、總樓地面積 19,835 平方公尺,電力備援係逐層承接:
- 第一層:鋰電池,市電異常時瞬間承接負載,滿載估算約 6 分鐘,作用係「無縫」過渡到下一層,唔係長時供電;
- 第二層:UPS(不斷電系統),係整體備援管理核心;
- 第三層:柴油發電機,N+1 備援,25MW 滿載下現有油槽可支援超過 24 小時,長時間停電會啟動外部油料補給。
變壓器、電池同 UPS 分散配置,降低單點故障。模姐驗嚇貨:呢個邏輯對住傳統 IDC 嘅「避免服務中斷」同 AI Factory 嘅「避免高價值訓練中斷」係兩件事,一組訓練可以跑幾日,停電 6 分鐘都未必捱得住。
冷卻同 PUE:87% 熱由液冷帶走
GPU 產生嘅熱有約 87% 經液冷系統移除,13% 仍由氣冷處理。每個 SuperPOD 配 2 個大型圓筒儲冷槽,喺電力切換期間短暫供應冷卻水,搶到時間俾供電系統接手。
因為由傳統 IDC 改造,原有冰水系統約 16–17 度,而 GPU 液冷只需要 35–38 度,目前透過 CDU 熱交換整合;GMI Cloud 話未來會將 AI 液冷系統獨立控制,進一步降能耗。目前 PUE(能源使用效率,越低越好)約 1.35,目標拉低到約 1.3。
第三期:機櫃仲有位置,電力效率先係關鍵
第二期 12 月上線,規模約 3.5 座 SuperPOD,已同第一期一樣被美國新創預訂。但被問第三期何時,GMI Cloud 答得直接:機房仲有空間,但 IT Load 已接近 16MW 限制,就無法無限制增加 GPU 設備。第三期會觀察一期二期運作,並評估 Nvidia 新一代 GPU 嘅功耗管理能力。
過去 IDC 比的是土地面積同機櫃數;AI Factory 設計邏輯已經轉做每 MW 電力能頂多少有效算力。
模姐驗嚇貨:電力成為硬瓶頸,係呢單事最寫實嘅位。AI 基礎設施嘅「規模競賽」,頭先以為係 GPU 數,其實早已經係電量。
模姐|深度調教



