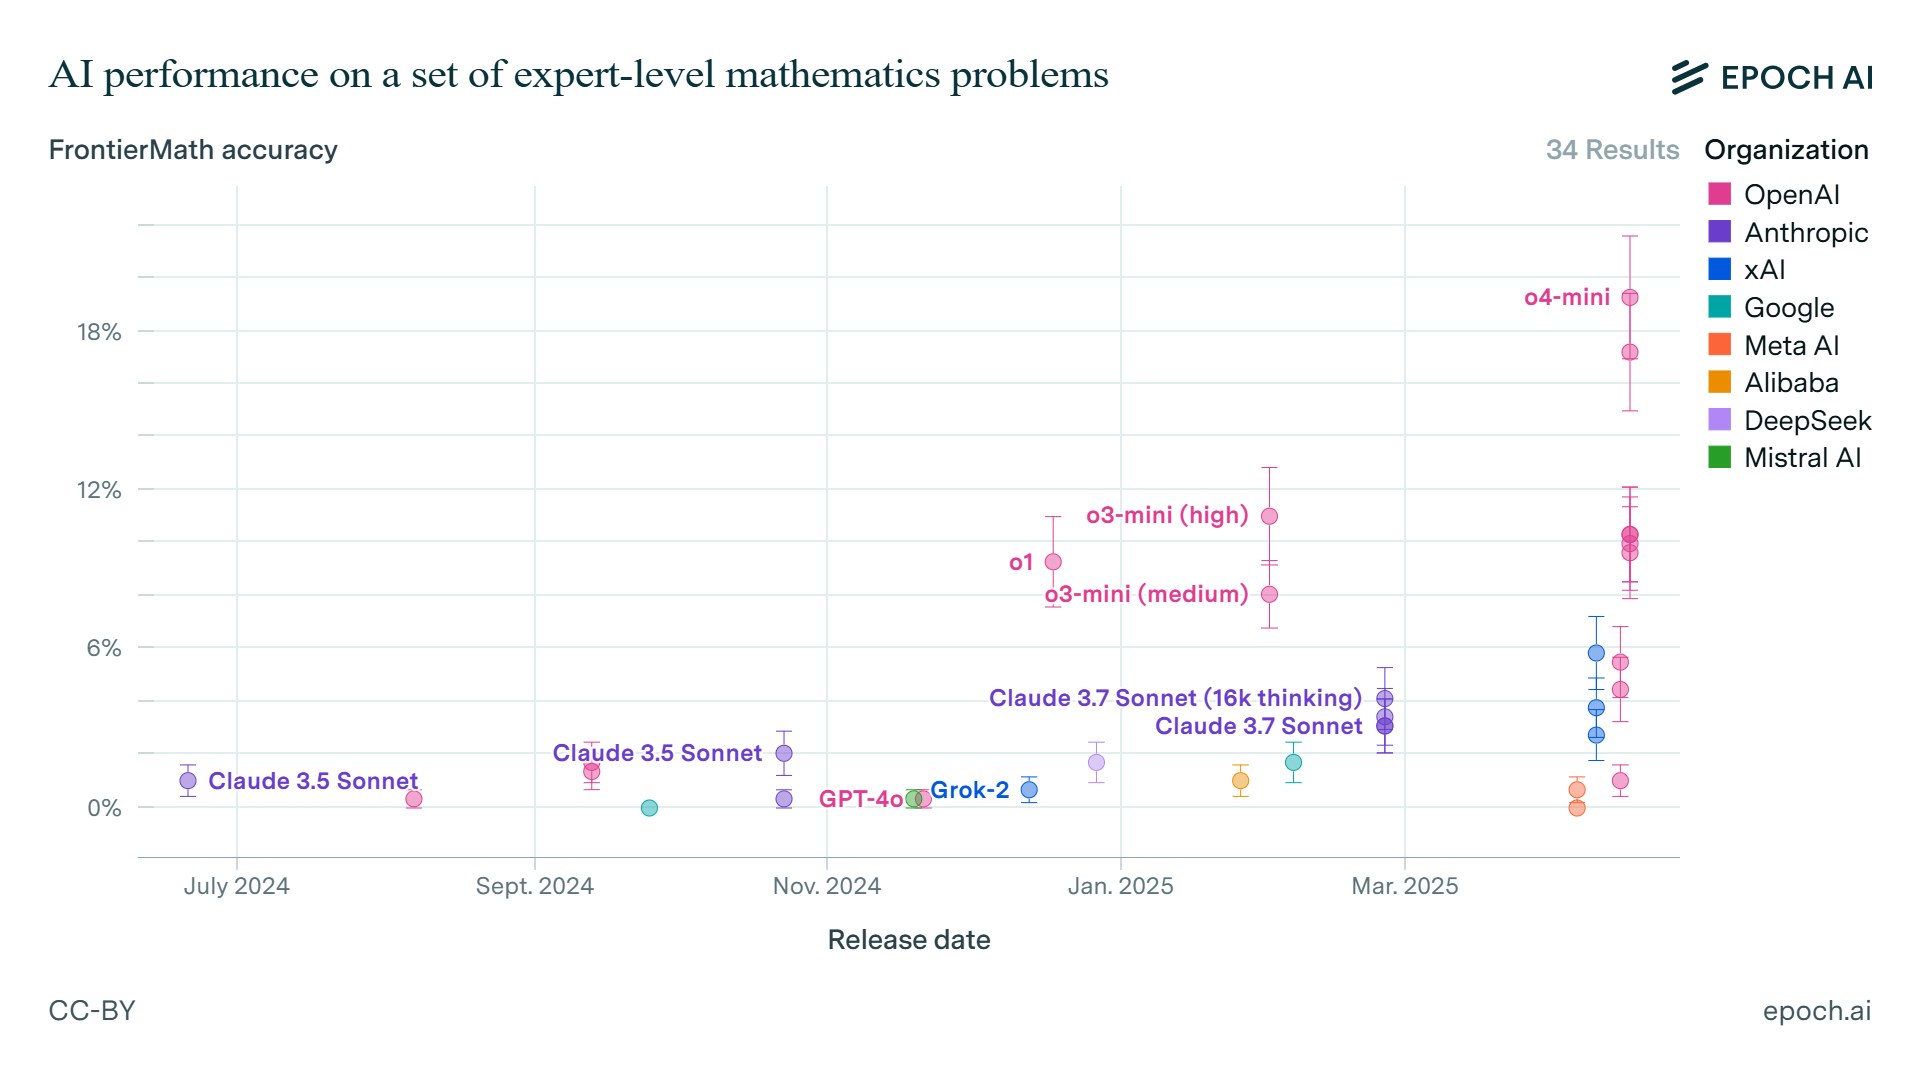
美國獨立評測機構 Epoch AI 今個星期(2026 年 10 月 23 日)喺佢哋嘅 The Epoch Brief 刊出咗幾項新研究,核心問一個大家最鍾意問嘅問題:AI 幾時可以自己做我哋嘅工?
Epoch 自己的研究員試咗嚇
Epoch 嘅研究員 Kelly Hong 同評測主管 Greg Burnham 做咗個測試《Can AI automate Epoch?》,畀六個領先模型完成 11 項取自 Epoch 日常工作嘅真實任務,涵蓋五個範疇:圖形設計、撰寫短篇研究報告、製作互動數據工具、AI 數據中心研究、研究設計。每個模型得到嘅背景資訊等同一個新入職員工,有自己嘅工作空間同 Google 帳户,每項任務只做一次,冇人幫手。
結果點?Claude Fable 5.1 同 GPT-6 Astra 打和排頭,但冇任何一個模型能夠穩定達到 Epoch 對工作嘅質量標準。前鋒封閉權重模型喺定義清晰嘅任務(例如編程同數據分析)表現最好,但喺需要廣泛判斷嘅開放式任務(例如設計有價值嘅實驗、解讀結果)就唔夠。開放權重模型連定義清晰嘅任務都有困難。研究員嘅原話:目前模型「尚不能取代員工,至少喺 Epoch 係咁。」
Slay the Spire:六個月由打唔贏變 98% 勝率
Epoch 新出嘅基準測試 SpireClimb,用 deck-building 策略遊戲 Slay the Spire 測試 AI 處理長而複雜任務嘅能力。模型要處理龐大決策樹、喺螢幕上面揀啱嘢、長時間無輔助咁玩。
研究員 Benjamin Ou 同 Simon Chen 發現,只係六個月,前鋒模型就由完全打唔贏,變成喺基礎難度贏過 90% 嘅對局。GPT-6 Astra 喺基礎難度勝率 98%。喺最困難難度,GPT-6.1 Sol 贏 20%,Astra 贏 17%,其餘模型幾乎冇贏過。
不過 Epoch 亦註明,Slay the Spire 出咗近十年,模型對呢款遊戲有相當認識,呢個可能影響測試結果——即係話,呢個跑分反映嘅唔單止係通用推理能力,仲有遊戲本身嘅知識。
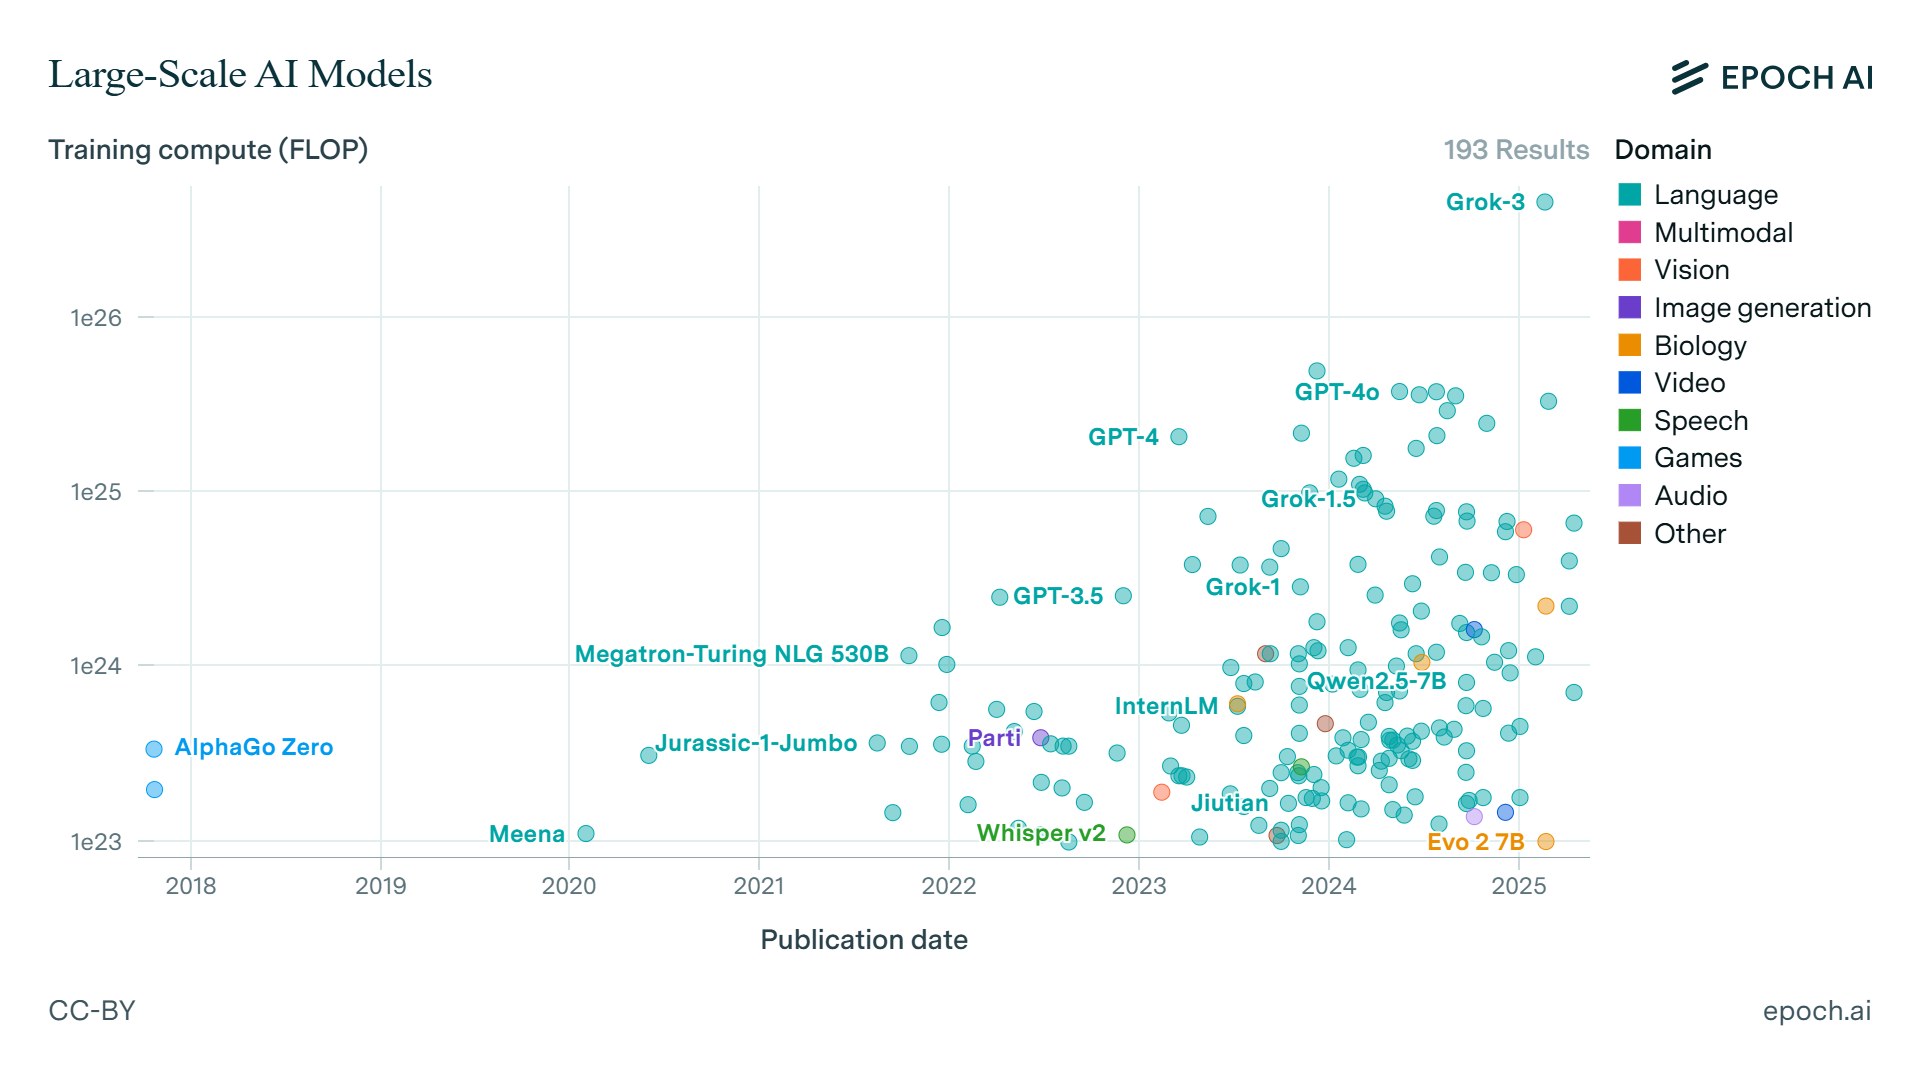 圖片:Epoch AI/CC BY 4.0/Wikimedia Commons
Gemini 追近前鋒,開放權重網絡安全落後
Epoch Capabilities Index(能力指數)最新數據:Gemini 4 Argon 得 166 分,同 Anthropic 嘅 Claude Fable 5.1 打和,係自二月以嚟 Gemini 最接近前鋒嘅記錄。頂位由 Claude Opus 5.5 同 OpenAI 嘅 GPT-6 Astra 佔據。
另外,Epoch 指今日最勁嘅開放權重模型喺網絡安全嘅分數,大約同 6-7 個月前嘅頂級封閉權重模型相同。
Epoch 本期亦審查咗四個新基準測試,評級一個為 Verified(已驗證),三個為 Flawed(有缺陷),另有四個資料不足無法評級。
模姐驗嚇貨
六個模型、11 項任務、每次只做一次、冇人幫手——測試條件講得清楚,呢個唔係廠商自己跑自己嘅嘢。但要注意:Epoch 評測嘅係「Epoch 嘅工作」,即係一個特定獨立研究機構嘅工作流程,唔代表所有知識型崗位。研究員話「至少喺 Epoch」,呢個「至少」好重要——即係佢哋冇 claim 講其他機構都係咁。
SpireClimb 嘅 98% 勝率聽落好勁,但 Epoch 自己提咗遊戲知識嘅影響。一個 90% 勝率喺一款有海量公開攻略同討論嘅遊戲,同喺一個全新場景做決策,係兩回事。呢個評測反映長程規劃能力,但唔等於通用智能。
開放權重模型喺網絡安全落後 6-7 個月,呢個數據值得留意但亦要問:用邊個基準測?Epoch 自己評級咗三個新基準為「有缺陷」,邊個指數可信、邊個有問題,讀者自己要分清楚。
模姐|深度調教